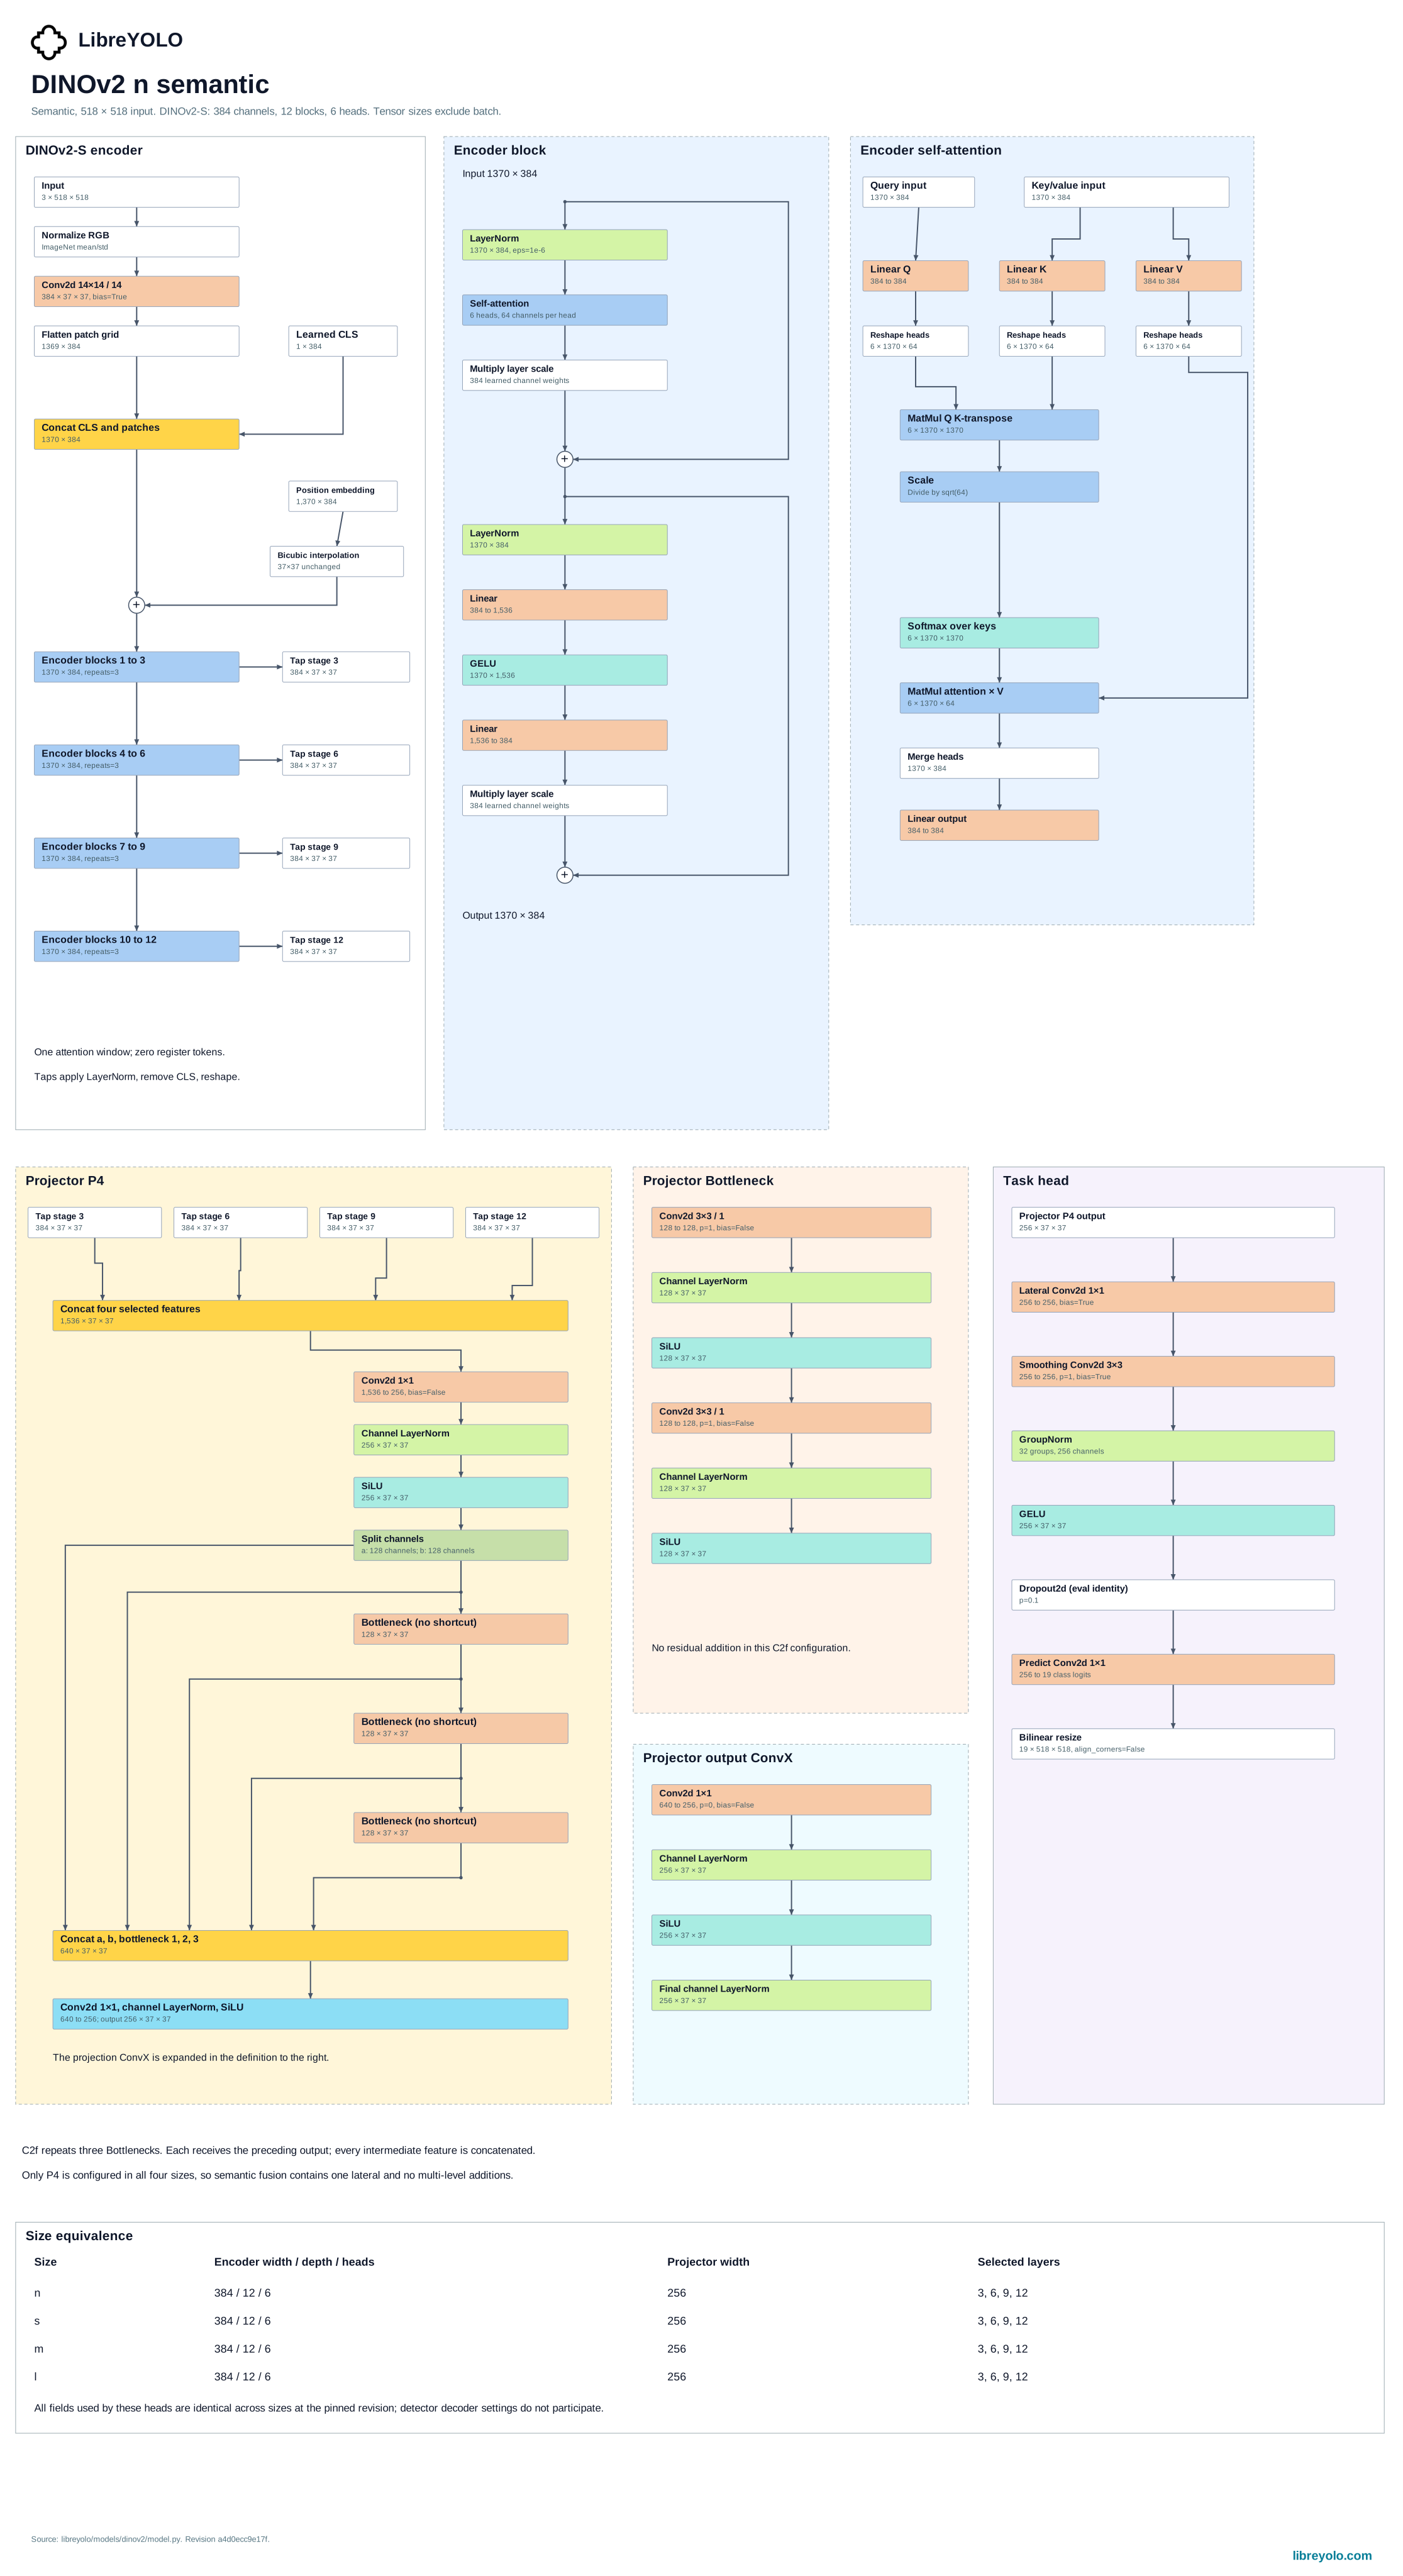
DINOv2
O DINOv2 é um vision transformer auto-supervisionado treinado pela Meta AI para produzir features de imagem de uso geral sem rótulos. O LibreYOLO empacota seu backbone DINOv2-with-Registers para três tarefas: segmentação semântica, classificação e embedding de imagem inteira.
- Tarefas
- semantic segmentation, classification, embeddings
- Tamanhos
- n, s, m, l at 518 px
- Instalação
pip install "libreyolo[rfdetr]"- Nível de suporte
- Compatível, desde a v1.3.0. Modelos treináveis complementares: mantidos verdes na CI, com recursos incorporados quando há oportunidade.
- Origem
- DINOv2 por Meta AI (FAIR), Apache-2.0. Artigo, código-fonte
- Licenças
- Código MIT, pesos Apache-2.0. Uso comercial
Instalação
O LibreDINOv2 só é registrado quando transformers está instalado, a mesma
dependência opcional que o RF-DETR precisa para seu backbone DINOv2, então ele
precisa do mesmo extra.
pip install "libreyolo[rfdetr]"Predição
O LibreYOLO não publica um checkpoint LibreDINOv2. Construa o wrapper
diretamente em vez de carregar um arquivo: model_path=None (o padrão) baixa
o backbone Apache-2.0 facebook/dinov2-with-registers-small da Meta no
Hugging Face no primeiro uso. task= seleciona o que roda em cima dele.
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Não existe checkpoint hospedado pelo LibreYOLO para esta família:# isto baixa o backbone Apache-2.0 DINOv2-with-Registers-small da org# da Meta no Hugging Face. A cabeça densa começa com inicialização# aleatória até você treiná-la (veja Treinamento abaixo).model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= é a contagem de classes do seu dataset; a cabeça linear# começa com inicialização aleatória até você treiná-la.model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Ignora todas as cabeças de tarefa: o backbone sozinho já basta,# então isso não precisa de fine-tuning para ser útil.model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D), normalizado por L2from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # Wrapper de conveniência: roda predict() e empilha cada linha em um# único tensor (N, D).features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" e task="classify" adicionam uma cabeça densa ou linear em
cima do backbone; essa cabeça é inicializada aleatoriamente e só é útil depois
que você a treina (veja Treinamento). task="embed" pula todas as
cabeças e devolve o token CLS final normalizado do backbone como uma única
linha por imagem inteira em result.embeddings, então não precisa de
treinamento nenhum. result.boxes é sempre None: nenhuma das três tarefas
produz detecções por instância. Veja predição para fontes,
streaming e tratamento de resultados.
Variantes
size seleciona a largura do projetor no estilo RF-DETR sobreposto ao
backbone, não o backbone em si: todos os tamanhos compartilham o mesmo encoder
DINOv2-S (small). A segmentação semântica roda na grade quadrada nativa de
patches do DINOv2; a classificação e o embedding rodam na resolução de
classificação menor usada para treinar o linear probe.
Treinamento
task="semantic" e task="classify" treinam; task="embed" não tem cabeça
dependente de classes para ajustar e levanta NotImplementedError se você
chamar train() nele.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)Os argumentos nomeados principais aqui são batch_size e lr, não batch e lr0 usados pela maioria das outras famílias; batch e lr0 ainda são aceitos e mapeados para eles, mas passar ambos gera um erro de conflito. output_dir= (padrão None) substitui project=/name= como forma principal de definir o local de uma execução, embora passar project=/name= diretamente ainda funcione. Veja treinamento para datasets, data augmentation, multi-GPU e loggers.
Novas execuções usam um runs/train/dinov2_exp incrementado com exist_ok=False. resume=True restaura o estado do trainer e preserva o diretório de execução selecionado. Classificação suporta cls_pw e class_weights, conforme descrito em hiperparâmetros.
Validação
val() devolve um dicionário de chaves metrics/: mIoU e acurácia por pixel
para task="semantic", acurácia top-1 e top-5 para task="classify".
task="embed" não tem ground truth contra o qual pontuar e levanta
NotImplementedError se você chamar val() nele.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])A calibração de classificação e embeddings reutiliza o pipeline de classificação do modelo. A avaliação usa a transformação da família.
Exportação
| Tarefa | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX: compatível | Semantic segmentation to TorchScript: compatível | Semantic segmentation to ExecuTorch: compatível | Semantic segmentation to TensorRT: compatível | Semantic segmentation to OpenVINO: compatível | Semantic segmentation to Paddle: incompatível | Semantic segmentation to MNN: incompatível | Semantic segmentation to RKNN: incompatível | Semantic segmentation to ncnn: incompatível | Semantic segmentation to TFLite: incompatível | Semantic segmentation to CoreML: incompatível | Semantic segmentation to Core AI: incompatível |
| Classification | Classification to ONNX: compatível | Classification to TorchScript: compatível | Classification to ExecuTorch: compatível | Classification to TensorRT: compatível | Classification to OpenVINO: compatível | Classification to Paddle: incompatível | Classification to MNN: incompatível | Classification to RKNN: incompatível | Classification to ncnn: incompatível | Classification to TFLite: incompatível | Classification to CoreML: incompatível | Classification to Core AI: compatível |
| Embeddings | Embeddings to ONNX: compatível | Embeddings to TorchScript: compatível | Embeddings to ExecuTorch: compatível | Embeddings to TensorRT: compatível | Embeddings to OpenVINO: compatível | Embeddings to Paddle: incompatível | Embeddings to MNN: incompatível | Embeddings to RKNN: incompatível | Embeddings to ncnn: incompatível | Embeddings to TFLite: compatível | Embeddings to CoreML: incompatível | Embeddings to Core AI: incompatível |
Cada tarefa suporta um subconjunto diferente de formatos, mostrado acima. Um
artefato exportado é recarregado por LibreYOLO() pelo sufixo do arquivo, então
um arquivo .onnx ou .engine se comporta como um checkpoint e devolve o
mesmo Results. Exportação lista os argumentos que cada
formato aceita.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # A factory roteia pelo sufixo do arquivo, então um artefato exportado# carrega como qualquer checkpoint e devolve o mesmo objeto Results. A# exportação nomeia o arquivo pela tarefa, aqui LibreDINOv2s-sem.onnx.model = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)Licenciamento
Confira a licença no repositório do Hugging Face correspondente aos pesos que você baixar. Cada checkpoint na organização LibreYOLO tem uma licença, e ela nem sempre é a mesma em toda a família. Esse repositório é a fonte oficial. O resumo abaixo descreve o que se aplicava na última verificação desta página.
Esta é uma descrição das licenças envolvidas, não uma orientação jurídica. Se a resposta tiver importância comercial, leia as licenças e procure sua própria assessoria.
- Trabalho original
- DINOv2, Meta AI (FAIR)
- Licença original
- Apache-2.0
- Código-fonte original
- github.com/facebookresearch/dinov2
- Código do LibreYOLO
- MIT
- Pesos
- Apache-2.0, distribuído pelos autores. O LibreYOLO não hospeda nem espelha esses pesos.
- Interpretação
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
A linha "Weights" acima nomeia a licença que se aplica, Apache-2.0, mas nada é
de fato republicado sob a org do LibreYOLO no Hugging Face para esta família:
o LibreYOLO não hospeda nenhum checkpoint LibreDINOv2 próprio. O que
LibreDINOv2(model_path=None) baixa é o repositório
facebook/dinov2-with-registers-small da própria Meta, intocado.
Citação
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
Copiado do bloco de citação dos autores em github.com/facebookresearch/dinov2#citing-dinov2.