MiDaS
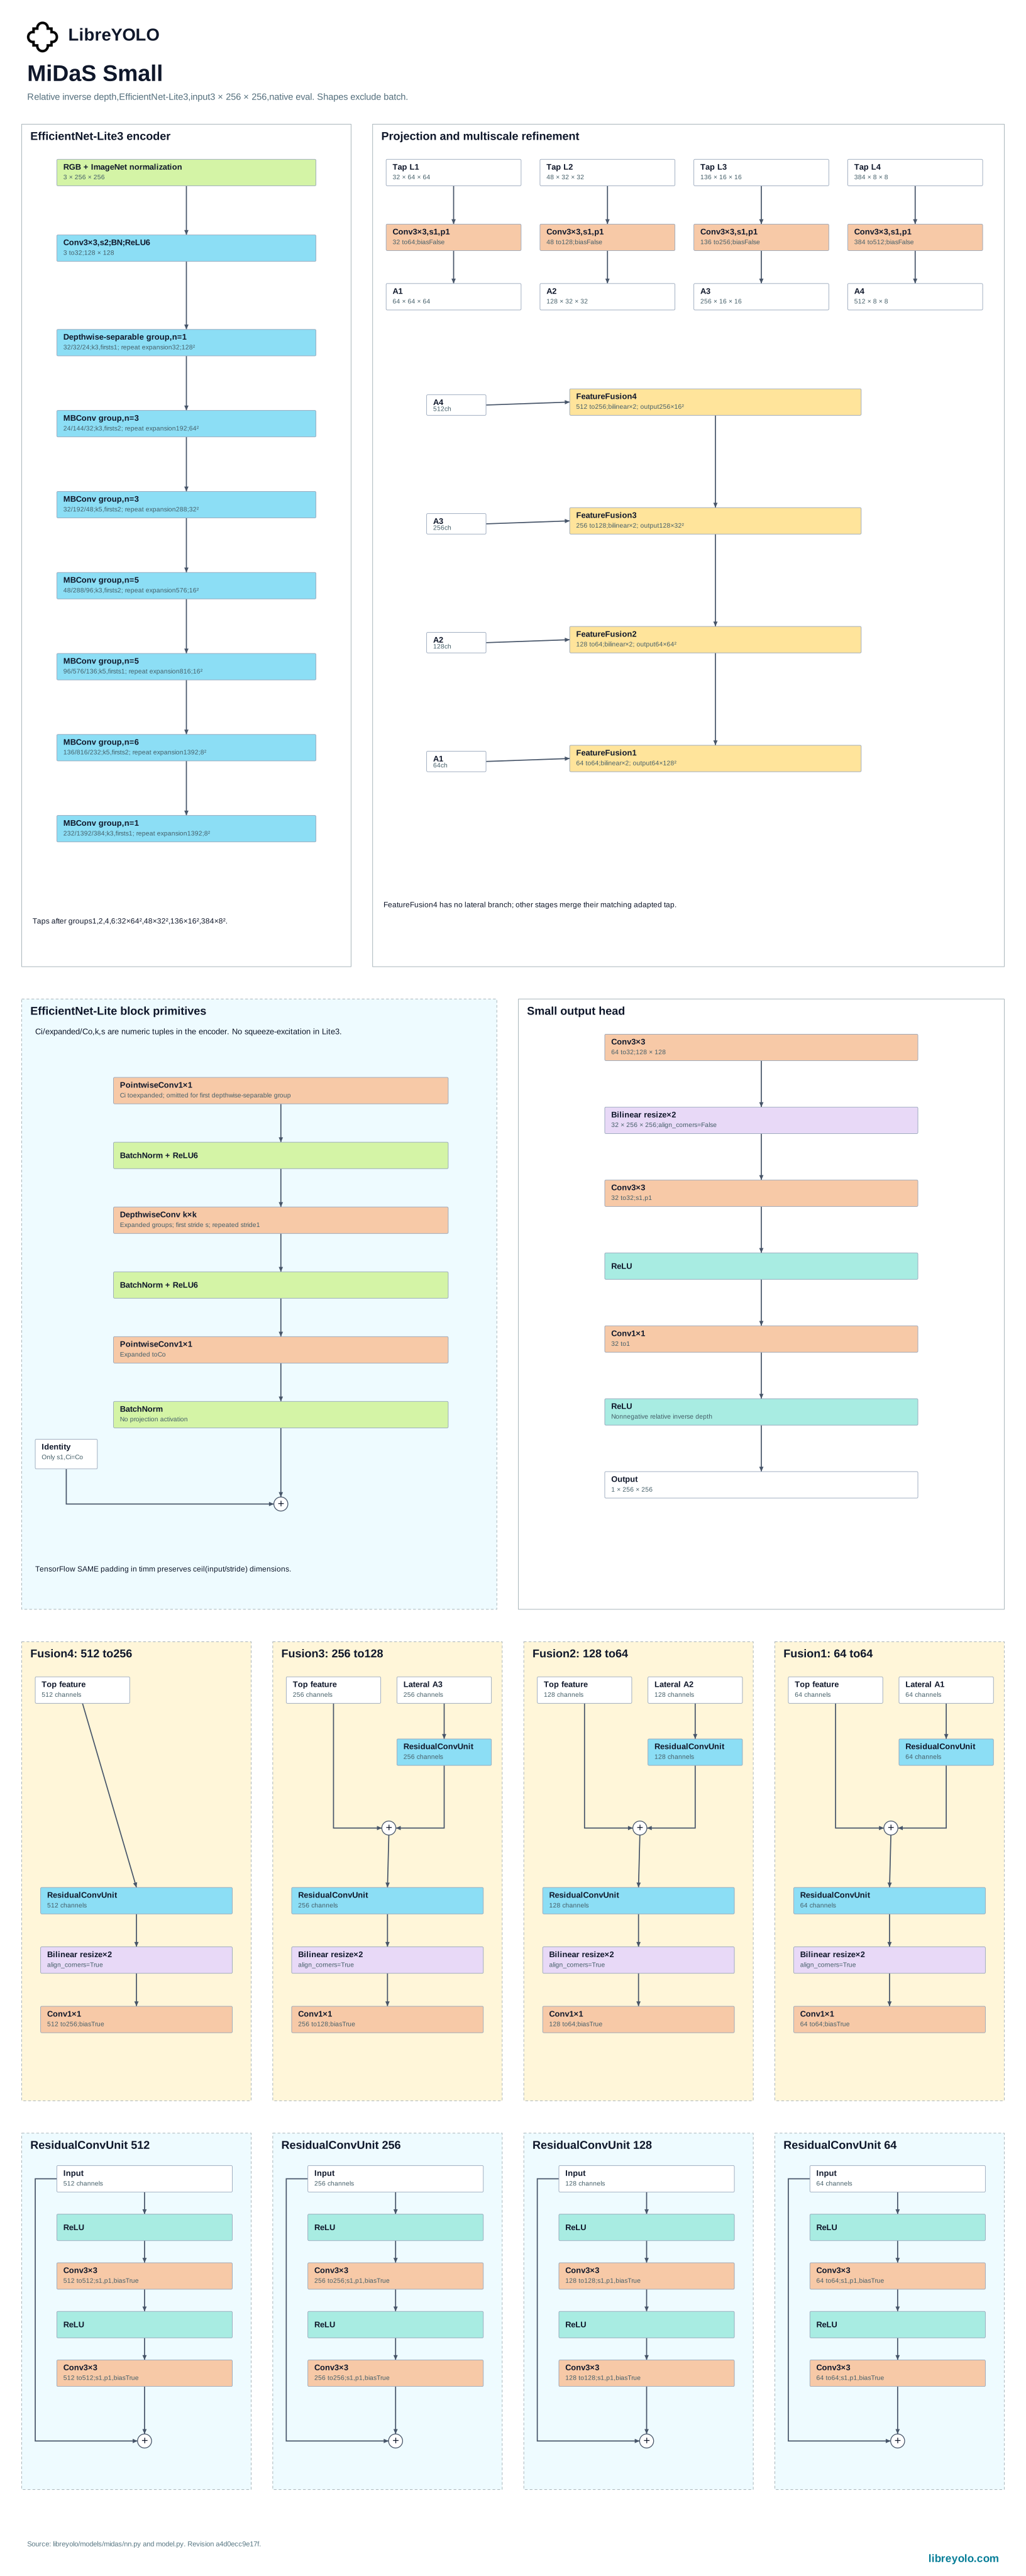
O MiDaS é estimativa de profundidade relativa monocular treinada com uma loss invariante a escala e deslocamento sobre datasets mistos, a linha de trabalho que estabeleceu o protocolo de transferência zero-shot de profundidade que as famílias seguintes reutilizam. O LibreYOLO oferece suporte a ele na tarefa de profundidade: predição e validação zero-shot, sem caminho de treinamento.
- Tarefas
- depth
- Tamanhos
- s, l at 256 to 384 px
- Instalação
pip install "libreyolo[midas]"- Nível de suporte
- Somente inferência, desde a v1.5.0. Somente predição, validação e exportação. Os recursos de treinamento não se aplicam.
- Origem
- MiDaS por Intel Intelligent Systems Lab (Intel ISL), MIT. Artigo, código-fonte
- Licenças
- Código MIT, pesos MIT. Uso comercial
Instalação
MiDaS precisa do extra midas para seus encoders timm.
pip install "libreyolo[midas]"Predição
Os checkpoints s e l são baixados dos espelhos do LibreYOLO sob a licença MIT do publicador e ficam em cache localmente.
from libreyolo import LibreYOLO, SAMPLE_IMAGE # Baixa o checkpoint espelhado no primeiro uso.model = LibreYOLO("LibreMiDaSl-depth.pt")result = model(SAMPLE_IMAGE, save=True) depth = result.depth_mapprint(depth.min, depth.max, depth.mean)libreyolo predict model=LibreMiDaSl-depth.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Encoder EfficientNet-Lite3, menor e mais rápido que o tamanho l, DPT-Large.model = LibreYOLO("LibreMiDaSs-depth.pt")result = model(SAMPLE_IMAGE, save=True)result.depth_map contém um mapa denso de profundidade inversa relativa: valores maiores indicam maior proximidade da câmera, e os valores não têm unidade métrica nem escala entre imagens. save=True grava no disco uma visualização desse mapa com cores; Results.plot() renderiza o mapa de profundidade. Veja predição para fontes, streaming e tratamento de resultados.
Variantes
Duas variantes com encoders diferentes, não apenas escalas diferentes do mesmo
encoder. s é o MiDaS v2.1 Small, um encoder EfficientNet-Lite3. l é o
DPT-Large, um encoder ViT-L/16 com o decoder DPT que o MiDaS introduziu para
predição densa. Elas também fazem o pré-processamento de forma diferente: s
usa um redimensionamento de proporção com limite superior e normalização por
média/desvio padrão do ImageNet, l usa um redimensionamento de proporção
mínimo com média e desvio padrão de 0.5. Escolha s para uma CNN mais leve, l
para a acurácia do decoder transformer.
Treinamento não é oferecido para esta família. LibreMiDaS.train() levanta
NotImplementedError incondicionalmente.
Validação
val() roda o validador de profundidade compartilhado: ele alinha cada predição
ao seu ground truth com uma escala e um deslocamento de mínimos quadrados por
imagem, e depois reporta as métricas padrão de profundidade relativa zero-shot,
AbsRel, RMSE e os três limiares delta.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/abs_rel"])print(metrics["metrics/rmse"])print(metrics["metrics/delta1"])libreyolo val model=LibreMiDaSl-depth.pt data=my-dataset.yamlExportação
| Tarefa | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Depth | Depth to ONNX: compatível | Depth to TorchScript: compatível | Depth to ExecuTorch: compatível | Depth to TensorRT: compatível | Depth to OpenVINO: compatível | Depth to Paddle: incompatível | Depth to MNN: incompatível | Depth to RKNN: incompatível | Depth to ncnn: compatível | Depth to TFLite: incompatível | Depth to CoreML: incompatível | Depth to Core AI: incompatível |
Um artefato exportado é carregado de volta por LibreYOLO() pelo sufixo do
arquivo, então um arquivo .onnx ou .engine se comporta como um checkpoint e
devolve o mesmo Results, com depth_map no lugar dos boxes.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreMiDaSl-depth.pt format=onnxlibreyolo export model=LibreMiDaSl-depth.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # A factory roteia pelo sufixo do arquivo, então um artefato exportado# carrega como qualquer checkpoint e devolve o mesmo objeto Results.model = LibreYOLO("LibreMiDaSl-depth.onnx")result = model(SAMPLE_IMAGE) print(result.depth_map.data.shape)Licenciamento
Confira a licença no repositório do Hugging Face correspondente aos pesos que você baixar. Cada checkpoint na organização LibreYOLO tem uma licença, e ela nem sempre é a mesma em toda a família. Esse repositório é a fonte oficial. O resumo abaixo descreve o que se aplicava na última verificação desta página.
Esta é uma descrição das licenças envolvidas, não uma orientação jurídica. Se a resposta tiver importância comercial, leia as licenças e procure sua própria assessoria.
- Trabalho original
- MiDaS, Intel Intelligent Systems Lab (Intel ISL)
- Licença original
- MIT
- Código-fonte original
- github.com/isl-org/MiDaS
- Código do LibreYOLO
- MIT
- Pesos
- MIT, republicado em huggingface.co/LibreYOLO
- Interpretação
- The upstream repository and released weights declare MIT. LibreYOLO mirrors the s and l checkpoints under that publisher grant.
Citação
@ARTICLE {Ranftl2022,
    author  = "Ren\'{e} Ranftl and Katrin Lasinger and David Hafner and Konrad Schindler and Vladlen Koltun",
    title   = "Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-Shot Cross-Dataset Transfer",
    journal = "IEEE Transactions on Pattern Analysis and Machine Intelligence",
    year    = "2022",
    volume  = "44",
    number  = "3"
}

@article{Ranftl2021,
	author    = {Ren\'{e} Ranftl and Alexey Bochkovskiy and Vladlen Koltun},
	title     = {Vision Transformers for Dense Prediction},
	journal   = {ICCV},
	year      = {2021},
}
Copiado do bloco de citação dos autores em github.com/isl-org/MiDaS#citation.