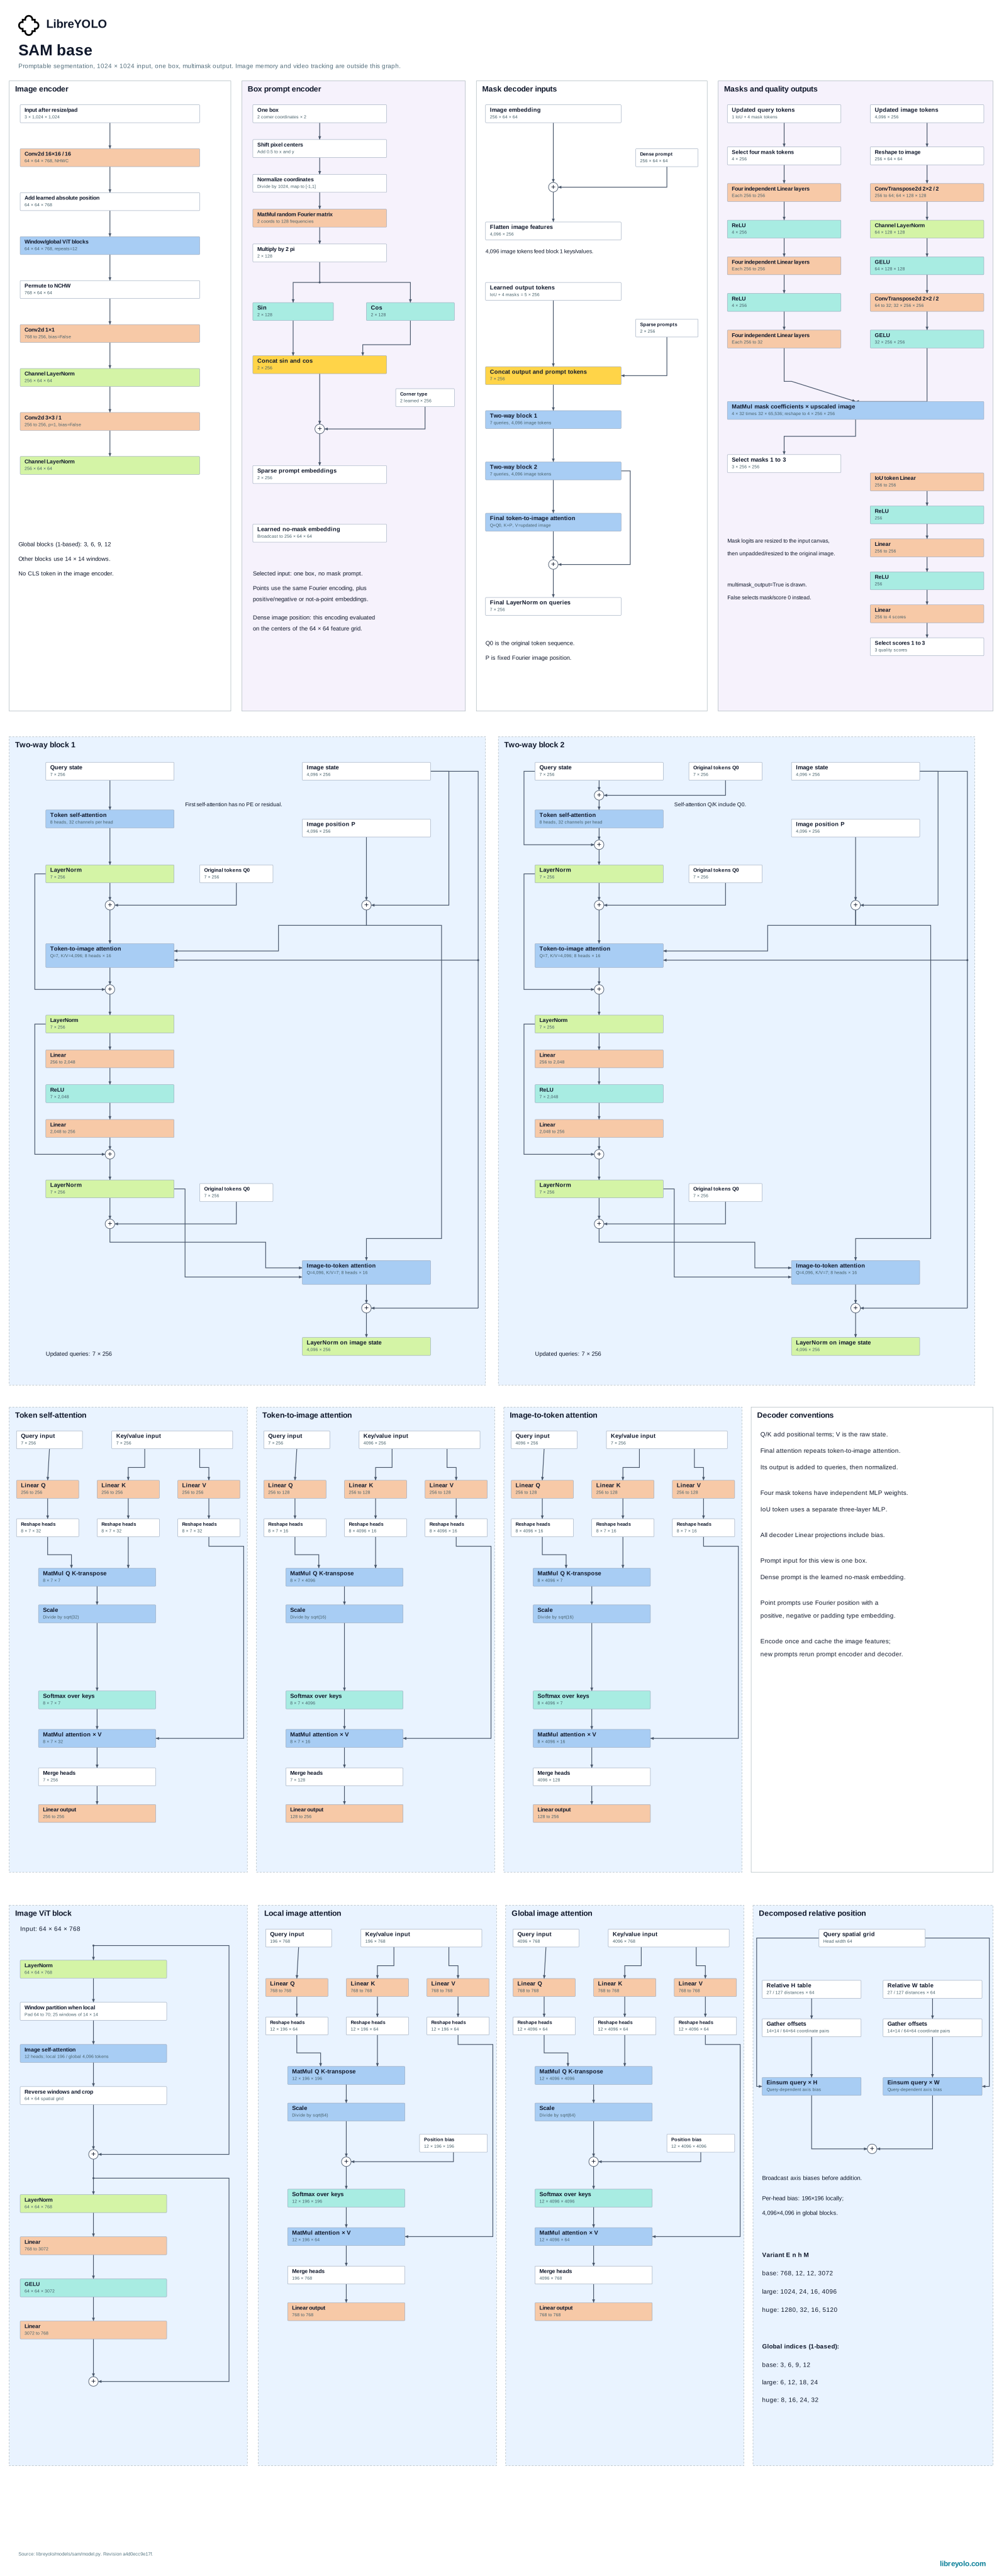
SAM
O SAM (Segment Anything) transforma um clique de ponto ou de caixa na máscara de um objeto. O LibreYOLO o carrega por meio de uma factory LibreSAM dedicada, separada da factory de detectores LibreYOLO(), porque um modelo guiado por prompt precisa de outro formato de chamada.
- Tarefas
- instance segmentation
- Tamanhos
- base, large, huge at 1024 px
- Instalação
pip install "libreyolo[sam]"- Nível de suporte
- Nível irmão, desde a v1.3.0. Uma superfície de produto separada, com sua própria fábrica e seu próprio contrato.
- Origem
- SAM (Segment Anything) por Meta AI Research (FAIR), Apache-2.0. Artigo, código-fonte
- Licenças
- Código MIT, pesos Apache-2.0. Uso comercial
Instalação
O SAM precisa do extra sam, que instala junto transformers e timm.
pip install "libreyolo[sam]"Predição
LibreSAM(...) é um ponto de entrada separado de LibreYOLO(...): ele devolve
um segmentador guiado por prompt em vez de um detector, porque aqui um forward
pass não significa nada sem um prompt espacial. Não existe comando de CLI
libreyolo predict para esta família; use a API do Python.
from libreyolo import LibreSAM, SAMPLE_IMAGE # "base" baixa automaticamente facebook/sam-vit-base no primeiro uso.# Outros tamanhos: "large", "huge" (também "b"/"l"/"h").model = LibreSAM("base") # Um prompt de ponto: [x, y] em coordenadas de pixel, label 1 = primeiro plano.result = model.predict(SAMPLE_IMAGE, points=[640, 420], labels=[1])print(result.masks.xy) # um polígono por máscaraprint(result.boxes.xyxy) # caixa justa derivada da máscara # Um prompt de caixa em vez de um ponto.result = model.predict(SAMPLE_IMAGE, bboxes=[300, 200, 900, 700]) # Sem nenhum prompt, a imagem inteira é segmentada (um gerador# automático de máscaras simplificado, não o exaustivo de referência).result = model.predict(SAMPLE_IMAGE)from libreyolo import LibreSAM, SAMPLE_IMAGE model = LibreSAM("base") # O encoder de imagem é a parte cara. set_image() o executa uma vez;# toda chamada a predict() depois disso reutiliza o embedding em cache.model.set_image(SAMPLE_IMAGE)a = model.predict(points=[640, 420], labels=[1])b = model.predict(bboxes=[300, 200, 900, 700])model.reset_image()Um prompt de ponto aceita [x, y] para um objeto, [[x, y], ...] para vários,
ou arrays do numpy; labels marca cada ponto com 1 (primeiro plano) ou 0
(fundo) e, por padrão, todos são primeiro plano. Um prompt de caixa recebe
[x1, y1, x2, y2] ou uma lista de caixas, uma máscara por caixa. Omitir os dois
prompts segmenta a imagem inteira lançando uma grade densa de prompts e ficando
com as máscaras confiantes que não se sobrepõem; esse modo "segmentar tudo" é
simplificado em relação ao gerador automático de máscaras de referência e pode
subsegmentar cenas cheias, então um prompt real de ponto ou de caixa é o caminho
preciso. conf filtra pela qualidade de máscara prevista (IoU), não por uma
confiança de detecção: passe 0.0 para manter todos os candidatos.
multimask=True devolve as três máscaras de ambiguidade todo-versus-parte do
SAM para cada prompt, em vez de apenas a melhor. device= move o modelo e, se
houver uma sessão de set_image() ativa, o embedding em cache dela. Toda
máscara carrega o id de classe 0, com nome "object", já que uma máscara
guiada por prompt não tem um conjunto fixo de classes. train(), val(),
export() e track() levantam NotImplementedError nesta família: o SAM é
somente predição no LibreYOLO, e o rastreamento em vídeo está fora do escopo.
Veja predição para os tipos de fonte.
Variantes
Três tamanhos de encoder de imagem ViT: base, large e huge, todos com entrada fixa de 1024 px. Ainda não há nenhum benchmark de acurácia ou de latência publicado para esta família, então escolher um tamanho troca diretamente peso do encoder por qualidade de máscara: base é o mais rápido de codificar, huge o mais pesado.
Licenciamento
Confira a licença no repositório do Hugging Face correspondente aos pesos que você baixar. Cada checkpoint na organização LibreYOLO tem uma licença, e ela nem sempre é a mesma em toda a família. Esse repositório é a fonte oficial. O resumo abaixo descreve o que se aplicava na última verificação desta página.
Esta é uma descrição das licenças envolvidas, não uma orientação jurídica. Se a resposta tiver importância comercial, leia as licenças e procure sua própria assessoria.
- Trabalho original
- SAM (Segment Anything), Meta AI Research (FAIR)
- Licença original
- Apache-2.0
- Código-fonte original
- github.com/facebookresearch/segment-anything
- Código do LibreYOLO
- MIT
- Pesos
- Apache-2.0, republicado em huggingface.co/LibreYOLO
- Interpretação
- SAM-1 base, large and huge use LibreYOLO mirrors of the publisher artifacts under Apache-2.0.
LibreSAM("base"), "large" e "huge" usam espelhos do LibreYOLO dos artefatos SAM-1. Os pesos mantêm a declaração Apache-2.0 da Meta.
Citação
@article{kirillov2023segany,
  title={Segment Anything},
  author={Kirillov, Alexander and Mintun, Eric and Ravi, Nikhila and Mao, Hanzi and Rolland, Chloe and Gustafson, Laura and Xiao, Tete and Whitehead, Spencer and Berg, Alexander C. and Lo, Wan-Yen and Doll{\'a}r, Piotr and Girshick, Ross},
  journal={arXiv:2304.02643},
  year={2023}
}
Copiado do bloco de citação dos autores em github.com/facebookresearch/segment-anything#citing-segment-anything.