YOLOv9
Um detector convolucional de estágio único: uma passada pontua uma grade densa de caixas e o NMS descarta as duplicadas. O LibreYOLO traz três variantes dele, uma delas sem etapa de NMS.
- Tarefas
- detection
- Tamanhos
- yolo9: t, s, m, c at 640 px; yolo9_p2: t, s at 640 px
- Instalação
pip install libreyolo- Nível de suporte
- Carro-chefe, desde a v1.0.0. Os recursos são projetados e validados por completo em GPU aqui primeiro.
- Origem
- YOLOv9 por MultimediaTechLab, MIT. Artigo, código-fonte
- Licenças
- Código MIT, pesos MIT. Uso comercial
Instalação
O YOLOv9 não precisa de nenhum extra além do pacote base.
pip install libreyoloPredição
Os pesos são baixados do Hugging Face no primeiro uso e ficam em cache localmente.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreYOLO9s.pt")result = model(SAMPLE_IMAGE, save=True) for box in result.boxes: print(box.cls, box.conf, box.xyxy)libreyolo predict model=LibreYOLO9s.pt save=True \ source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpgfrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Mesma chamada, checkpoint diferente. A cabeça end-to-end devolve suas# próprias predições de maior pontuação, então nenhum NMS roda e iou é ignorado.model = LibreYOLO("LibreYOLO9E2Es.pt")result = model(SAMPLE_IMAGE, conf=0.25, max_det=300) print(len(result.boxes))O objeto Results retornado é o mesmo que todas as famílias retornam, então
trocar por outro detector é uma mudança de uma linha. Nos modelos base e de
stride 4, conf define o limiar de confiança e iou o limiar do NMS. O modelo
end-to-end não roda NMS e ignora iou, então conf e max_det são o que dá
forma à saída dele. Veja predição para fontes, streaming e
tratamento de resultados.
Variantes
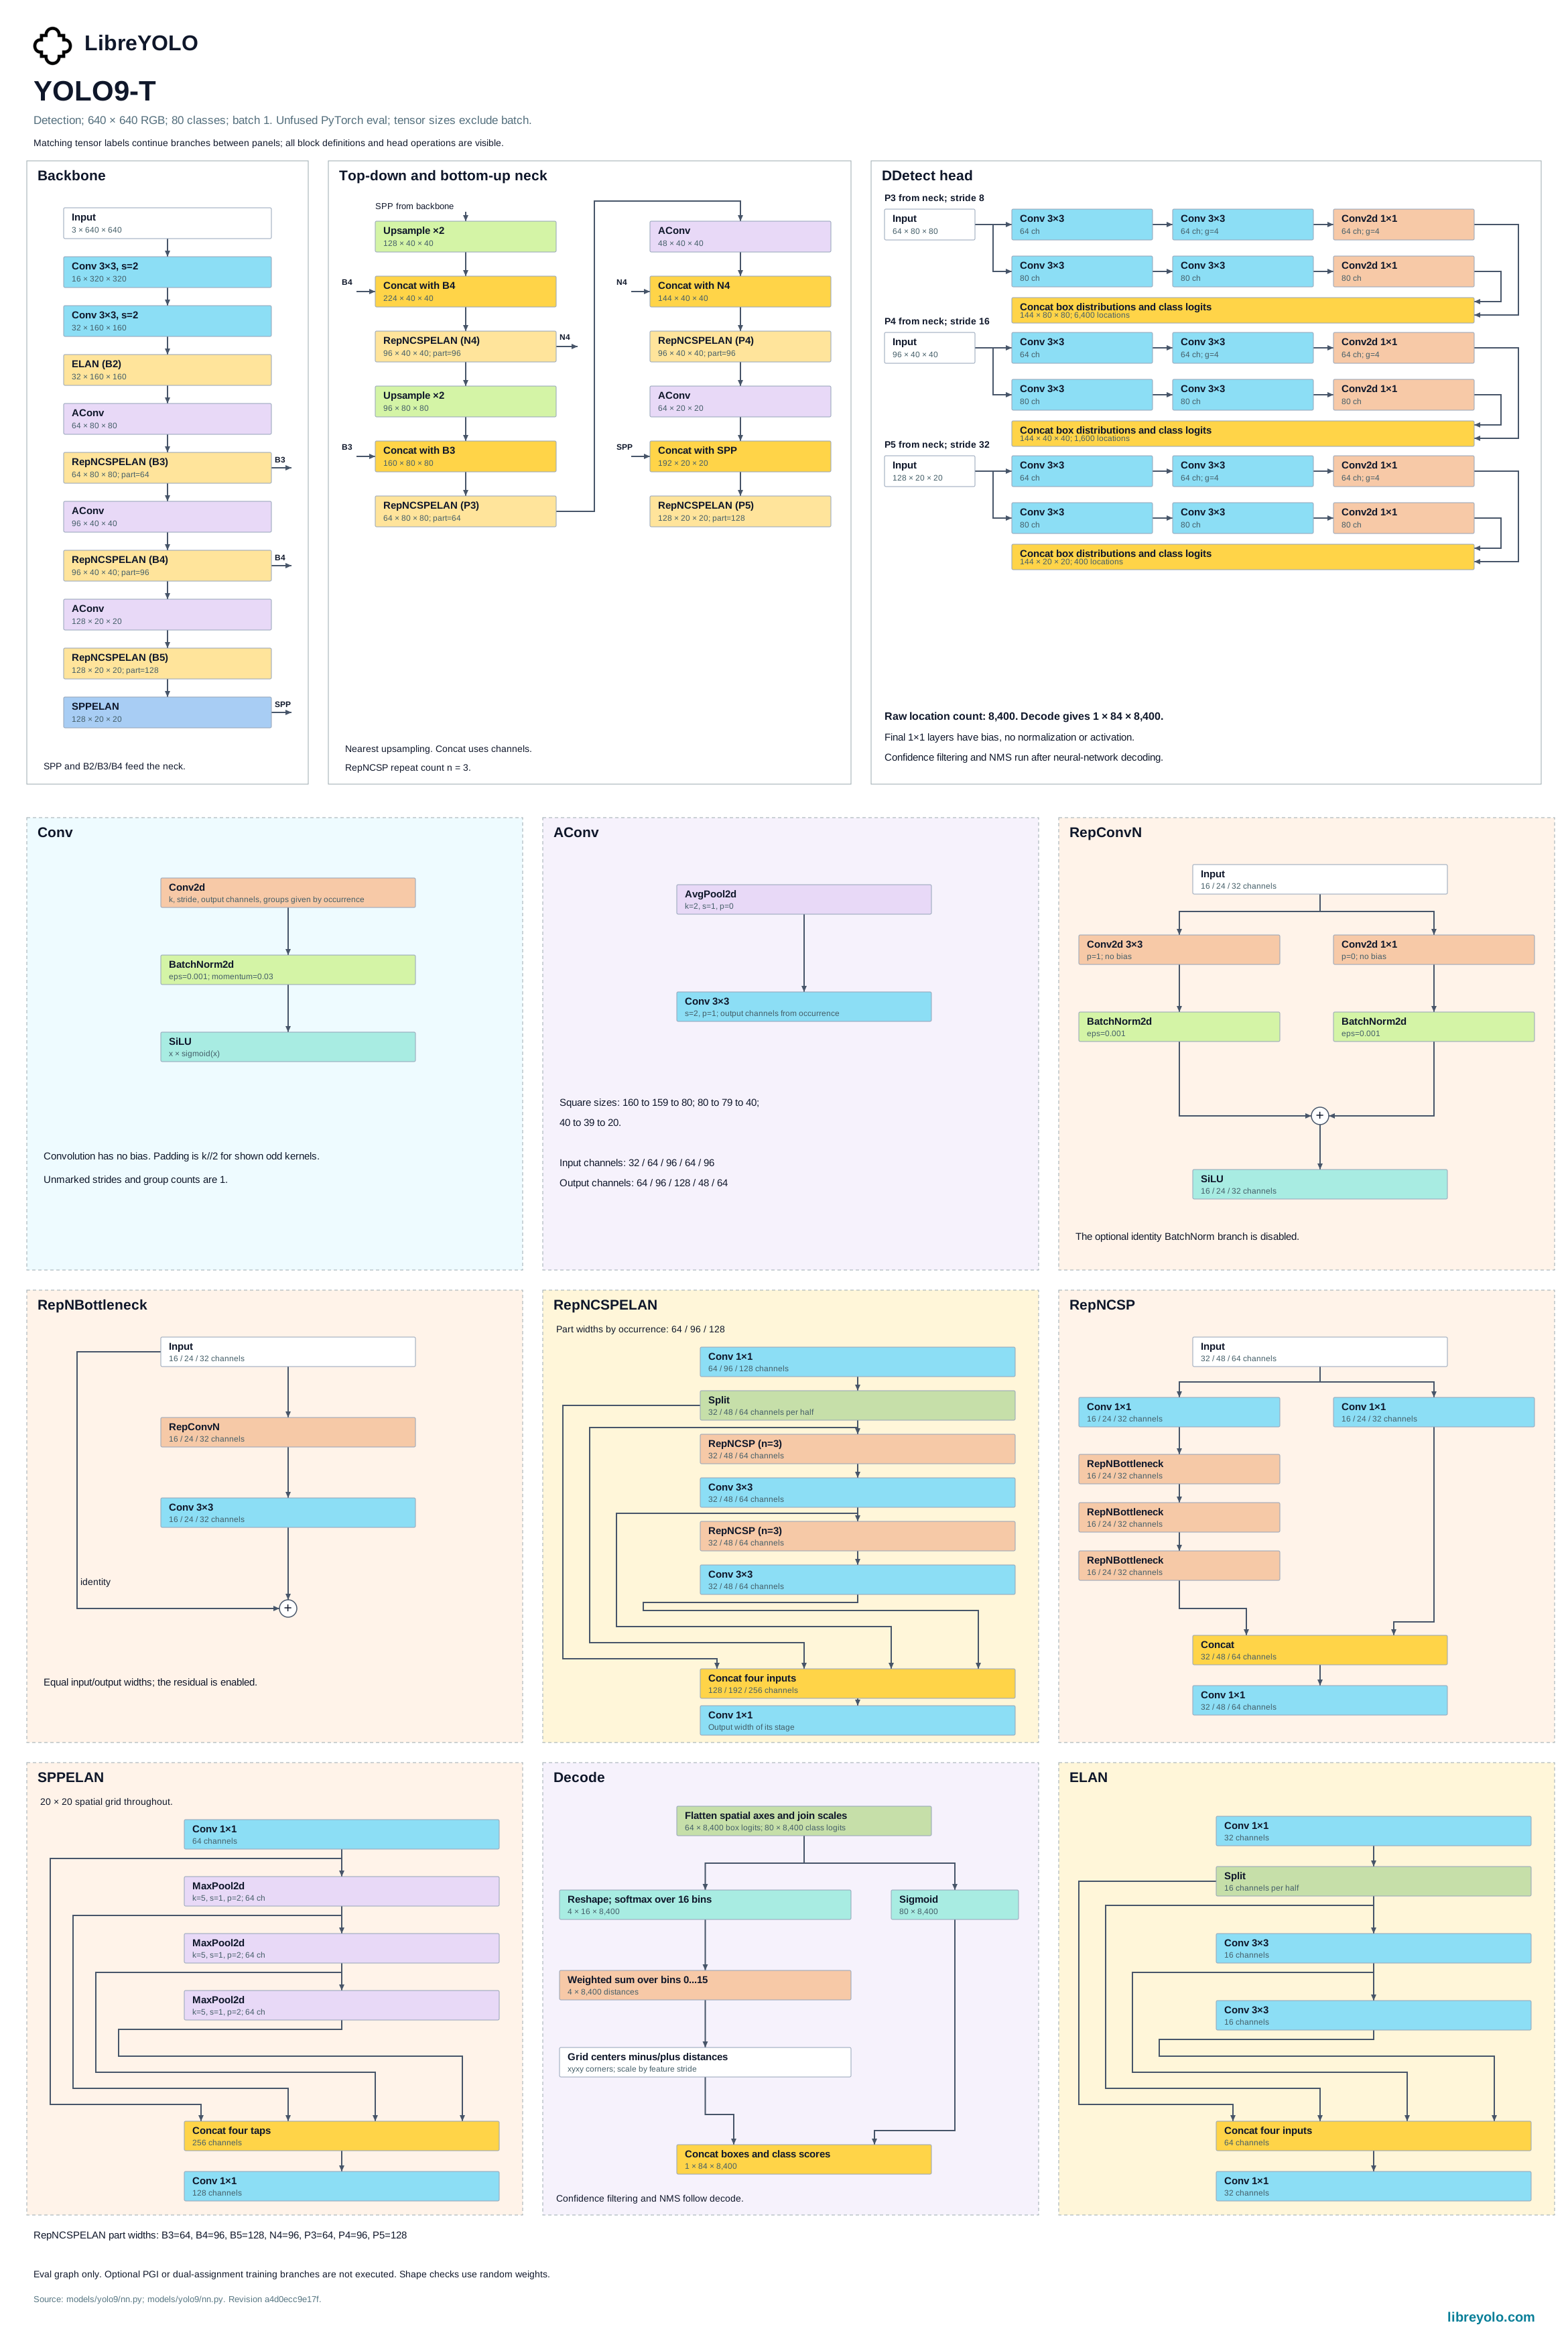
Três variantes compartilham um backbone. As três só detectam, e aceitam os mesmos argumentos.
O modelo base prediz em três escalas de características e elimina as caixas duplicadas com NMS.
O modelo end-to-end mantém essa cabeça e acrescenta ao lado dela um ramo de correspondência um-para-um. A inferência lê só o ramo um-para-um e pega as predições de maior pontuação dele, então nenhum NMS roda. Escolha esse quando o runtime em que você faz deploy não tiver operador de NMS.
O modelo de stride 4 puxa mais um nível acima no backbone, estende o neck até ele e prediz em quatro escalas em vez de três. A escala extra é para objetos que cobrem poucos pixels; o único checkpoint publicado para ele é treinado com imagens aéreas. Checkpoints de detecção base se transferem para ele: o backbone e o neck carregam sem alterações, as três torres de cabeça pré-treinadas sobem uma posição e a torre de stride 4 parte de inicialização aleatória.
| Checkpoint | Entrada (px) | mAP 50-95 | Parâmetros (M) |
|---|---|---|---|
| LibreYOLO9c | 640 | 56.4 | 25.5 |
| LibreYOLO9m | 640 | 55.3 | 20.12 |
| LibreYOLO9s | 640 | 55.9 | 7.2 |
| LibreYOLO9t | 640 | 41.8 | 2.04 |
COCO val2017, 500 images. Medido pelo conjunto de testes de benchmark do LibreYOLO e publicado no Vision Analysis, onde a latência entre hardwares e runtimes é comparada e os registros completos das execuções ficam disponíveis.
Treinamento
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.train(data="my-dataset.yaml", epochs=100, imgsz=640, batch=16)libreyolo train model=LibreYOLO9s.pt data=my-dataset.yaml \ epochs=100 imgsz=640 batch=16from libreyolo import LibreYOLO9P2 # A variante de stride 4 não tem checkpoint COCO próprio, então indique# um de detecção base: o backbone e o neck dele carregam sem alterações# e a torre da cabeça de stride 4 parte de inicialização aleatória.model = LibreYOLO9P2(None, size="s")model.train(data="my-dataset.yaml", epochs=100, pretrained="LibreYOLO9s.pt")pretrained decide de onde a execução parte. Passe True para carregar o
checkpoint publicado do mesmo modelo e tamanho, ou um nome ou caminho para
qualquer outra coisa. Tensores cuja forma não bate são pulados em vez de
recusados, e a execução registra quantos foram carregados, então um checkpoint
treinado com um número diferente de classes ainda é um ponto de partida
utilizável.
O modelo de stride 4 não tem checkpoint COCO publicado próprio, então True
resolve ali para um arquivo que não existe e o download falha. Indique um
checkpoint de detecção base no lugar.
Veja treinamento para datasets, data augmentation, multi-GPU e loggers.
O modelo base pode treinar um ramo auxiliar PGI ao lado da cabeça principal. O
ramo é exclusivo do treinamento: predição e exportação usam a cabeça principal.
Uma execução o anexa quando os pesos iniciais trazem tensores PGI ou quando
treina do zero. Os checkpoints base publicados não trazem nenhum, então um
fine-tuning a partir deles treina só a cabeça principal e registra isso no log.
aux_weight=0.25 anexa um ramo novo com esse peso de loss mesmo assim, e
aux_weight=0 o mantém desligado. Uma execução retomada mantém a configuração
PGI do seu checkpoint. Nos tamanhos m e c o ramo é o do upstream: um segundo
backbone sobre a imagem de entrada, cujos estágios o CBFuse soma com taps
CBLinear do backbone principal, e sua própria cabeça, com 12.8M e 25.7M de
parâmetros exclusivos do treinamento com 80 classes. Os modelos end-to-end e de
stride 4 não têm ramo PGI.
As três variantes limitam a norma L2 do gradiente a 10 antes de cada passo do
otimizador; clip_max_norm=0 desliga o clipping. A atribuição de labels pontua
as âncoras em fp32, também sob autocast float16. max_labels=300 limita as
caixas mantidas por imagem de treinamento, e as caixas além disso são descartadas
com um aviso único; a memória da atribuição acompanha as caixas reais de cada
imagem, não o limite. O momentum do SGD aumenta de 0.8 a 0.937 durante três
épocas. letterbox_pad=None herda o registro do checkpoint: pesos sem registro
usam topleft, enquanto novas conversões oficiais registram center.
O mosaic de YOLO9 e YOLOX prefere imagens parceiras anotadas, com no máximo 20 sorteios; o MixUp de YOLO9 usa a mesma política. O MixUp vem desligado por padrão (mixup_prob=0). Quando ligado, a razão de mistura é sorteada de Beta(1, 1), uniforme em [0, 1], como no MultimediaTechLab/YOLO. Veja histogramas de eventos para perfis de entrada não RGB.
Validação
val() retorna um dicionário de chaves metrics/ cobrindo precisão, recall,
mAP 50 e mAP 50-95, medidos contra qualquer dataset no formato em que você
treinou.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mAP50-95"])print(metrics["metrics/mAP50"])libreyolo val model=LibreYOLO9s.pt data=my-dataset.yaml# O yaml de COCO que vem junto carrega um script de download embutido,# então ele precisa de permissão explícita a menos que o dataset já esteja local.libreyolo val model=LibreYOLO9c.pt data=coco.yaml imgsz=640 \ allow_download_scripts=TrueExportação
| Tarefa | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Detection | Detection to ONNX: compatível | Detection to TorchScript: compatível | Detection to ExecuTorch: compatível | Detection to TensorRT: compatível | Detection to OpenVINO: compatível | Detection to Paddle: compatível | Detection to MNN: compatível | Detection to RKNN: incompatível | Detection to ncnn: compatível | Detection to TFLite: incompatível | Detection to CoreML: incompatível | Detection to Core AI: compatível |
Uma marca vale para as três variantes: onde elas diferem, a matriz traz a mais fraca das três.
Um artefato exportado é recarregado pelo LibreYOLO() a partir do sufixo do
arquivo, então um arquivo .onnx ou .engine se comporta como um checkpoint e
devolve o mesmo Results. Rodar o grafo em um runtime puro, sem o LibreYOLO
instalado, também é suportado, mas aí o pré-processamento e o pós-processamento
ficam por sua conta.
Para o modelo de detecção base, a metade de pós-processamento disso pode ir para
dentro do grafo. nms=True em uma exportação para ONNX coloca a supressão
dentro do modelo, e a primeira saída passa a ser um tensor fixo
(1, max_det, 6) cujas linhas são x1, y1, x2, y2, score, class, preenchidas
com zeros além da contagem de detecções. Esse grafo é de batch 1 e não carrega
eixos dinâmicos. Os modelos end-to-end e de stride 4 não aceitam a flag.
Cada formato instala um extra diferente e aceita alguns argumentos próprios. As duas coisas estão na página daquele formato.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.export(format="onnx", imgsz=640)libreyolo export model=LibreYOLO9s.pt format=onnx imgsz=640libreyolo export model=LibreYOLO9s.pt format=onnx nms=True \ conf=0.25 iou=0.45 max_det=300from libreyolo import LibreYOLO, SAMPLE_IMAGE # A factory decide pelo sufixo do arquivo, então um artefato exportado# carrega como qualquer checkpoint e devolve o mesmo objeto Results.model = LibreYOLO("LibreYOLO9s.onnx")result = model(SAMPLE_IMAGE) print(result.boxes.xyxy)TFLite INT8 usa int8=True com dados de calibração.
Entradas e saídas ONNX
LibreYOLO9
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Cor | RGB |
| Escala | pixel / 255 |
| Normalização | nenhuma |
| Redimensionamento | letterbox, bilinear, valor de preenchimento 114, posição do preenchimento vinda da chave de metadados letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
Detection, exportação padrão
| Saída | Forma | Significado |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Pós-processamento
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Detection, nms=True
| Saída | Forma | Significado |
|---|---|---|
output | [1, max_det, 6] | Rows are x1, y1, x2, y2, score, class in input-canvas pixels, zero-padded past the detection count. Confidence, IoU and max_det are baked in and recorded as nms_conf, nms_iou and max_det metadata. |
raw | [1, 4 + nc, anchors] | The same tensor as the default export's output, before suppression. |
Pós-processamento
- Drop rows whose score is 0 or below your threshold.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
LibreYOLO9E2E
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Cor | RGB |
| Escala | pixel / 255 |
| Normalização | nenhuma |
| Redimensionamento | letterbox, bilinear, valor de preenchimento 114, posição do preenchimento vinda da chave de metadados letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, exportação padrão
| Saída | Forma | Significado |
|---|---|---|
output | [batch, 4 + nc, anchors] | Predictions of the one-to-one head only. Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Pós-processamento
- Transpose to [anchors, 4 + nc].
- Flatten the [anchors, nc] scores into one list of anchors x nc (anchor, class) pairs. Pair i belongs to anchor i / nc (integer division) and class i % nc.
- Keep the 300 highest-scoring pairs (max_det), highest first. One anchor can yield several classes.
- Of those, keep the pairs whose score is above the confidence threshold (0.25 by default).
- Do not run NMS. The one-to-one head is trained to fire once per object, and LibreYOLO ignores the iou setting for this model.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
LibreYOLO9P2
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Cor | RGB |
| Escala | pixel / 255 |
| Normalização | nenhuma |
| Redimensionamento | letterbox, bilinear, valor de preenchimento 114, posição do preenchimento vinda da chave de metadados letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, exportação padrão
| Saída | Forma | Significado |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 4, 8, 16 and 32, 34000 at 640 x 640. nc is 10 for LibreYOLO9P2s-visdrone. |
Pós-processamento
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Para conferir a sua própria implementação, passe o mesmo arquivo pelo LibreYOLO: LibreYOLO("model.onnx").predict("image.jpg") devolve os resultados de referência. Verificado com o LibreYOLO 1.7.0.
Checkpoints
Todos os arquivos de pesos publicados desta família.
| Arquivo | Entrada (px) | Licença dos pesos |
|---|---|---|
| Detection | ||
| LibreYOLO9t.pt | 640 | mit |
| LibreYOLO9s.pt | 640 | mit |
| LibreYOLO9m.pt | 640 | mit |
| LibreYOLO9c.pt | 640 | mit |
| LibreYOLO9E2Et.pt | 640 | mit |
| LibreYOLO9E2Es.pt | 640 | mit |
| LibreYOLO9E2Em.pt | 640 | mit |
| LibreYOLO9E2Ec.pt | 640 | mit |
| LibreYOLO9P2s-visdrone.pt | cc-by-nc-sa-3.0 | |
Todos os arquivos acima existem hoje na organização LibreYOLO e são baixados no primeiro uso.
Licenciamento
Confira a licença no repositório do Hugging Face correspondente aos pesos que você baixar. Cada checkpoint na organização LibreYOLO tem uma licença, e ela nem sempre é a mesma em toda a família. Esse repositório é a fonte oficial. O resumo abaixo descreve o que se aplicava na última verificação desta página.
Esta é uma descrição das licenças envolvidas, não uma orientação jurídica. Se a resposta tiver importância comercial, leia as licenças e procure sua própria assessoria.
- Trabalho original
- YOLOv9, MultimediaTechLab
- Licença original
- MIT
- Código-fonte original
- github.com/MultimediaTechLab/YOLO
- Código do LibreYOLO
- MIT
- Pesos
- MIT, republicado em huggingface.co/LibreYOLO
- Interpretação
- MIT is a permissive license, so these weights can be used in commercial and closed-source products. The one standing obligation is to keep the license text and the copyright notice, Kin-Yiu Wong and Hao-Tang Tsui, with any copy you redistribute. It places no condition on your own application code, and a model you train yourself on your own data is yours. Two things are worth knowing beyond that. The code is ported from the authors' MIT re-release of YOLOv9, MultimediaTechLab/YOLO at commit c4cb5f6f, not the GPL-3.0 repository that carries the same model, so the permissive terms come from the source LibreYOLO actually derives from. And one checkpoint in this family is not MIT: the weight repository of the stride-4 VisDrone model, LibreYOLO9P2s-visdrone.pt, declares CC BY-NC-SA 3.0, which rules out commercial use and requires share-alike on derivatives.
O código das três variantes é portado de
MultimediaTechLab/YOLO no commit
c4cb5f6f (MIT). O preditor one-to-one do modelo end-to-end segue o design do
DATE, de Yiqun Chen (Apache-2.0),
implementado para o LibreYOLO sem nenhum código do DATE copiado. O nível de
stride 4 é código do LibreYOLO.
O checkpoint aéreo com stride 4 prevê as classes VisDrone. Use a licença declarada pelo publicador no repositório dos pesos.
Citação
@inproceedings{wang2024yolov9,
      title={{YOLOv9}: Learning What You Want to Learn Using Programmable Gradient Information},
      author={Wang, Chien-Yao and Yeh, I-Hau and Liao, Hong-Yuan Mark},
      year={2024},
      booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
}
Copiado do bloco de citação dos autores em github.com/MultimediaTechLab/YOLO#citations.