DINOv2
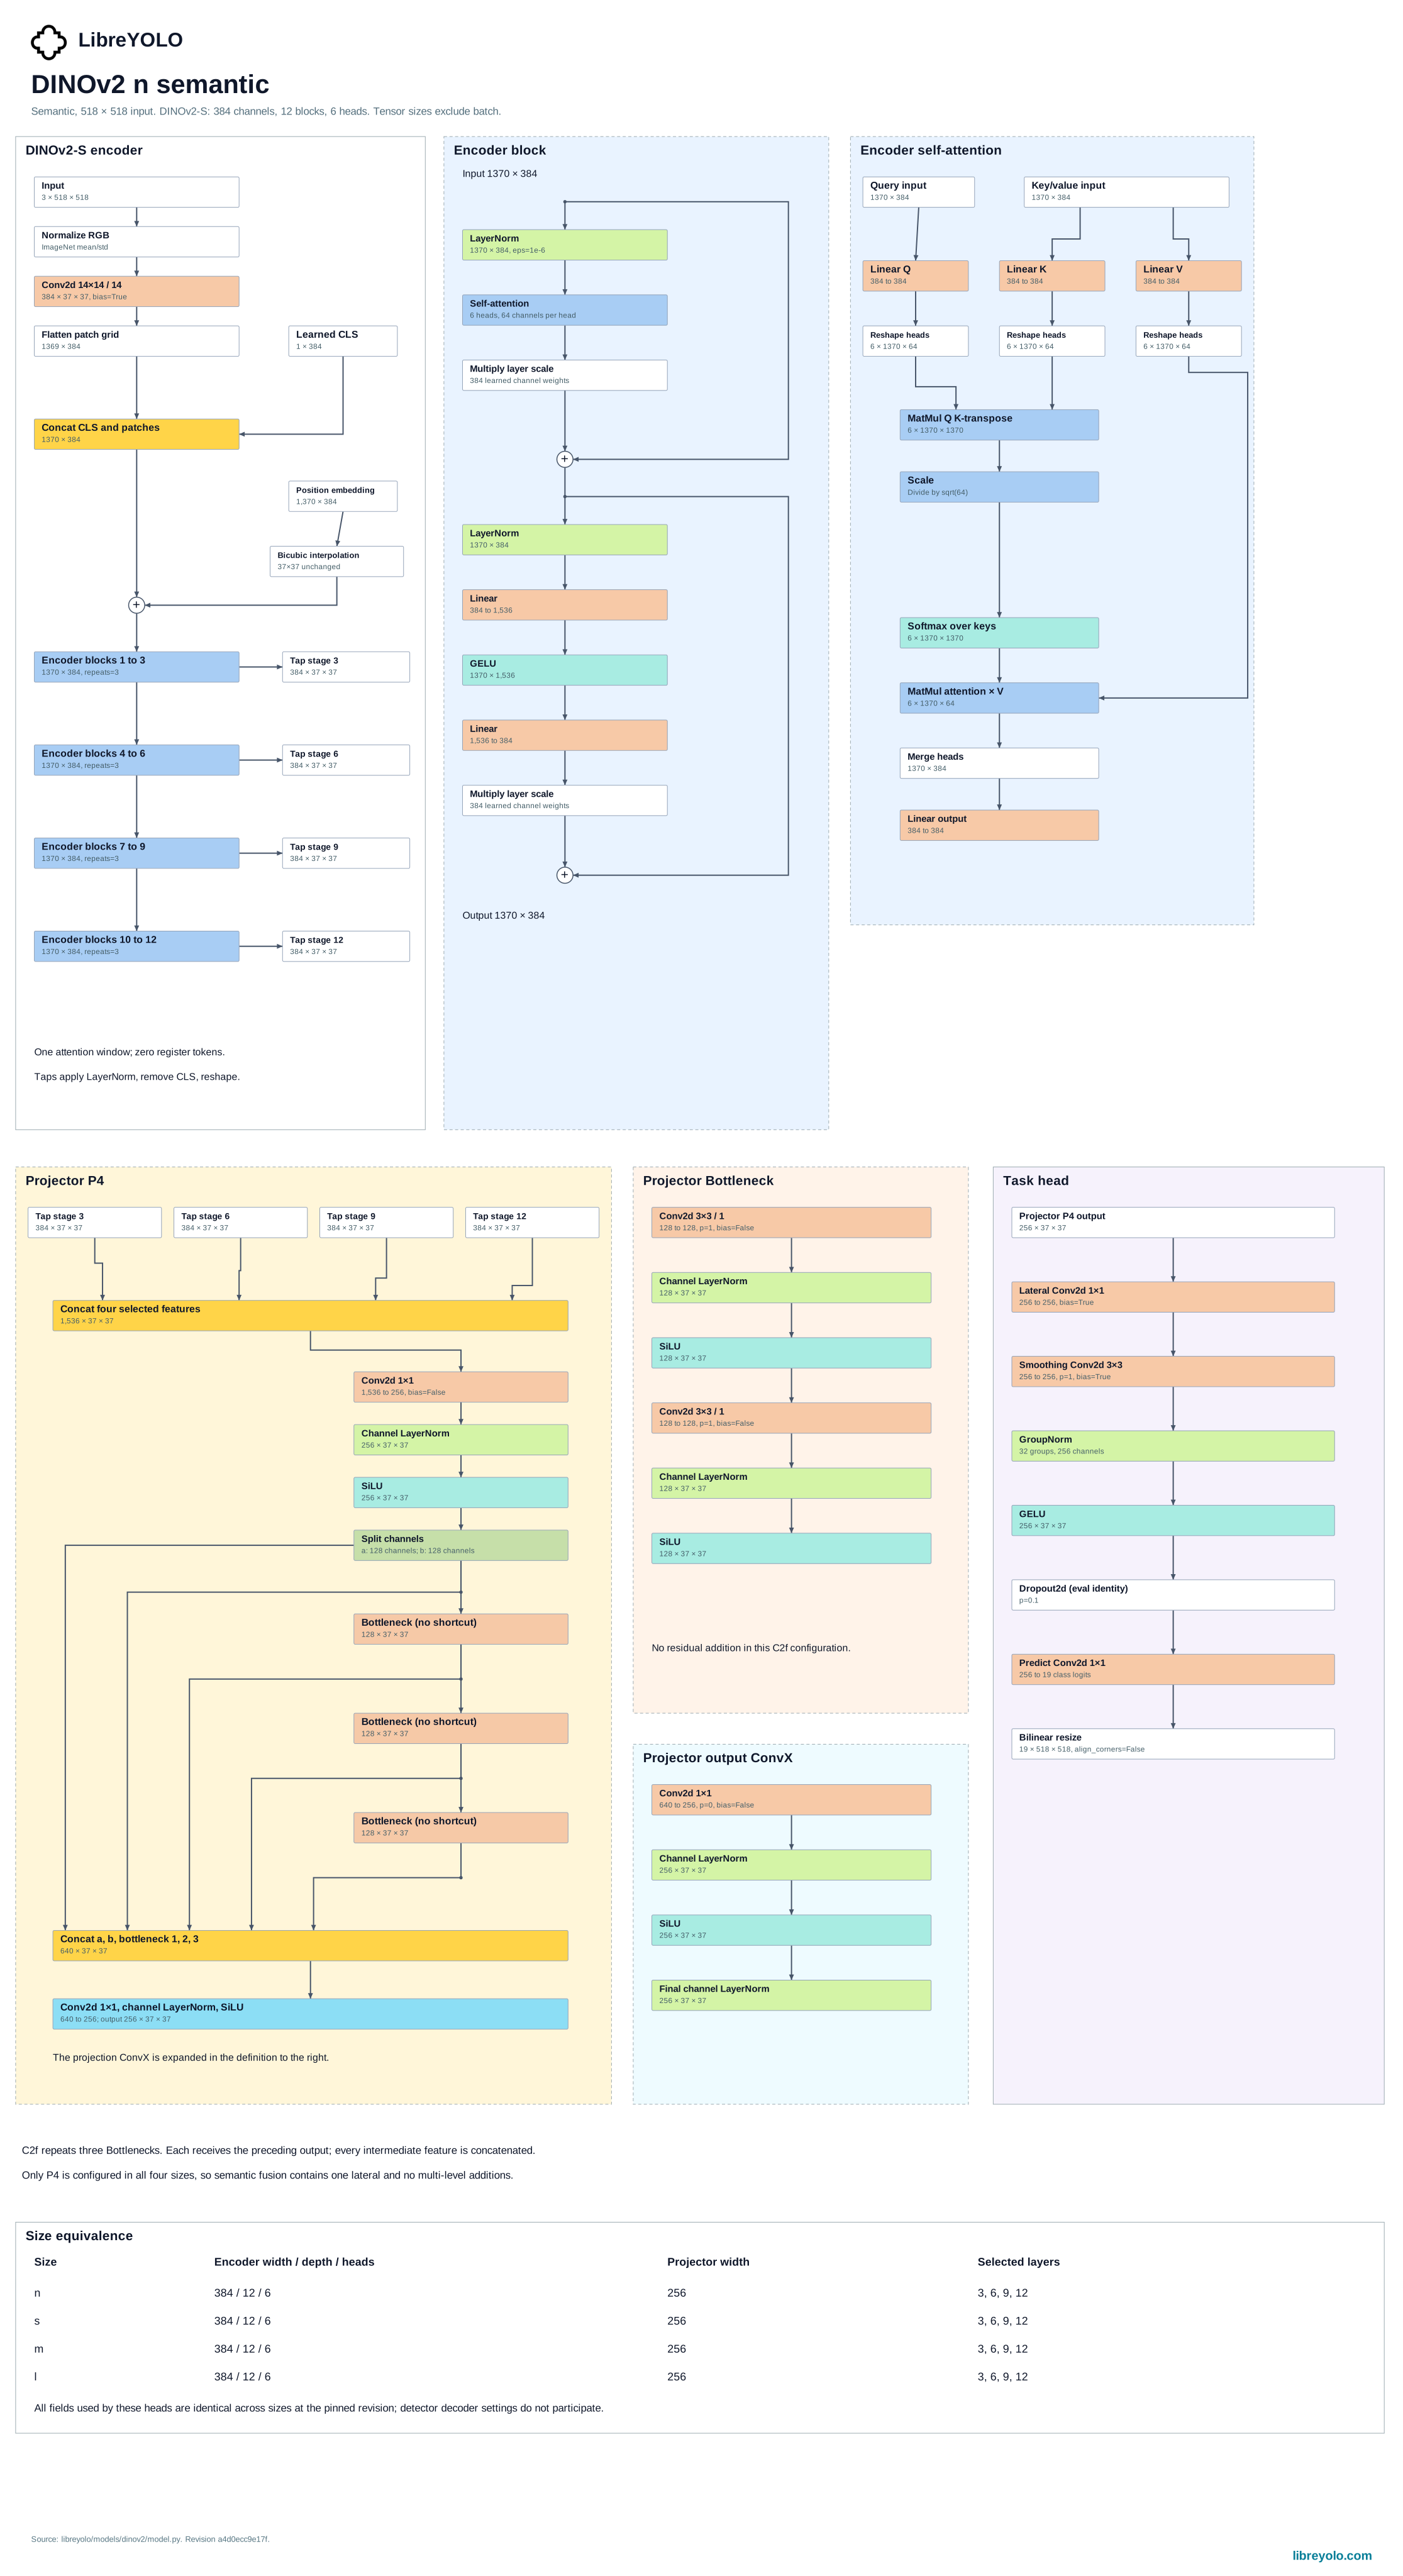
DINOv2 es un vision transformer autosupervisado entrenado por Meta AI para producir características de imagen de propósito general sin etiquetas. LibreYOLO envuelve su backbone DINOv2-with-Registers para tres tareas: segmentación semántica, clasificación y embedding de imagen completa.
- Tareas
- semantic segmentation, classification, embeddings
- Tamaños
- n, s, m, l at 518 px
- Instalación
pip install "libreyolo[rfdetr]"- Nivel de compatibilidad
- Compatible, desde v1.3.0. Modelos entrenables de apoyo: se mantienen operativos en CI y reciben funciones cuando surge la oportunidad.
- Licencias
- Código MIT, pesos Apache-2.0. Uso comercial
Instalación
LibreDINOv2 solo se registra cuando transformers está instalado, la misma
dependencia opcional que RF-DETR necesita para su backbone DINOv2, así que
necesita el mismo extra.
pip install "libreyolo[rfdetr]"Predicción
LibreYOLO no publica ningún checkpoint de LibreDINOv2. Construye el wrapper
directamente en lugar de cargar un archivo: model_path=None (el valor por
defecto) descarga en el primer uso el backbone
facebook/dinov2-with-registers-small de Meta, con licencia Apache-2.0, desde
Hugging Face. task= selecciona qué se ejecuta encima de él.
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # No existe ningún checkpoint alojado por LibreYOLO para esta familia:# esto descarga el backbone DINOv2-with-Registers-small con licencia# Apache-2.0 desde la organización de Meta en Hugging Face. La cabeza# densa arranca con inicialización aleatoria hasta que la entrenes# (ver Entrenamiento más abajo).model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= es el número de clases de tu dataset; la cabeza lineal# arranca con inicialización aleatoria hasta que la entrenes.model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Se salta todas las cabezas de tarea: el backbone por sí solo basta,# así que esto no necesita fine-tuning para ser útil.model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D), normalizado con L2from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # Envoltorio de conveniencia: ejecuta predict() y apila todas las filas# en un único tensor (N, D).features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" y task="classify" añaden una cabeza densa o lineal encima
del backbone; esa cabeza se inicializa de forma aleatoria y solo resulta útil
después de que la entrenes (ver Entrenamiento). task="embed" se
salta todas las cabezas y devuelve el token CLS final normalizado del backbone
como una única fila de imagen completa en result.embeddings, así que no
necesita entrenamiento alguno. result.boxes siempre es None: ninguna de las
tres tareas produce detecciones por instancia. Consulta
predicción para fuentes, streaming y manejo de resultados.
Variantes
size selecciona el ancho del proyector al estilo RF-DETR que se superpone al
backbone, no el backbone en sí: todos los tamaños comparten el mismo encoder
DINOv2-S (small). La segmentación semántica se ejecuta con la rejilla de
parches cuadrada nativa de DINOv2; la clasificación y el embedding se ejecutan
con la resolución de clasificación, más pequeña, que se usó para entrenar el
linear probe.
Entrenamiento
task="semantic" y task="classify" se entrenan ambos; task="embed" no tiene
ninguna cabeza dependiente de las clases que ajustar y lanza
NotImplementedError si llamas a train() sobre él.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)Los argumentos de palabra clave principales aquí son batch_size y lr, no
batch y lr0, que son los que usa la mayoría de las demás familias; batch y
lr0 se siguen aceptando y se mapean sobre ellos, pero pasar ambos lanza un
error de conflicto. output_dir= (por defecto None) sustituye a
project=/name= como forma principal de ubicar una ejecución, aunque pasar
project=/name= directamente sigue funcionando. Consulta
entrenamiento para datasets, aumento de datos, multi-GPU y
loggers.
Las ejecuciones nuevas se resuelven a un directorio runs/train/dinov2_exp incrementado con exist_ok=False. resume=True restaura el estado del trainer y conserva el directorio seleccionado. La clasificación soporta cls_pw y class_weights como se describe en hiperparámetros.
Validación
val() devuelve un diccionario de claves metrics/: mIoU y precisión por píxel
para task="semantic", y precisión top-1 y top-5 para task="classify".
task="embed" no tiene ground truth contra el que puntuar y lanza
NotImplementedError si llamas a val() sobre él.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])La calibración de clasificación y embeddings reutiliza el pipeline de clasificación del modelo. La evaluación usa la transformación de la familia.
Exportación
| Tarea | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX: compatible | Semantic segmentation to TorchScript: compatible | Semantic segmentation to ExecuTorch: compatible | Semantic segmentation to TensorRT: compatible | Semantic segmentation to OpenVINO: compatible | Semantic segmentation to Paddle: no compatible | Semantic segmentation to MNN: no compatible | Semantic segmentation to RKNN: no compatible | Semantic segmentation to ncnn: no compatible | Semantic segmentation to TFLite: no compatible | Semantic segmentation to CoreML: no compatible | Semantic segmentation to Core AI: no compatible |
| Classification | Classification to ONNX: compatible | Classification to TorchScript: compatible | Classification to ExecuTorch: compatible | Classification to TensorRT: compatible | Classification to OpenVINO: compatible | Classification to Paddle: no compatible | Classification to MNN: no compatible | Classification to RKNN: no compatible | Classification to ncnn: no compatible | Classification to TFLite: no compatible | Classification to CoreML: no compatible | Classification to Core AI: compatible |
| Embeddings | Embeddings to ONNX: compatible | Embeddings to TorchScript: compatible | Embeddings to ExecuTorch: compatible | Embeddings to TensorRT: compatible | Embeddings to OpenVINO: compatible | Embeddings to Paddle: no compatible | Embeddings to MNN: no compatible | Embeddings to RKNN: no compatible | Embeddings to ncnn: no compatible | Embeddings to TFLite: compatible | Embeddings to CoreML: no compatible | Embeddings to Core AI: no compatible |
Cada tarea soporta un subconjunto distinto de formatos, mostrado arriba. Un
artefacto exportado se vuelve a cargar con LibreYOLO() según su extensión de
archivo, así que un archivo .onnx o .engine se comporta como un checkpoint y
devuelve el mismo Results. Exportación enumera los argumentos
que acepta cada formato.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # La factoría enruta según la extensión del archivo, así que un# artefacto exportado se carga como cualquier checkpoint y devuelve el# mismo objeto Results. La exportación nombra el archivo a partir de la# tarea, aquí LibreDINOv2s-sem.onnx.model = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)Licencia
Comprueba la licencia en el repositorio de Hugging Face de los pesos concretos que descargues. Cada checkpoint de la organización de LibreYOLO incluye una, y no siempre es la misma en toda una familia. Ese repositorio es la fuente autorizada; el resumen siguiente describe qué se aplicaba cuando se verificó esta página por última vez.
Esta es una descripción de las licencias implicadas, no asesoramiento legal. Si la respuesta es importante a nivel comercial, lee las licencias y busca tu propio asesoramiento.
- Trabajo original
- DINOv2, Meta AI (FAIR)
- Licencia del proyecto original
- Apache-2.0
- Fuente del proyecto original
- github.com/facebookresearch/dinov2
- Código de LibreYOLO
- MIT
- Pesos
- Apache-2.0, distribuidos por sus autores. LibreYOLO no los aloja ni los replica.
- Interpretación
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
La fila "Weights" de arriba nombra la licencia que aplica, Apache-2.0, pero en
realidad no se republica nada bajo la organización de LibreYOLO en Hugging Face
para esta familia: LibreYOLO no aloja ningún checkpoint propio de LibreDINOv2.
Lo que descarga LibreDINOv2(model_path=None) es el repositorio
facebook/dinov2-with-registers-small de la propia Meta, sin tocar.
Cita
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
Copiado del bloque de cita de los autores en github.com/facebookresearch/dinov2#citing-dinov2.