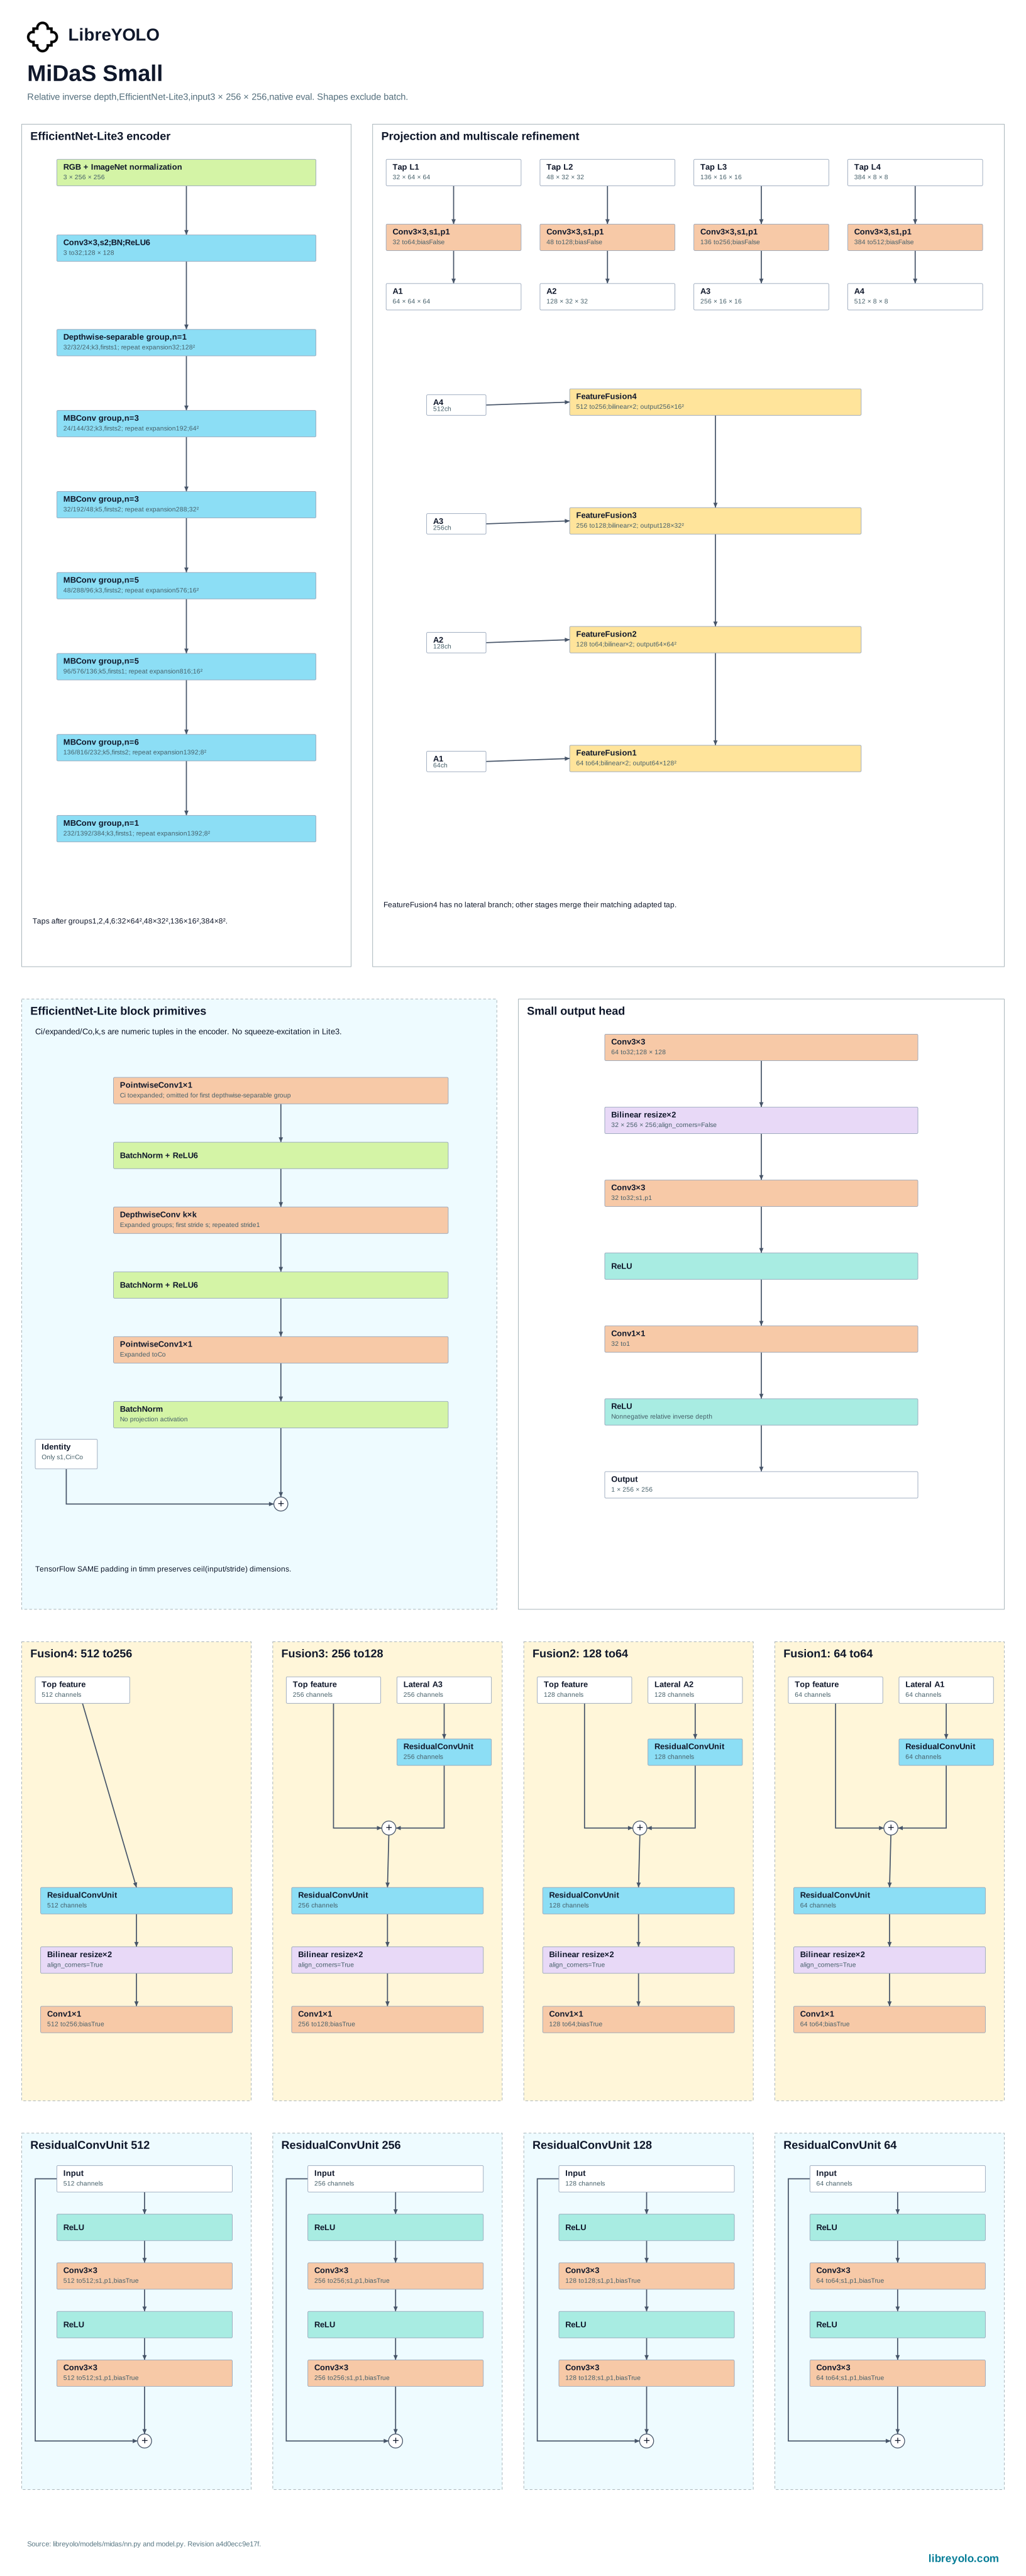
MiDaS
MiDaS es estimación de profundidad relativa monocular entrenada con una loss invariante a escala y desplazamiento sobre datasets mezclados, la línea de trabajo que estableció el protocolo de transferencia de profundidad zero-shot que reutilizan las familias posteriores. LibreYOLO lo soporta para la tarea de profundidad: predicción y validación zero-shot, sin ruta de entrenamiento.
- Tareas
- depth
- Tamaños
- s, l at 256 to 384 px
- Instalación
pip install "libreyolo[midas]"- Nivel de compatibilidad
- Solo inferencia, desde v1.5.0. Solo permite predecir, validar y exportar. Las funciones de entrenamiento no se aplican.
- Licencias
- Código MIT, pesos MIT. Uso comercial
Instalación
MiDaS necesita el extra midas para sus encoders de timm.
pip install "libreyolo[midas]"Predicción
Los checkpoints s y l se descargan de los mirrors de LibreYOLO bajo la licencia MIT del editor y se guardan en la caché local.
from libreyolo import LibreYOLO, SAMPLE_IMAGE # Descarga el checkpoint replicado en el primer uso.model = LibreYOLO("LibreMiDaSl-depth.pt")result = model(SAMPLE_IMAGE, save=True) depth = result.depth_mapprint(depth.min, depth.max, depth.mean)libreyolo predict model=LibreMiDaSl-depth.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Encoder EfficientNet-Lite3, más pequeño y rápido que el tamaño l, DPT-Large.model = LibreYOLO("LibreMiDaSs-depth.pt")result = model(SAMPLE_IMAGE, save=True)result.depth_map lleva un mapa denso de profundidad inversa relativa: los
valores más altos significan más cerca de la cámara, y los valores no tienen
unidad métrica ni escala común entre imágenes. save=True escribe en disco una
visualización de ese mapa con un mapa de color; Results.plot() renderiza el mapa de profundidad.
Consulta predicción para fuentes, streaming y manejo de
resultados.
Variantes
Dos variantes con encoders diferentes, no solo escalas distintas del mismo
encoder. s es MiDaS v2.1 Small, un encoder EfficientNet-Lite3. l es
DPT-Large, un encoder ViT-L/16 con el decoder DPT que MiDaS introdujo para
predicción densa. También preprocesan de forma distinta: s usa un redimensionado
con cota superior de aspecto y normalización con la media/desviación típica de
ImageNet, l usa un redimensionado de aspecto mínimo con media y desviación
típica de 0.5. Elige s para una CNN más ligera, l para la precisión del
decoder transformer.
El entrenamiento no se ofrece para esta familia. LibreMiDaS.train() lanza
NotImplementedError de forma incondicional.
Validación
val() ejecuta el validador de profundidad compartido: alinea cada predicción
con su ground truth mediante una escala y un desplazamiento por mínimos
cuadrados calculados para cada imagen, y después reporta las métricas estándar
de profundidad relativa zero-shot, AbsRel, RMSE y los tres umbrales delta.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/abs_rel"])print(metrics["metrics/rmse"])print(metrics["metrics/delta1"])libreyolo val model=LibreMiDaSl-depth.pt data=my-dataset.yamlExportación
| Tarea | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Depth | Depth to ONNX: compatible | Depth to TorchScript: compatible | Depth to ExecuTorch: compatible | Depth to TensorRT: compatible | Depth to OpenVINO: compatible | Depth to Paddle: no compatible | Depth to MNN: no compatible | Depth to RKNN: no compatible | Depth to ncnn: compatible | Depth to TFLite: no compatible | Depth to CoreML: no compatible | Depth to Core AI: no compatible |
Un artefacto exportado se vuelve a cargar con LibreYOLO() según su extensión
de archivo, así que un archivo .onnx o .engine se comporta como un
checkpoint y devuelve el mismo Results, con depth_map en lugar de boxes.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreMiDaSl-depth.pt format=onnxlibreyolo export model=LibreMiDaSl-depth.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # La factoría enruta según la extensión del archivo, así que un artefacto# exportado se carga como cualquier checkpoint y devuelve el mismo objeto Results.model = LibreYOLO("LibreMiDaSl-depth.onnx")result = model(SAMPLE_IMAGE) print(result.depth_map.data.shape)Licencia
Comprueba la licencia en el repositorio de Hugging Face de los pesos concretos que descargues. Cada checkpoint de la organización de LibreYOLO incluye una, y no siempre es la misma en toda una familia. Ese repositorio es la fuente autorizada; el resumen siguiente describe qué se aplicaba cuando se verificó esta página por última vez.
Esta es una descripción de las licencias implicadas, no asesoramiento legal. Si la respuesta es importante a nivel comercial, lee las licencias y busca tu propio asesoramiento.
- Trabajo original
- MiDaS, Intel Intelligent Systems Lab (Intel ISL)
- Licencia del proyecto original
- MIT
- Fuente del proyecto original
- github.com/isl-org/MiDaS
- Código de LibreYOLO
- MIT
- Pesos
- MIT, republicados en huggingface.co/LibreYOLO
- Interpretación
- The upstream repository and released weights declare MIT. LibreYOLO mirrors the s and l checkpoints under that publisher grant.
Cita
@ARTICLE {Ranftl2022,
    author  = "Ren\'{e} Ranftl and Katrin Lasinger and David Hafner and Konrad Schindler and Vladlen Koltun",
    title   = "Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-Shot Cross-Dataset Transfer",
    journal = "IEEE Transactions on Pattern Analysis and Machine Intelligence",
    year    = "2022",
    volume  = "44",
    number  = "3"
}

@article{Ranftl2021,
	author    = {Ren\'{e} Ranftl and Alexey Bochkovskiy and Vladlen Koltun},
	title     = {Vision Transformers for Dense Prediction},
	journal   = {ICCV},
	year      = {2021},
}
Copiado del bloque de cita de los autores en github.com/isl-org/MiDaS#citation.