YOLOv9
Un detector convolucional de una sola etapa: una pasada puntúa una rejilla densa de boxes y NMS descarta los duplicados. LibreYOLO incluye tres variantes, una de ellas sin paso de NMS.
- Tareas
- detection
- Tamaños
- yolo9: t, s, m, c at 640 px; yolo9_p2: t, s at 640 px
- Instalación
pip install libreyolo- Nivel de compatibilidad
- Emblemático, desde v1.0.0. Las funciones se diseñan y validan por completo en GPU primero aquí.
- Licencias
- Código MIT, pesos MIT. Uso comercial
Instalación
YOLOv9 no necesita ningún extra más allá del paquete base.
pip install libreyoloPredicción
Los pesos se descargan de Hugging Face en el primer uso y se guardan en la caché local.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreYOLO9s.pt")result = model(SAMPLE_IMAGE, save=True) for box in result.boxes: print(box.cls, box.conf, box.xyxy)libreyolo predict model=LibreYOLO9s.pt save=True \ source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpgfrom libreyolo import LibreYOLO, SAMPLE_IMAGE # La misma llamada, distinto checkpoint. La cabeza end-to-end devuelve sus# propias predicciones mejor puntuadas, así que no se ejecuta NMS y iou se ignora.model = LibreYOLO("LibreYOLO9E2Es.pt")result = model(SAMPLE_IMAGE, conf=0.25, max_det=300) print(len(result.boxes))El objeto Results devuelto es el mismo que devuelve cada familia, así que
cambiar a otro detector es un cambio de una línea. En los modelos base y de
stride 4, conf fija el umbral de confianza e iou el umbral de NMS. El modelo
end-to-end no ejecuta NMS e ignora iou, así que conf y max_det son lo que
da forma a su salida. Consulta predicción para fuentes,
streaming y manejo de resultados.
Variantes
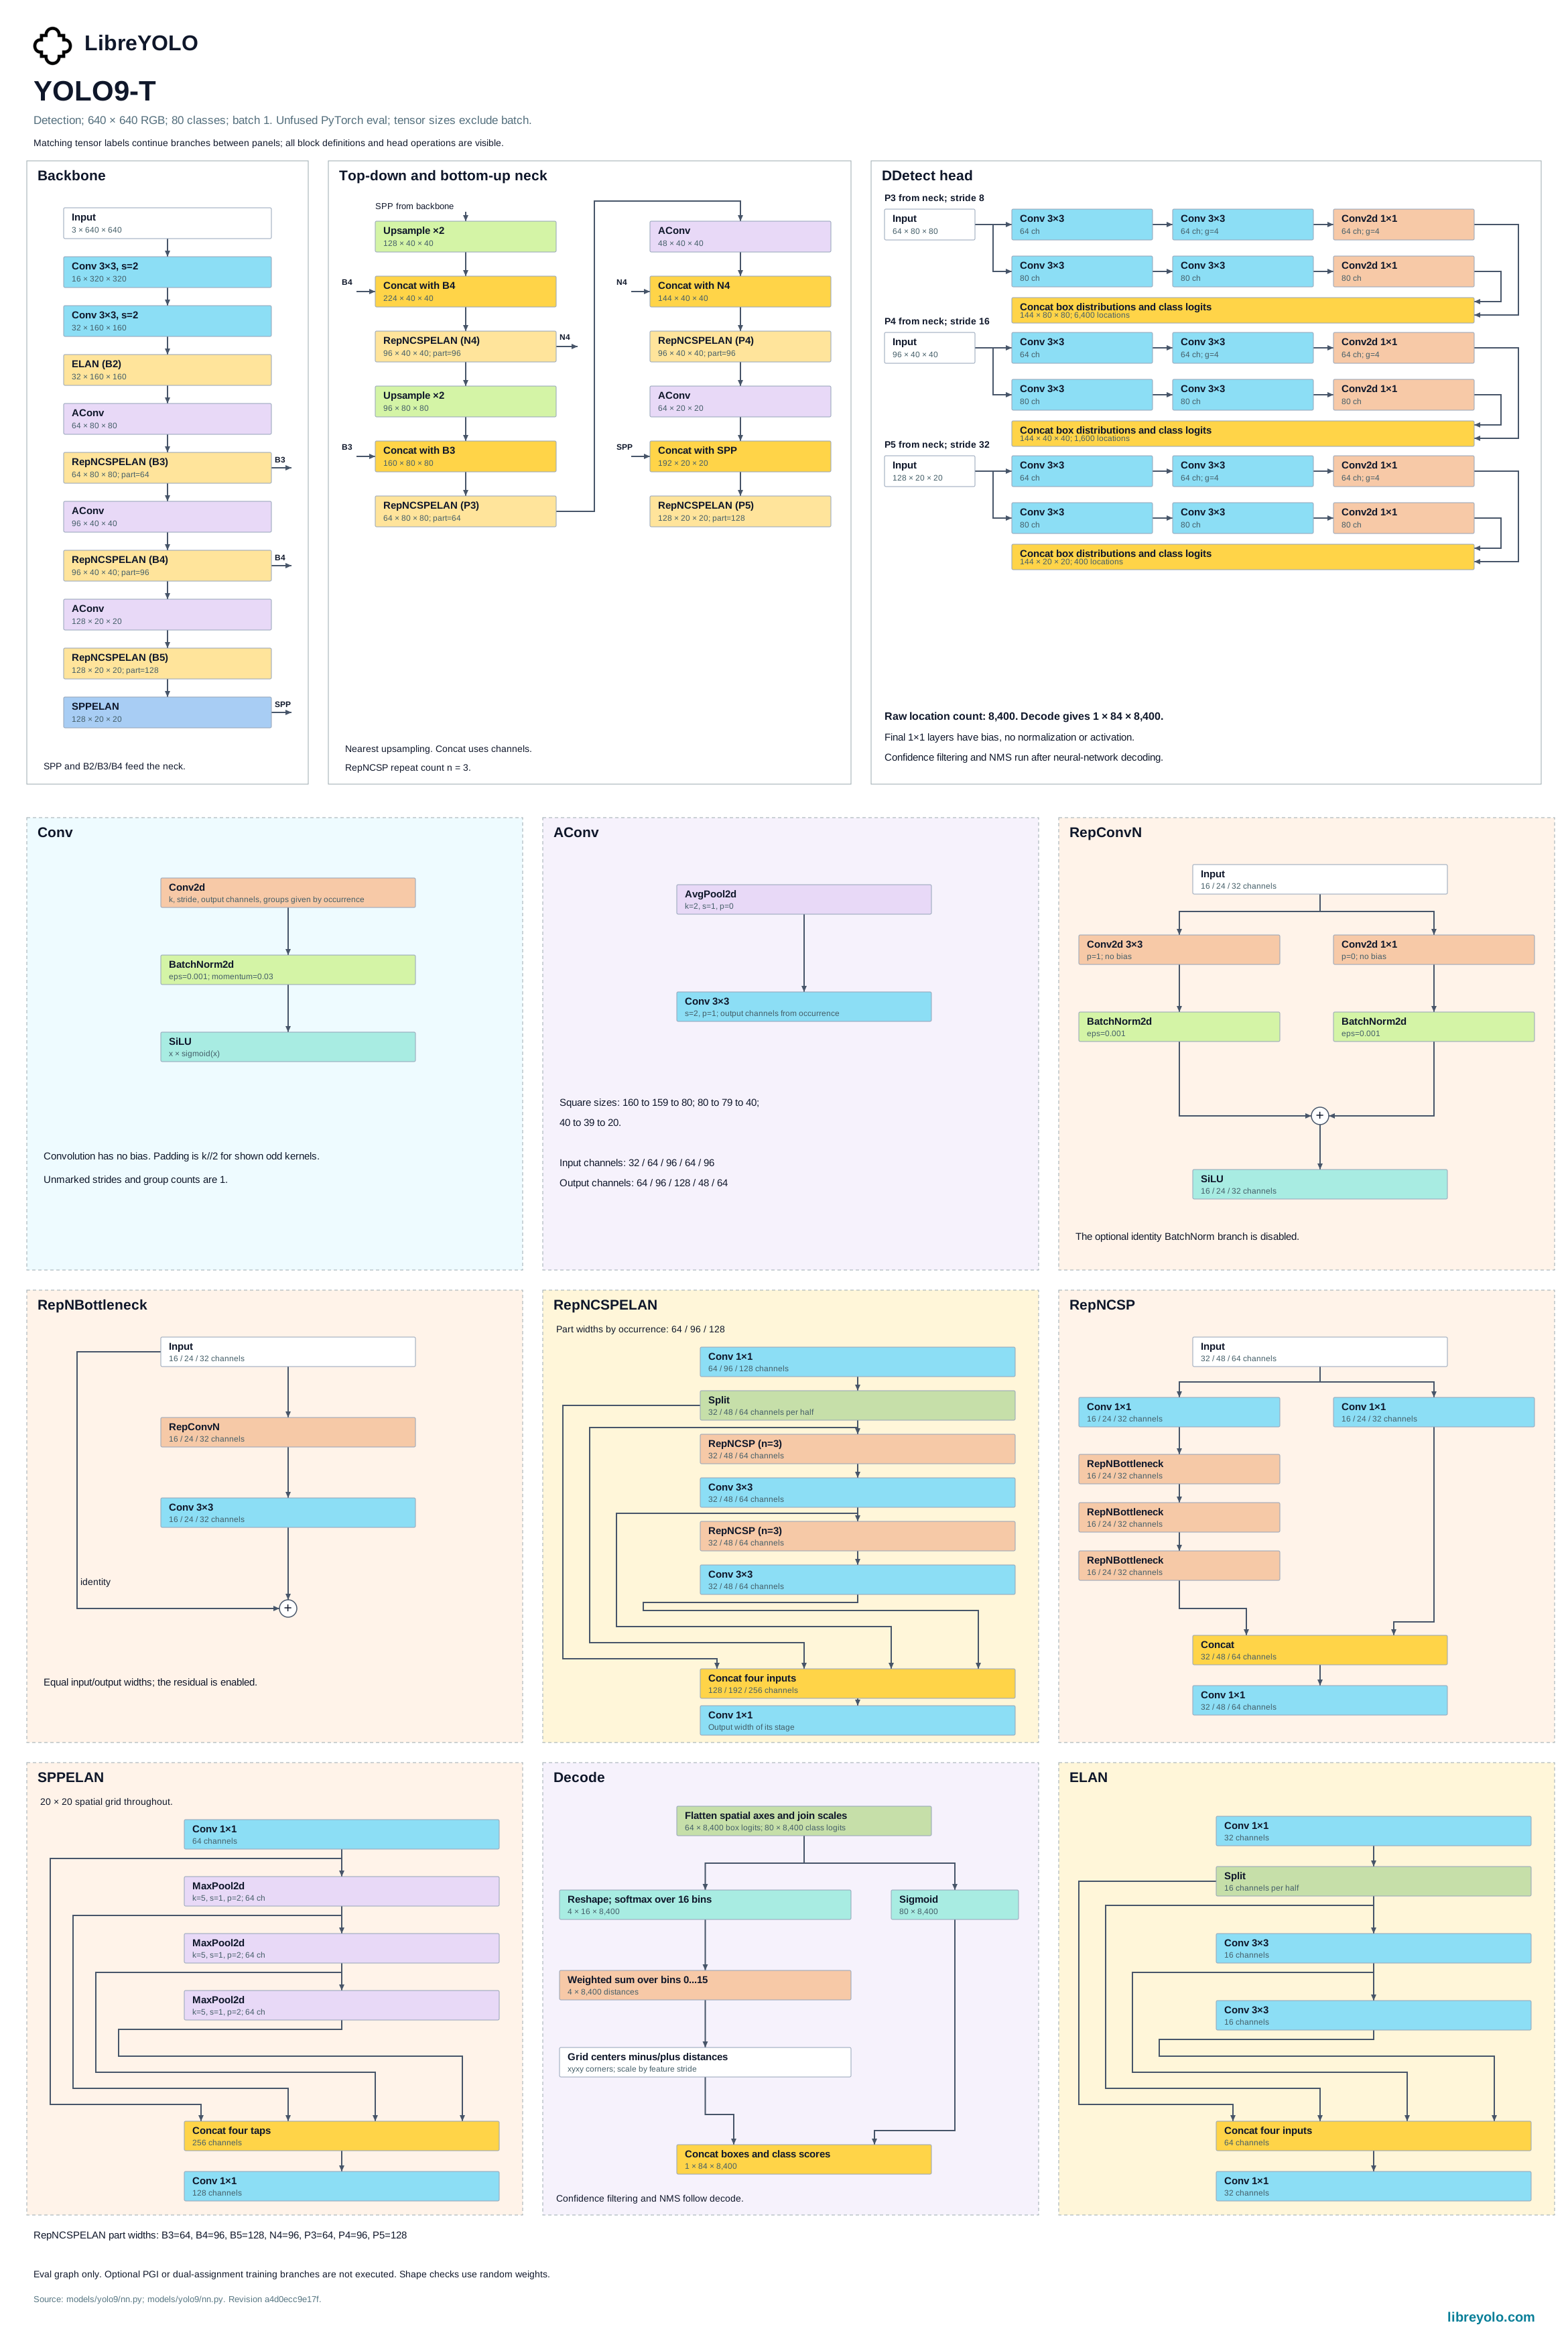
Tres variantes comparten un backbone. Las tres solo detectan, y aceptan los mismos argumentos.
El modelo base predice en tres escalas de características y elimina los boxes duplicados con NMS.
El modelo end-to-end conserva esa cabeza y añade junto a ella una rama de emparejamiento uno a uno. La inferencia lee únicamente la rama uno a uno y toma sus predicciones mejor puntuadas, así que no se ejecuta NMS. Elígelo cuando el runtime al que despliegas no tenga operador de NMS.
El modelo de stride 4 aflora un nivel más arriba del backbone, extiende el neck hasta él y predice en cuatro escalas en lugar de tres. La escala extra es para objetos que cubren pocos píxeles; el único checkpoint publicado para él está entrenado con imágenes aéreas. Los checkpoints de detección base se transfieren a él: el backbone y el neck se cargan sin cambios, las tres torres de cabeza preentrenadas se desplazan un puesto hacia arriba y la torre de stride 4 parte de una inicialización aleatoria.
| Checkpoint | Entrada (px) | mAP 50-95 | Parámetros (M) |
|---|---|---|---|
| LibreYOLO9c | 640 | 56.4 | 25.5 |
| LibreYOLO9m | 640 | 55.3 | 20.12 |
| LibreYOLO9s | 640 | 55.9 | 7.2 |
| LibreYOLO9t | 640 | 41.8 | 2.04 |
COCO val2017, 500 images. Medido con el sistema de benchmarks de LibreYOLO y publicado en Vision Analysis, donde se comparan la latencia entre distintos hardwares y runtimes y se conservan los registros completos de las ejecuciones.
Entrenamiento
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.train(data="my-dataset.yaml", epochs=100, imgsz=640, batch=16)libreyolo train model=LibreYOLO9s.pt data=my-dataset.yaml \ epochs=100 imgsz=640 batch=16from libreyolo import LibreYOLO9P2 # La variante de stride 4 no tiene checkpoint COCO propio, así que indica# uno de detección base: su backbone y su neck se cargan sin cambios y la# torre de la cabeza de stride 4 parte de una inicialización aleatoria.model = LibreYOLO9P2(None, size="s")model.train(data="my-dataset.yaml", epochs=100, pretrained="LibreYOLO9s.pt")pretrained decide desde dónde parte la ejecución. Pasa True para cargar el
checkpoint publicado del mismo modelo y tamaño, o un nombre o una ruta para
cualquier otra cosa. Los tensores cuya forma no coincide se omiten en lugar de
rechazarse, y la ejecución registra cuántos se cargaron, así que un checkpoint
entrenado con un número de clases distinto sigue siendo un punto de partida
utilizable.
El modelo de stride 4 no tiene checkpoint COCO publicado propio, así que True
se resuelve ahí en un archivo que no existe y la descarga falla. Indica en su
lugar un checkpoint de detección base.
Consulta entrenamiento para datasets, aumento de datos, multi-GPU y loggers.
El modelo base puede entrenar una rama auxiliar PGI junto a su cabeza principal.
La rama es exclusiva del entrenamiento: la predicción y la exportación usan la
cabeza principal. Una ejecución la añade cuando los pesos de partida traen
tensores PGI o cuando entrena desde cero. Los checkpoints base publicados no
traen ninguno, así que un fine-tuning a partir de ellos entrena solo la cabeza
principal y lo registra en el log. aux_weight=0.25 añade de todos modos una rama
nueva con ese peso de loss, y aux_weight=0 la mantiene desactivada. Una
ejecución reanudada conserva la configuración PGI de su checkpoint. En los
tamaños m y c la rama es la original: un segundo backbone sobre la imagen de
entrada, cuyas etapas CBFuse suma con tomas CBLinear del backbone principal, y
su propia cabeza, con 12.8M y 25.7M de parámetros exclusivos del entrenamiento con
80 clases. Los modelos end-to-end y de stride 4 no tienen rama PGI.
Las tres variantes recortan la norma L2 del gradiente a 10 antes de cada paso del
optimizador; clip_max_norm=0 desactiva el recorte. La asignación de etiquetas
puntúa los anchors en fp32, también bajo autocast en float16. max_labels=300
limita los boxes que se conservan por imagen de entrenamiento, y los que superan
ese tope se descartan con un aviso único; la memoria de asignación sigue los boxes
reales de cada imagen, no el tope. El momentum de SGD aumenta de 0.8 a 0.937
durante tres épocas de calentamiento. letterbox_pad=None hereda la marca del
checkpoint: los pesos sin marca usan topleft, mientras que las nuevas
conversiones oficiales registran center.
El mosaic de YOLO9 y YOLOX prefiere imágenes acompañantes con anotaciones y realiza un máximo de 20 intentos; MixUp de YOLO9 usa la misma política. MixUp está desactivado por defecto (mixup_prob=0). Cuando está activado, la proporción de mezcla se toma de Beta(1, 1), uniforme en [0, 1], como en MultimediaTechLab/YOLO. Consulta histogramas de eventos para perfiles de entrada que no sean RGB.
Validación
val() devuelve un diccionario de claves metrics/ que cubren precisión,
recall, mAP 50 y mAP 50-95, medidas contra cualquier dataset en el formato con
el que entrenaste.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mAP50-95"])print(metrics["metrics/mAP50"])libreyolo val model=LibreYOLO9s.pt data=my-dataset.yaml# El yaml de COCO incluido lleva un script de descarga embebido, así que# necesita permiso explícito salvo que el dataset ya esté en local.libreyolo val model=LibreYOLO9c.pt data=coco.yaml imgsz=640 \ allow_download_scripts=TrueExportación
| Tarea | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Detection | Detection to ONNX: compatible | Detection to TorchScript: compatible | Detection to ExecuTorch: compatible | Detection to TensorRT: compatible | Detection to OpenVINO: compatible | Detection to Paddle: compatible | Detection to MNN: compatible | Detection to RKNN: no compatible | Detection to ncnn: compatible | Detection to TFLite: no compatible | Detection to CoreML: no compatible | Detection to Core AI: compatible |
Una marca vale para las tres variantes: donde difieren, la matriz recoge la más débil de las tres.
Un artefacto exportado se vuelve a cargar a través de LibreYOLO() por su
sufijo de archivo, así que un archivo .onnx o .engine se comporta como un
checkpoint y devuelve el mismo Results. Ejecutar el grafo en un runtime
desnudo, sin LibreYOLO instalado, también está soportado, pero entonces el
preprocesamiento y el postprocesamiento corren de tu cuenta.
Para el modelo de detección base, la mitad de postprocesamiento puede moverse
al grafo. nms=True en una exportación a ONNX mete la supresión dentro del
modelo, y la primera salida pasa a ser un tensor fijo (1, max_det, 6) cuyas
filas son x1, y1, x2, y2, score, class, rellenadas con ceros más allá del
número de detecciones. Ese grafo es de batch 1 y no lleva ejes dinámicos. Los
modelos end-to-end y de stride 4 no aceptan el flag.
Cada formato instala un extra distinto y acepta unos pocos argumentos propios. Ambas cosas están en la página de ese formato.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.export(format="onnx", imgsz=640)libreyolo export model=LibreYOLO9s.pt format=onnx imgsz=640libreyolo export model=LibreYOLO9s.pt format=onnx nms=True \ conf=0.25 iou=0.45 max_det=300from libreyolo import LibreYOLO, SAMPLE_IMAGE # La factoría enruta según el sufijo del archivo, así que un artefacto# exportado se carga como cualquier checkpoint y devuelve el mismo objeto Results.model = LibreYOLO("LibreYOLO9s.onnx")result = model(SAMPLE_IMAGE) print(result.boxes.xyxy)TFLite INT8 usa int8=True con datos de calibración.
Entradas y salidas ONNX
LibreYOLO9
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Color | RGB |
| Escalado | píxel / 255 |
| Normalización | ninguna |
| Redimensionado | letterbox, bilinear, valor de relleno 114, posición del relleno según la clave de metadatos letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
Detection, exportación por defecto
| Salida | Forma | Significado |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Posprocesado
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Detection, nms=True
| Salida | Forma | Significado |
|---|---|---|
output | [1, max_det, 6] | Rows are x1, y1, x2, y2, score, class in input-canvas pixels, zero-padded past the detection count. Confidence, IoU and max_det are baked in and recorded as nms_conf, nms_iou and max_det metadata. |
raw | [1, 4 + nc, anchors] | The same tensor as the default export's output, before suppression. |
Posprocesado
- Drop rows whose score is 0 or below your threshold.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
LibreYOLO9E2E
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Color | RGB |
| Escalado | píxel / 255 |
| Normalización | ninguna |
| Redimensionado | letterbox, bilinear, valor de relleno 114, posición del relleno según la clave de metadatos letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, exportación por defecto
| Salida | Forma | Significado |
|---|---|---|
output | [batch, 4 + nc, anchors] | Predictions of the one-to-one head only. Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Posprocesado
- Transpose to [anchors, 4 + nc].
- Flatten the [anchors, nc] scores into one list of anchors x nc (anchor, class) pairs. Pair i belongs to anchor i / nc (integer division) and class i % nc.
- Keep the 300 highest-scoring pairs (max_det), highest first. One anchor can yield several classes.
- Of those, keep the pairs whose score is above the confidence threshold (0.25 by default).
- Do not run NMS. The one-to-one head is trained to fire once per object, and LibreYOLO ignores the iou setting for this model.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
LibreYOLO9P2
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Color | RGB |
| Escalado | píxel / 255 |
| Normalización | ninguna |
| Redimensionado | letterbox, bilinear, valor de relleno 114, posición del relleno según la clave de metadatos letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, exportación por defecto
| Salida | Forma | Significado |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 4, 8, 16 and 32, 34000 at 640 x 640. nc is 10 for LibreYOLO9P2s-visdrone. |
Posprocesado
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Para comprobar tu propia implementación, pasa el mismo archivo por LibreYOLO: LibreYOLO("model.onnx").predict("image.jpg") devuelve los resultados de referencia. Verificado con LibreYOLO 1.7.0.
Checkpoints
Todos los archivos de pesos publicados de esta familia.
| Archivo | Entrada (px) | Licencia de los pesos |
|---|---|---|
| Detection | ||
| LibreYOLO9t.pt | 640 | mit |
| LibreYOLO9s.pt | 640 | mit |
| LibreYOLO9m.pt | 640 | mit |
| LibreYOLO9c.pt | 640 | mit |
| LibreYOLO9E2Et.pt | 640 | mit |
| LibreYOLO9E2Es.pt | 640 | mit |
| LibreYOLO9E2Em.pt | 640 | mit |
| LibreYOLO9E2Ec.pt | 640 | mit |
| LibreYOLO9P2s-visdrone.pt | cc-by-nc-sa-3.0 | |
Todos los archivos anteriores existen hoy en la organización de LibreYOLO y se descargan la primera vez que se usan.
Licencia
Comprueba la licencia en el repositorio de Hugging Face de los pesos concretos que descargues. Cada checkpoint de la organización de LibreYOLO incluye una, y no siempre es la misma en toda una familia. Ese repositorio es la fuente autorizada; el resumen siguiente describe qué se aplicaba cuando se verificó esta página por última vez.
Esta es una descripción de las licencias implicadas, no asesoramiento legal. Si la respuesta es importante a nivel comercial, lee las licencias y busca tu propio asesoramiento.
- Trabajo original
- YOLOv9, MultimediaTechLab
- Licencia del proyecto original
- MIT
- Fuente del proyecto original
- github.com/MultimediaTechLab/YOLO
- Código de LibreYOLO
- MIT
- Pesos
- MIT, republicados en huggingface.co/LibreYOLO
- Interpretación
- MIT is a permissive license, so these weights can be used in commercial and closed-source products. The one standing obligation is to keep the license text and the copyright notice, Kin-Yiu Wong and Hao-Tang Tsui, with any copy you redistribute. It places no condition on your own application code, and a model you train yourself on your own data is yours. Two things are worth knowing beyond that. The code is ported from the authors' MIT re-release of YOLOv9, MultimediaTechLab/YOLO at commit c4cb5f6f, not the GPL-3.0 repository that carries the same model, so the permissive terms come from the source LibreYOLO actually derives from. And one checkpoint in this family is not MIT: the weight repository of the stride-4 VisDrone model, LibreYOLO9P2s-visdrone.pt, declares CC BY-NC-SA 3.0, which rules out commercial use and requires share-alike on derivatives.
El código de las tres variantes está portado de
MultimediaTechLab/YOLO en el commit
c4cb5f6f (MIT). El predictor uno a uno del modelo end-to-end sigue el diseño de
DATE de Yiqun Chen (Apache-2.0),
implementado para LibreYOLO sin copiar código de DATE. El nivel de stride 4 es
código de LibreYOLO.
El checkpoint aéreo de stride 4 predice las clases de VisDrone. Usa la licencia declarada por el editor y registrada en el repositorio de sus pesos.
Cita
@inproceedings{wang2024yolov9,
      title={{YOLOv9}: Learning What You Want to Learn Using Programmable Gradient Information},
      author={Wang, Chien-Yao and Yeh, I-Hau and Liao, Hong-Yuan Mark},
      year={2024},
      booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
}
Copiado del bloque de cita de los autores en github.com/MultimediaTechLab/YOLO#citations.