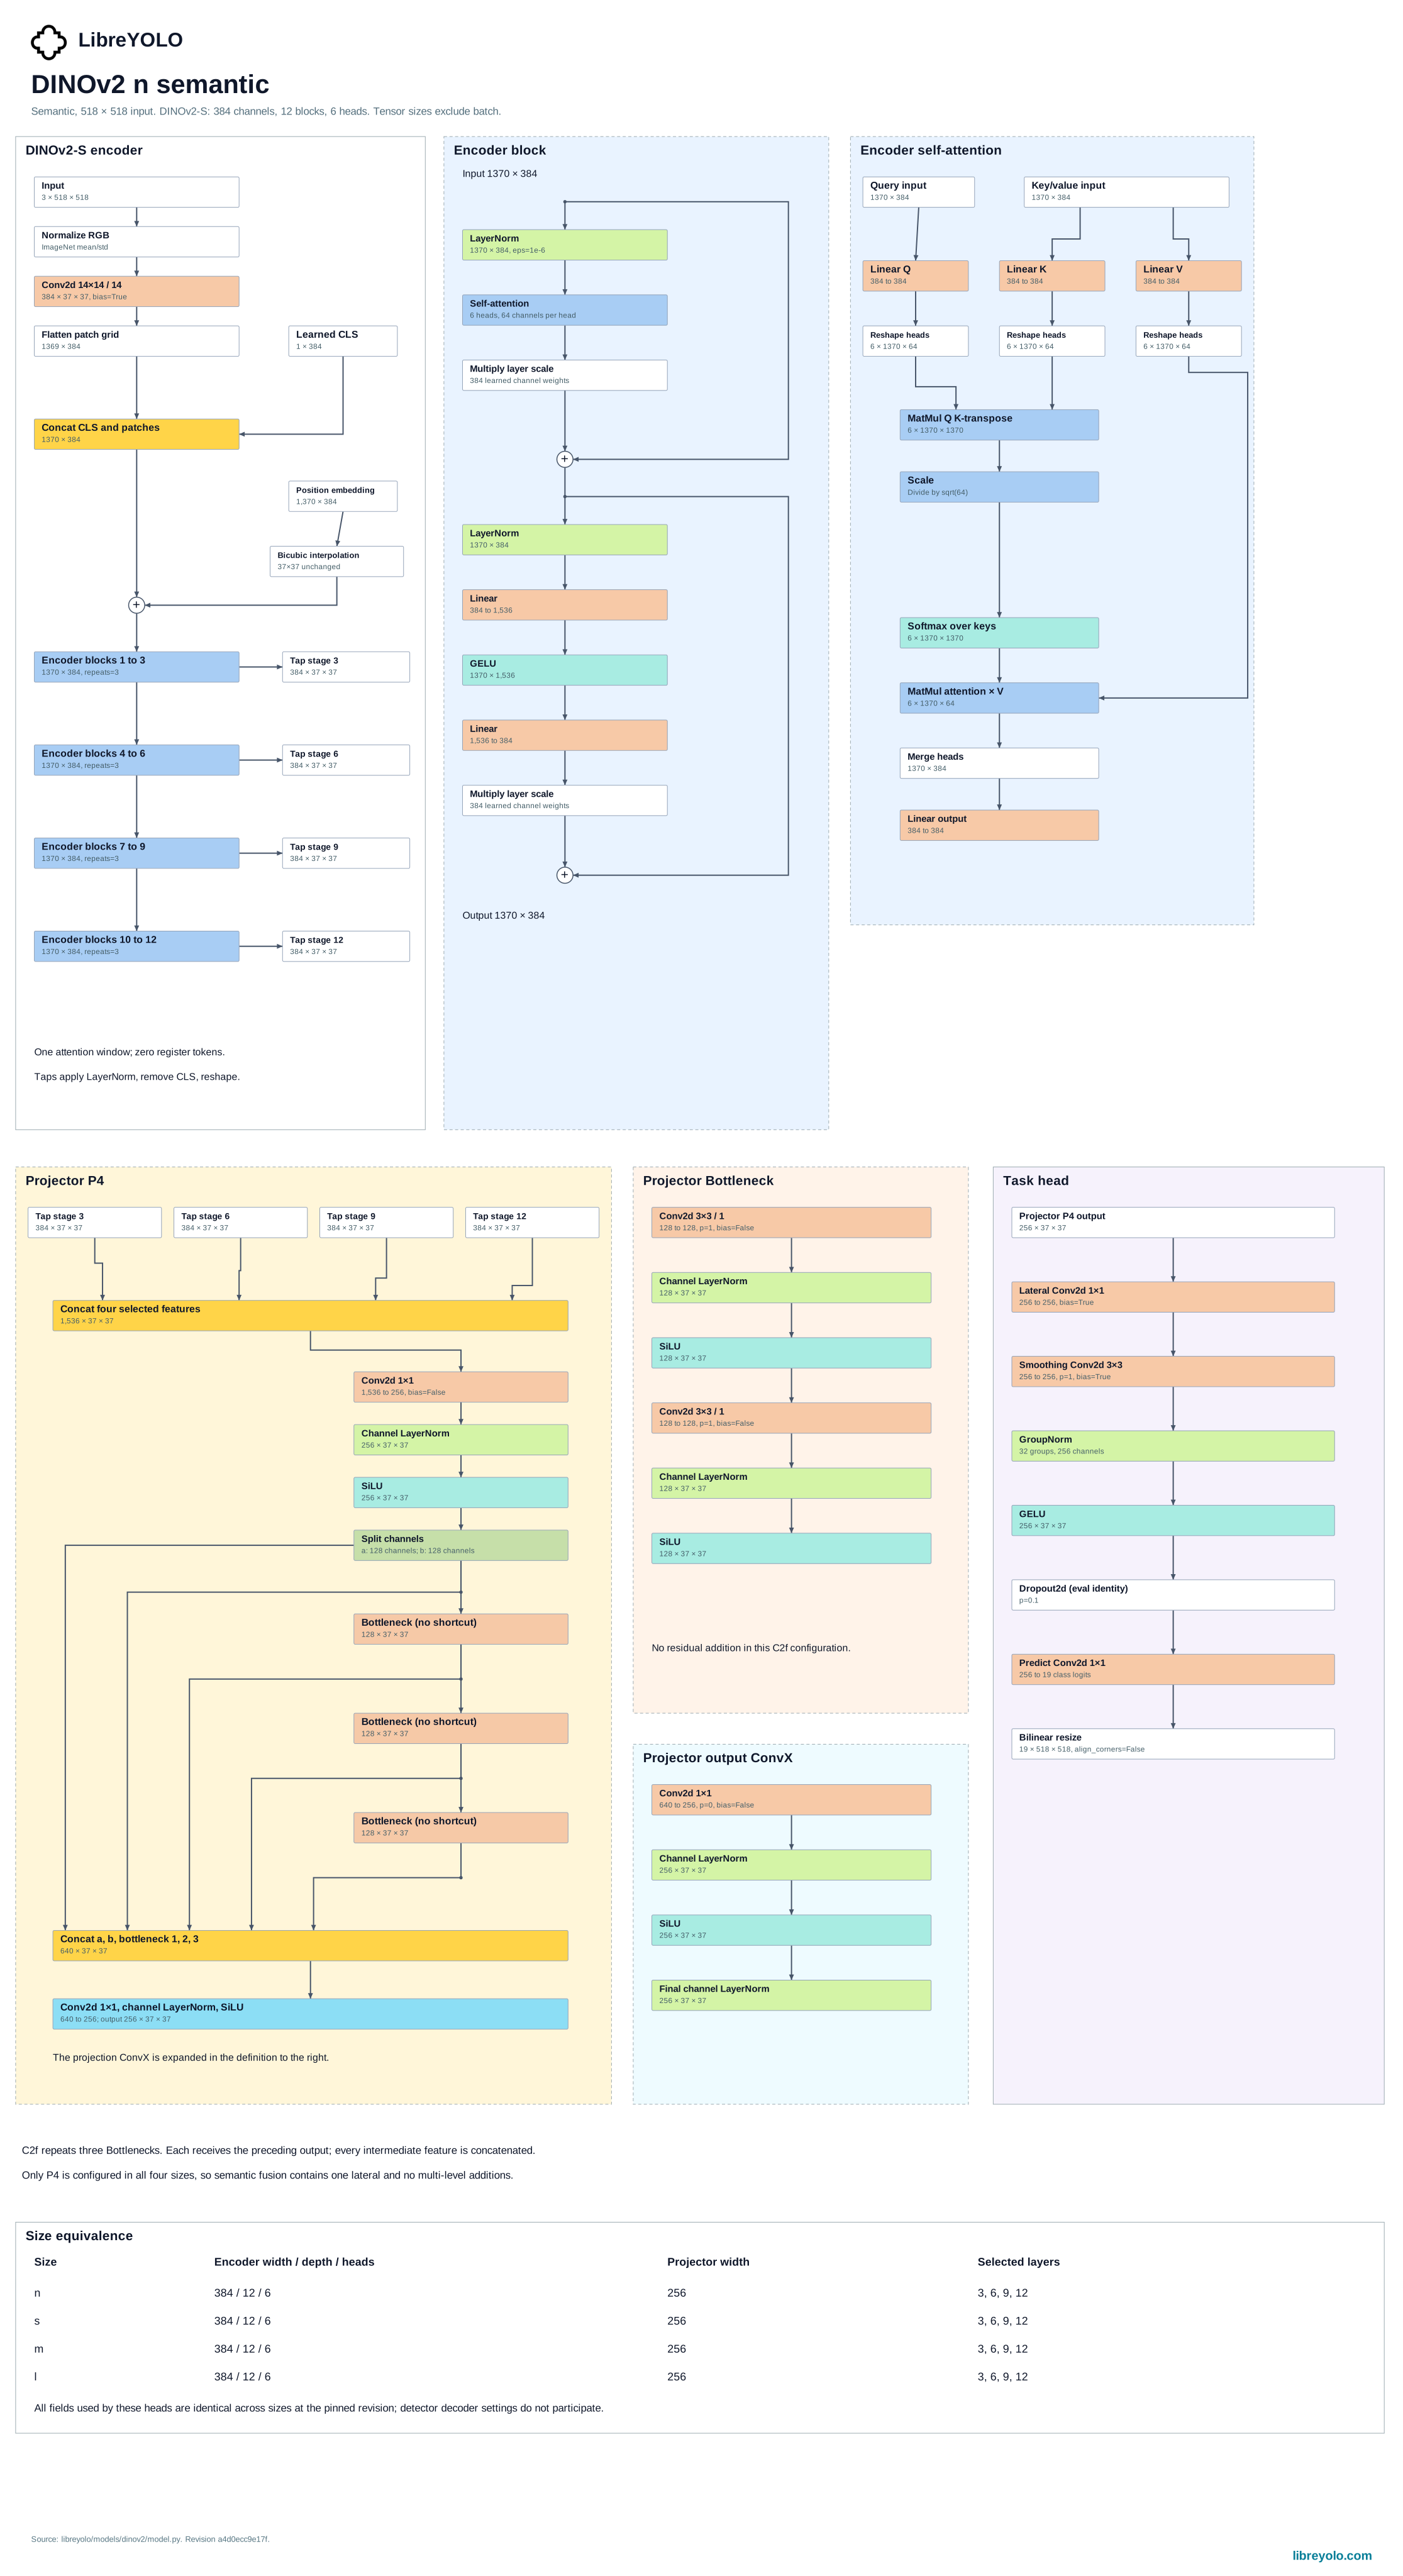
DINOv2
DINOv2 adalah vision transformer self-supervised yang dilatih oleh Meta AI untuk menghasilkan fitur gambar serbaguna tanpa label. LibreYOLO membungkus backbone DINOv2-with-Registers untuk tiga task: segmentasi semantik, klasifikasi, dan embedding seluruh gambar.
- Task
- semantic segmentation, classification, embeddings
- Ukuran
- n, s, m, l at 518 px
- Instalasi
pip install "libreyolo[rfdetr]"- Tier dukungan
- Didukung, sejak v1.3.0. Model pendukung yang dapat dilatih: CI dijaga tetap lulus, fitur ditambahkan saat ada kesempatan.
- Lisensi
- Kode MIT, bobot Apache-2.0. Penggunaan komersial
Instalasi
LibreDINOv2 hanya terdaftar saat transformers terpasang. Ini adalah dependency
opsional yang juga diperlukan RF-DETR untuk backbone DINOv2, sehingga extra yang
diperlukan pun sama.
pip install "libreyolo[rfdetr]"Prediksi
LibreYOLO tidak memublikasikan checkpoint LibreDINOv2. Buat wrapper secara
langsung alih-alih memuat berkas: model_path=None (default) mengunduh backbone
facebook/dinov2-with-registers-small berlisensi Apache-2.0 milik Meta dari
Hugging Face saat pertama kali digunakan. task= memilih apa yang dijalankan
di atasnya.
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Tidak ada checkpoint yang dihosting LibreYOLO untuk family ini. Kode ini# mengunduh backbone DINOv2-with-Registers-small berlisensi Apache-2.0 dari# organisasi Hugging Face milik Meta. Head padat dimulai dengan# inisialisasi acak sampai model dilatih (lihat Pelatihan di bawah).model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= adalah jumlah kelas dataset Anda. Head linear dimulai# dengan inisialisasi acak sampai model dilatih.model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Melewati setiap head task. Backbone saja sudah cukup, sehingga# fine-tuning tidak diperlukan agar berguna.model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D), dinormalisasi L2from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # Wrapper praktis: menjalankan predict() dan menumpuk setiap baris menjadi satu# tensor (N, D).features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" dan task="classify" menambahkan head padat atau linear di
atas backbone. Head tersebut diinisialisasi secara acak dan hanya berguna
setelah dilatih (lihat Pelatihan). task="embed" melewati setiap
head dan mengembalikan token CLS terakhir backbone yang telah dinormalisasi
sebagai satu baris seluruh gambar dalam result.embeddings, sehingga tidak
memerlukan pelatihan sama sekali. result.boxes selalu None: tidak satu pun
dari ketiga task menghasilkan deteksi per instance. Lihat
prediksi untuk sumber, streaming, dan penanganan hasil.
Varian
size memilih lebar projector bergaya RF-DETR yang dilapiskan di atas backbone,
bukan backbone itu sendiri. Setiap ukuran memakai encoder DINOv2-S (small) yang
sama. Segmentasi semantik berjalan pada grid patch persegi native DINOv2,
sedangkan klasifikasi dan embedding berjalan pada resolusi klasifikasi lebih
kecil yang digunakan untuk melatih linear probe.
Pelatihan
task="semantic" dan task="classify" dapat dilatih. task="embed" tidak
memiliki head yang bergantung pada kelas untuk di-fit dan memunculkan
NotImplementedError jika train() dipanggil padanya.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)Argumen kata kunci utama di sini adalah batch_size dan lr, bukan batch dan lr0 yang dipakai kebanyakan family lain; batch dan lr0 masih diterima dan dipetakan ke keduanya, tetapi memberikan keduanya sekaligus menimbulkan galat konflik. output_dir= (default None) menggantikan project=/name= sebagai cara utama menentukan lokasi proses, meskipun memberikan project=/name= secara langsung masih berfungsi. Lihat pelatihan untuk dataset, augmentasi, multi-GPU, dan logger.
Proses baru memakai direktori runs/train/dinov2_exp bernomor dengan exist_ok=False. resume=True memulihkan status trainer dan mempertahankan direktori proses yang dipilih. Klasifikasi mendukung cls_pw dan class_weights seperti dijelaskan dalam hiperparameter.
Validasi
val() mengembalikan dictionary key metrics/: mIoU dan akurasi piksel untuk
task="semantic", serta akurasi top-1 dan top-5 untuk task="classify".
task="embed" tidak memiliki ground truth sebagai pembanding skor dan
memunculkan NotImplementedError jika val() dipanggil padanya.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])Kalibrasi klasifikasi dan embedding memakai kembali pipeline klasifikasi model. Evaluasi memakai transformasi family.
Ekspor
| Task | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX: didukung | Semantic segmentation to TorchScript: didukung | Semantic segmentation to ExecuTorch: didukung | Semantic segmentation to TensorRT: didukung | Semantic segmentation to OpenVINO: didukung | Semantic segmentation to Paddle: tidak didukung | Semantic segmentation to MNN: tidak didukung | Semantic segmentation to RKNN: tidak didukung | Semantic segmentation to ncnn: tidak didukung | Semantic segmentation to TFLite: tidak didukung | Semantic segmentation to CoreML: tidak didukung | Semantic segmentation to Core AI: tidak didukung |
| Classification | Classification to ONNX: didukung | Classification to TorchScript: didukung | Classification to ExecuTorch: didukung | Classification to TensorRT: didukung | Classification to OpenVINO: didukung | Classification to Paddle: tidak didukung | Classification to MNN: tidak didukung | Classification to RKNN: tidak didukung | Classification to ncnn: tidak didukung | Classification to TFLite: tidak didukung | Classification to CoreML: tidak didukung | Classification to Core AI: didukung |
| Embeddings | Embeddings to ONNX: didukung | Embeddings to TorchScript: didukung | Embeddings to ExecuTorch: didukung | Embeddings to TensorRT: didukung | Embeddings to OpenVINO: didukung | Embeddings to Paddle: tidak didukung | Embeddings to MNN: tidak didukung | Embeddings to RKNN: tidak didukung | Embeddings to ncnn: tidak didukung | Embeddings to TFLite: didukung | Embeddings to CoreML: tidak didukung | Embeddings to Core AI: tidak didukung |
Setiap task mendukung subset format yang berbeda, seperti ditampilkan di atas.
Artefak hasil ekspor dapat dimuat kembali melalui LibreYOLO() berdasarkan
akhiran berkasnya, sehingga berkas .onnx atau .engine berperilaku seperti
checkpoint dan mengembalikan Results yang sama. Ekspor
mencantumkan argumen yang diterima oleh setiap format.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # Factory merutekan berdasarkan akhiran berkas, sehingga artefak hasil ekspor dimuat# seperti checkpoint lain dan mengembalikan objek Results yang sama. Ekspor# menamai berkas berdasarkan task, dalam contoh ini LibreDINOv2s-sem.onnx.model = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)Lisensi
Periksa lisensi di repositori Hugging Face untuk bobot tertentu yang diunduh. Setiap checkpoint di organisasi LibreYOLO memiliki lisensi, dan lisensinya tidak selalu sama dalam satu family. Repositori tersebut adalah sumber resmi. Ringkasan di bawah menjelaskan ketentuan yang berlaku saat halaman ini terakhir diverifikasi.
Ini adalah deskripsi lisensi yang terlibat, bukan nasihat hukum. Jika jawabannya penting secara komersial, baca sendiri lisensinya dan mintalah nasihat dari penasihat hukum Anda.
- Karya asli
- DINOv2, Meta AI (FAIR)
- Lisensi upstream
- Apache-2.0
- Sumber upstream
- github.com/facebookresearch/dinov2
- Kode LibreYOLO
- MIT
- Bobot
- Apache-2.0, didistribusikan oleh penulisnya. LibreYOLO tidak menghosting atau mencerminkannya.
- Interpretasi
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
Baris "Weights" di atas menyebutkan lisensi yang berlaku, yaitu Apache-2.0,
tetapi tidak ada apa pun yang benar-benar dipublikasikan ulang di organisasi
Hugging Face LibreYOLO untuk family ini. LibreYOLO tidak menghosting checkpoint
LibreDINOv2 miliknya sendiri. Yang diunduh oleh
LibreDINOv2(model_path=None) adalah repository
facebook/dinov2-with-registers-small milik Meta, tanpa perubahan.
Sitasi
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
Disalin dari blok sitasi penulis di github.com/facebookresearch/dinov2#citing-dinov2.