EfficientNetV2
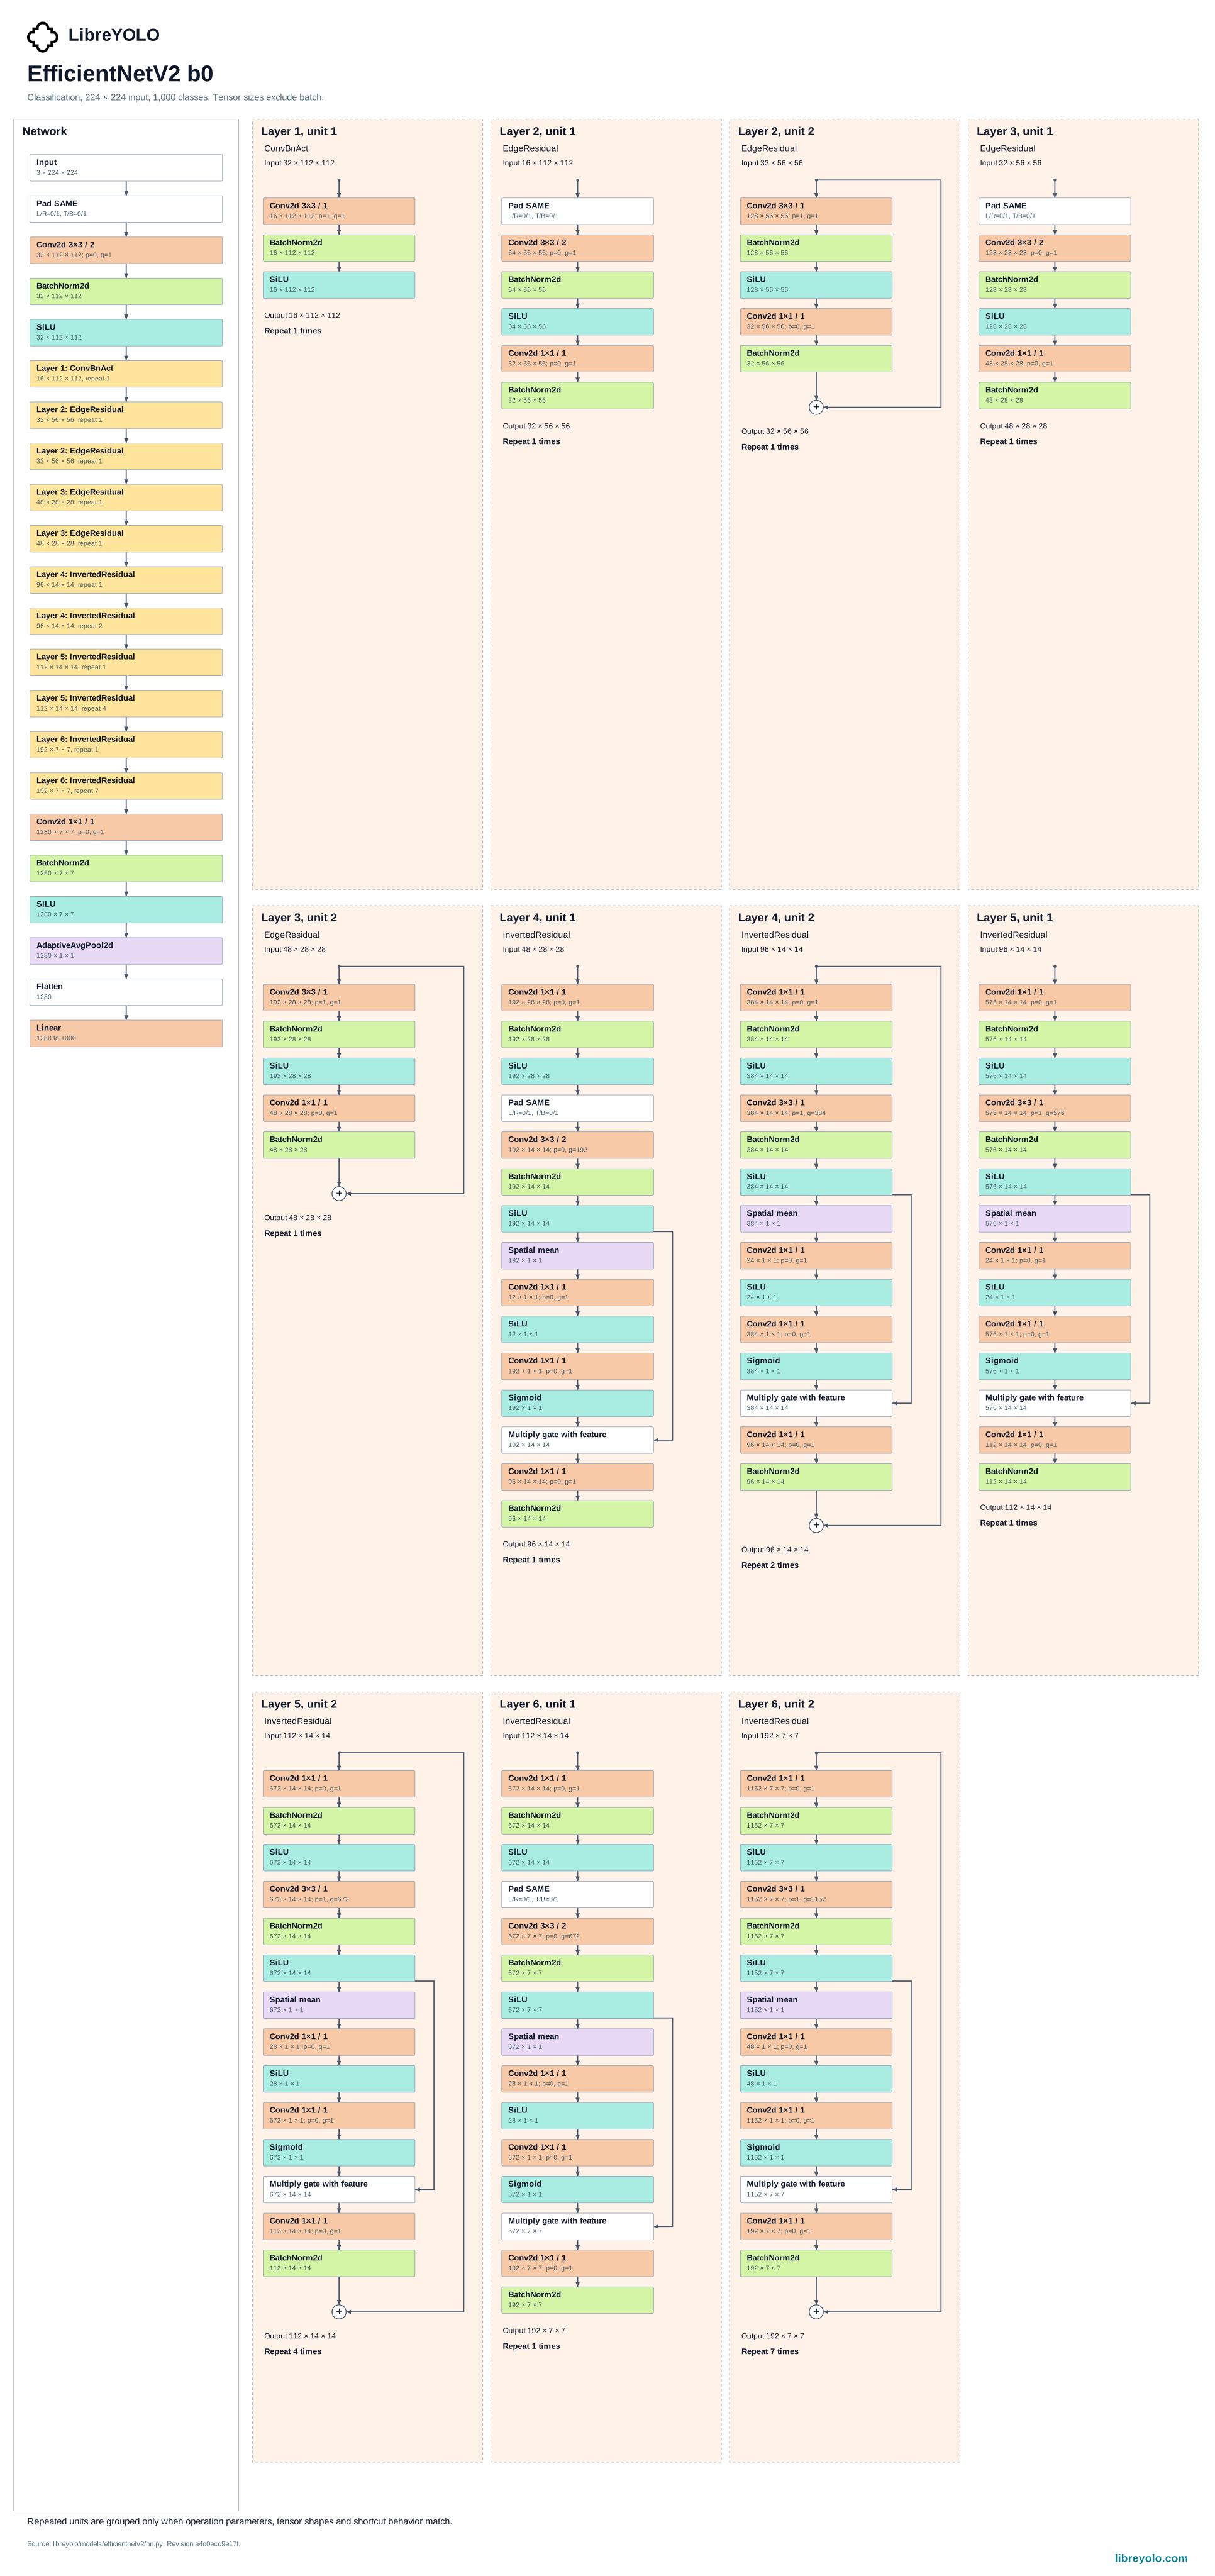
EfficientNetV2 adalah classifier gambar yang kedalaman, lebar dan pilihan blok tiap tahapnya ditemukan lewat neural architecture search, dioptimalkan sekaligus untuk akurasi dan kecepatan pelatihan, bukan untuk akurasi saja. LibreYOLO mendukungnya untuk satu task: klasifikasi.
- Task
- classification
- Ukuran
- b0, b1, b2, b3 at 224 to 300 px
- Instalasi
pip install libreyolo- Tier dukungan
- Didukung, sejak v1.3.0. Model pendukung yang dapat dilatih: CI dijaga tetap lulus, fitur ditambahkan saat ada kesempatan.
- Lisensi
- Kode Apache-2.0, bobot Apache-2.0. Penggunaan komersial
Instalasi
EfficientNetV2 tidak memerlukan extra opsional. Semua yang diimpornya sudah ada di instalasi dasar.
pip install libreyoloPrediksi
Bobot diunduh dari Hugging Face saat pertama kali dipakai dan disimpan di cache lokal.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreEfficientNetV2b0-cls.pt")result = model(SAMPLE_IMAGE, save=True) print(result.probs.top1, result.probs.top1conf)print(result.probs.top5)libreyolo predict model=LibreEfficientNetV2b0-cls.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=TrueObjek Results yang dikembalikan sama dengan yang dikembalikan setiap family,
jadi mengganti model dengan model lain cukup satu baris perubahan. Classifier
tidak membawa box atau mask: result.probs menyimpan prediksi untuk seluruh
gambar, dengan top1, top5, top1conf dan top5conf. conf, iou dan
max_det tetap diterima demi paritas API tetapi tidak berpengaruh, karena pada
satu vektor probabilitas tidak ada yang perlu disaring dengan ambang batas atau
ditekan. Lihat prediksi untuk sumber, streaming dan penanganan
hasil.
Varian
Empat ukuran, b0 sampai b3, masing-masing dievaluasi pada resolusi dan rasio
crop-nya sendiri, bukan memakai satu ukuran input yang sama untuk seluruh
family. Memilih ukuran hanyalah pertukaran langsung antara jumlah parameter dan
akurasi. Task-nya tetap: setiap ukuran hanya mencakup klasifikasi. Nama berkas
bobot selalu berakhiran -cls.pt di semua ukuran, dan sufiks itulah yang dibaca
factory untuk mengarahkan ke family ini; argumen task= tidak diperlukan.
Pelatihan
Fine-tuning dimulai dari backbone ImageNet yang dipublikasikan dan membangun
ulang lapisan classifier terakhir sesuai jumlah kelas dataset target secara
otomatis. Secara bawaan imgsz mengikuti resolusi evaluasi milik ukuran itu
sendiri, kecuali disetel secara eksplisit.
from libreyolo import LibreYOLO model = LibreYOLO("LibreEfficientNetV2b0-cls.pt")model.train(data="imagenette160", epochs=5)libreyolo train model=LibreEfficientNetV2b0-cls.pt data=imagenette160 epochs=5libreyolo train model=LibreEfficientNetV2b0-cls.pt data=imagenette160 \ epochs=50 device=0,1 batch=-1Tanpa pengaturan tambahan, trainer menjalankan 100 epoch pada lr0=1e-3 dengan
AdamW, batch 64 dan early stopping setelah 50 epoch tanpa perbaikan. data
menerima root dataset (train/ dan val/, satu folder per kelas), nama pendek
yang dikenal seperti imagenette160, atau URL .zip. lora=True tidak
didukung di sini; memberikannya akan memunculkan error, karena LoRA di LibreYOLO
menyasar komponen transformer yang memiliki lapisan nn.Linear, sedangkan blok
MBConv di family ini tidak punya.
Lihat pelatihan untuk dataset, augmentasi, multi-GPU dan logger.
cls_pw=0 menonaktifkan pembobotan loss; nilai hingga 1 memakai bobot invers frekuensi yang dinormalisasi ke rata-rata 1. class_weights=True memakai invers frekuensi yang dinormalisasi berdasarkan sampel dan tidak dapat digabung dengan cls_pw>0. Pengaturan ini harus sama saat melanjutkan pelatihan. Lihat klasifikasi.
Validasi
val() mengembalikan dictionary berisi kunci metrics/. Untuk klasifikasi,
isinya akurasi top-1 dan top-5 pada split validasi.
from libreyolo import LibreYOLO model = LibreYOLO("LibreEfficientNetV2b0-cls.pt")metrics = model.val(data="imagenette160") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])libreyolo val model=LibreEfficientNetV2b0-cls.pt data=imagenette160Validasi dan kalibrasi INT8 memakai transformasi evaluasi family. Metadata ekspor mencatat norm_mean, norm_std, dan resize_mode; artefak lama memakai nilai family sebagai fallback. Prapemroses kalibrasi mengembalikan array CHW dan rasio yang diperlukan.
Ekspor
| Task | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Classification | Classification to ONNX: didukung | Classification to TorchScript: didukung | Classification to ExecuTorch: didukung | Classification to TensorRT: didukung | Classification to OpenVINO: didukung | Classification to Paddle: tidak didukung | Classification to MNN: tidak didukung | Classification to RKNN: tidak didukung | Classification to ncnn: didukung | Classification to TFLite: didukung | Classification to CoreML: tidak didukung | Classification to Core AI: didukung |
Artefak hasil ekspor dimuat kembali lewat LibreYOLO() berdasarkan sufiks
berkasnya, jadi berkas .onnx atau .engine berperilaku seperti checkpoint dan
mengembalikan Results yang sama. Ekspor memuat daftar argumen
yang diterima setiap format dan tambahan yang dipakai beberapa di antaranya.
from libreyolo import LibreYOLO model = LibreYOLO("LibreEfficientNetV2b0-cls.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreEfficientNetV2b0-cls.pt format=onnxlibreyolo export model=LibreEfficientNetV2b0-cls.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Factory memilih rute berdasarkan sufiks berkas, jadi artefak hasil# ekspor dimuat seperti checkpoint biasa dan mengembalikan objek# Results yang sama.model = LibreYOLO("LibreEfficientNetV2b0-cls.onnx")result = model(SAMPLE_IMAGE) print(result.probs.top1)Checkpoint
Semua berkas bobot yang dipublikasikan untuk family ini.
| Berkas | Input (piksel) | Lisensi bobot |
|---|---|---|
| Classification | ||
| LibreEfficientNetV2b0-cls.pt | 224 | apache-2.0 |
| LibreEfficientNetV2b1-cls.pt | 240 | apache-2.0 |
| LibreEfficientNetV2b2-cls.pt | 260 | apache-2.0 |
| LibreEfficientNetV2b3-cls.pt | 300 | apache-2.0 |
Setiap berkas di atas saat ini tersedia di organisasi LibreYOLO dan diunduh saat pertama kali digunakan.
Lisensi
Periksa lisensi di repositori Hugging Face untuk bobot tertentu yang diunduh. Setiap checkpoint di organisasi LibreYOLO memiliki lisensi, dan lisensinya tidak selalu sama dalam satu family. Repositori tersebut adalah sumber resmi. Ringkasan di bawah menjelaskan ketentuan yang berlaku saat halaman ini terakhir diverifikasi.
Ini adalah deskripsi lisensi yang terlibat, bukan nasihat hukum. Jika jawabannya penting secara komersial, baca sendiri lisensinya dan mintalah nasihat dari penasihat hukum Anda.
- Karya asli
- EfficientNetV2, Google
- Lisensi upstream
- Apache-2.0
- Sumber upstream
- github.com/huggingface/pytorch-image-models
- Kode LibreYOLO
- MIT
- Bobot
- Apache-2.0, dipublikasikan ulang di huggingface.co/LibreYOLO
- Interpretasi
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. It places no obligation on your own application code, and weights you train yourself on your own data are yours. The architecture is Google's design, whose reference implementation at google/automl is also Apache-2.0; LibreYOLO's implementation follows the block definitions, TensorFlow "SAME" padding and naming in timm, whose tf_efficientnetv2_b{0,1,2,3} ImageNet-1k weights (ported by Ross Wightman, no ImageNet-21k or extra data) are licensed Apache-2.0 and are what LibreYOLO ships.