MiDaS
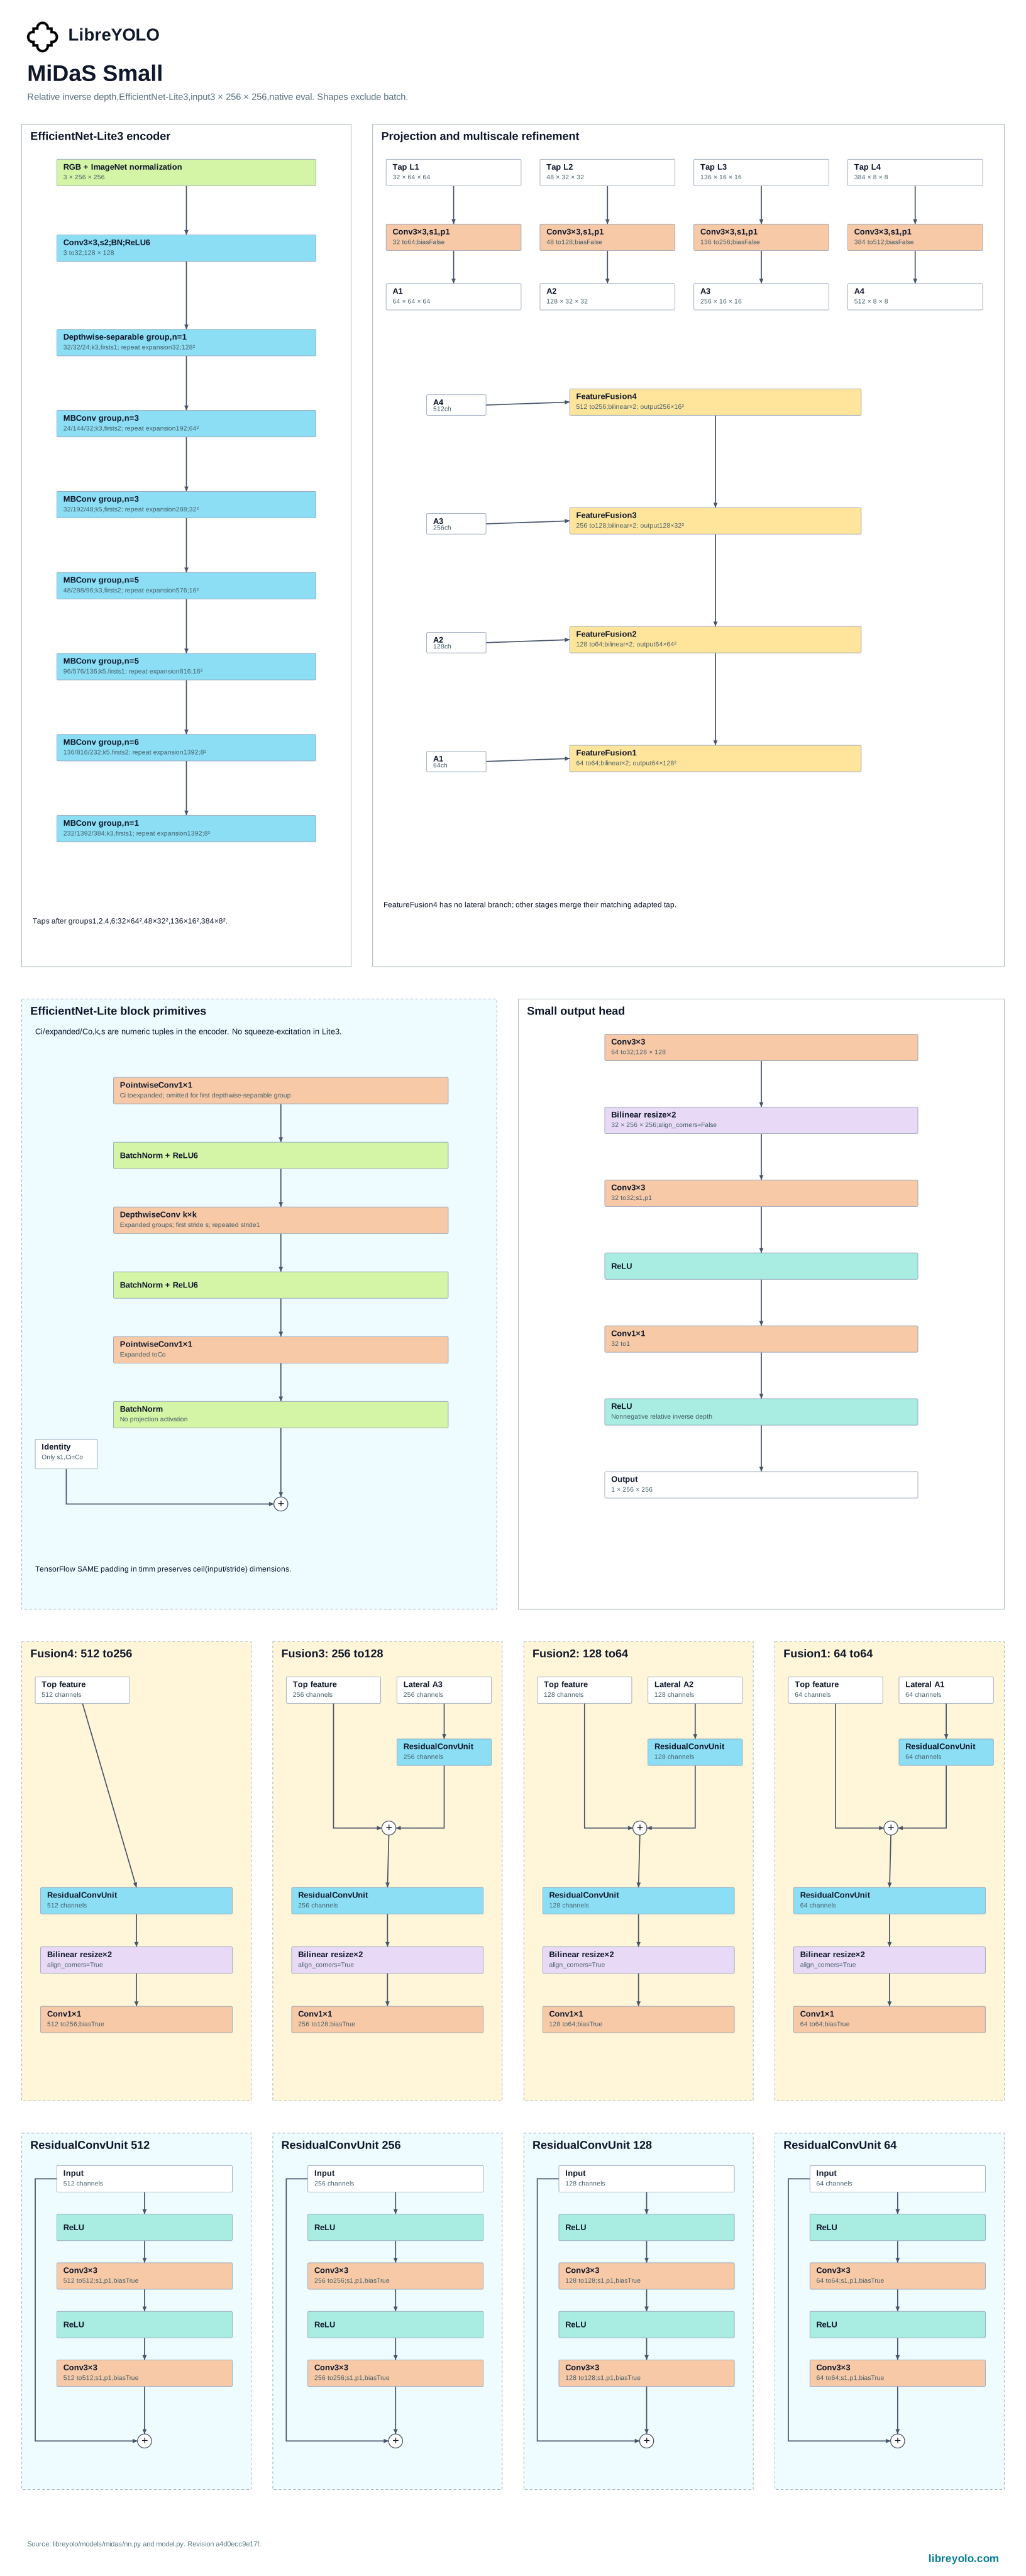
MiDaS adalah estimasi kedalaman relatif monokular yang dilatih dengan loss invarian skala dan pergeseran pada campuran dataset. Rangkaian pekerjaan ini membentuk protokol transfer kedalaman zero-shot yang digunakan kembali oleh family berikutnya. LibreYOLO mendukungnya untuk task kedalaman: prediksi dan validasi zero-shot, tanpa jalur pelatihan.
- Task
- depth
- Ukuran
- s, l at 256 to 384 px
- Instalasi
pip install "libreyolo[midas]"- Tier dukungan
- Hanya inferensi, sejak v1.5.0. Hanya prediksi, validasi, dan ekspor. Fitur pelatihan tidak berlaku.
- Lisensi
- Kode MIT, bobot MIT. Penggunaan komersial
Instalasi
MiDaS memerlukan extra midas untuk encoder timm-nya.
pip install "libreyolo[midas]"Prediksi
Checkpoint s dan l diunduh dari mirror LibreYOLO dengan izin MIT dari penerbit dan disimpan dalam cache lokal.
from libreyolo import LibreYOLO, SAMPLE_IMAGE # Mengunduh checkpoint dari mirror saat pertama kali dipakai.model = LibreYOLO("LibreMiDaSl-depth.pt")result = model(SAMPLE_IMAGE, save=True) depth = result.depth_mapprint(depth.min, depth.max, depth.mean)libreyolo predict model=LibreMiDaSl-depth.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Encoder EfficientNet-Lite3, lebih kecil dan cepat daripada ukuran DPT-Large l.model = LibreYOLO("LibreMiDaSs-depth.pt")result = model(SAMPLE_IMAGE, save=True)result.depth_map berisi peta kedalaman invers relatif yang rapat: nilai lebih besar berarti lebih dekat ke kamera, tanpa satuan metrik atau skala yang berlaku antar gambar. save=True menulis visualisasi peta berwarna ke disk; Results.plot() merender peta kedalaman. Lihat prediksi untuk sumber, streaming, dan penanganan hasil.
Varian
Ada dua varian dengan encoder berbeda, bukan sekadar skala berbeda dari encoder
yang sama. s adalah MiDaS v2.1 Small dengan encoder EfficientNet-Lite3. l
adalah DPT-Large dengan encoder ViT-L/16 dan decoder DPT yang diperkenalkan MiDaS
untuk prediksi padat. Preprocessing-nya juga berbeda. s memakai resize aspek
upper-bound dengan normalisasi mean/std ImageNet, sedangkan l memakai resize
aspek minimal dengan mean dan std 0.5. Pilih s untuk CNN yang lebih ringan,
atau l untuk akurasi decoder transformer.
Pelatihan tidak tersedia untuk family ini. LibreMiDaS.train() selalu
memunculkan NotImplementedError.
Validasi
val() menjalankan validator kedalaman bersama. Setiap prediksi disejajarkan
dengan ground truth melalui skala dan pergeseran least-squares per gambar, lalu
validator melaporkan metrik kedalaman relatif zero-shot standar: AbsRel, RMSE,
dan tiga ambang batas delta.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/abs_rel"])print(metrics["metrics/rmse"])print(metrics["metrics/delta1"])libreyolo val model=LibreMiDaSl-depth.pt data=my-dataset.yamlEkspor
| Task | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Depth | Depth to ONNX: didukung | Depth to TorchScript: didukung | Depth to ExecuTorch: didukung | Depth to TensorRT: didukung | Depth to OpenVINO: didukung | Depth to Paddle: tidak didukung | Depth to MNN: tidak didukung | Depth to RKNN: tidak didukung | Depth to ncnn: didukung | Depth to TFLite: tidak didukung | Depth to CoreML: tidak didukung | Depth to Core AI: tidak didukung |
Artefak hasil ekspor dapat dimuat kembali melalui LibreYOLO() berdasarkan
akhiran berkasnya, sehingga berkas .onnx atau .engine berperilaku seperti
checkpoint dan mengembalikan Results yang sama, dengan depth_map sebagai
pengganti box.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreMiDaSl-depth.pt format=onnxlibreyolo export model=LibreMiDaSl-depth.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Factory merutekan berdasarkan akhiran berkas, sehingga artefak hasil ekspor dimuat# seperti checkpoint lain dan mengembalikan objek Results yang sama.model = LibreYOLO("LibreMiDaSl-depth.onnx")result = model(SAMPLE_IMAGE) print(result.depth_map.data.shape)Lisensi
Periksa lisensi di repositori Hugging Face untuk bobot tertentu yang diunduh. Setiap checkpoint di organisasi LibreYOLO memiliki lisensi, dan lisensinya tidak selalu sama dalam satu family. Repositori tersebut adalah sumber resmi. Ringkasan di bawah menjelaskan ketentuan yang berlaku saat halaman ini terakhir diverifikasi.
Ini adalah deskripsi lisensi yang terlibat, bukan nasihat hukum. Jika jawabannya penting secara komersial, baca sendiri lisensinya dan mintalah nasihat dari penasihat hukum Anda.
- Karya asli
- MiDaS, Intel Intelligent Systems Lab (Intel ISL)
- Lisensi upstream
- MIT
- Sumber upstream
- github.com/isl-org/MiDaS
- Kode LibreYOLO
- MIT
- Bobot
- MIT, dipublikasikan ulang di huggingface.co/LibreYOLO
- Interpretasi
- The upstream repository and released weights declare MIT. LibreYOLO mirrors the s and l checkpoints under that publisher grant.
Sitasi
@ARTICLE {Ranftl2022,
    author  = "Ren\'{e} Ranftl and Katrin Lasinger and David Hafner and Konrad Schindler and Vladlen Koltun",
    title   = "Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-Shot Cross-Dataset Transfer",
    journal = "IEEE Transactions on Pattern Analysis and Machine Intelligence",
    year    = "2022",
    volume  = "44",
    number  = "3"
}

@article{Ranftl2021,
	author    = {Ren\'{e} Ranftl and Alexey Bochkovskiy and Vladlen Koltun},
	title     = {Vision Transformers for Dense Prediction},
	journal   = {ICCV},
	year      = {2021},
}
Disalin dari blok sitasi penulis di github.com/isl-org/MiDaS#citation.