YOLOv9
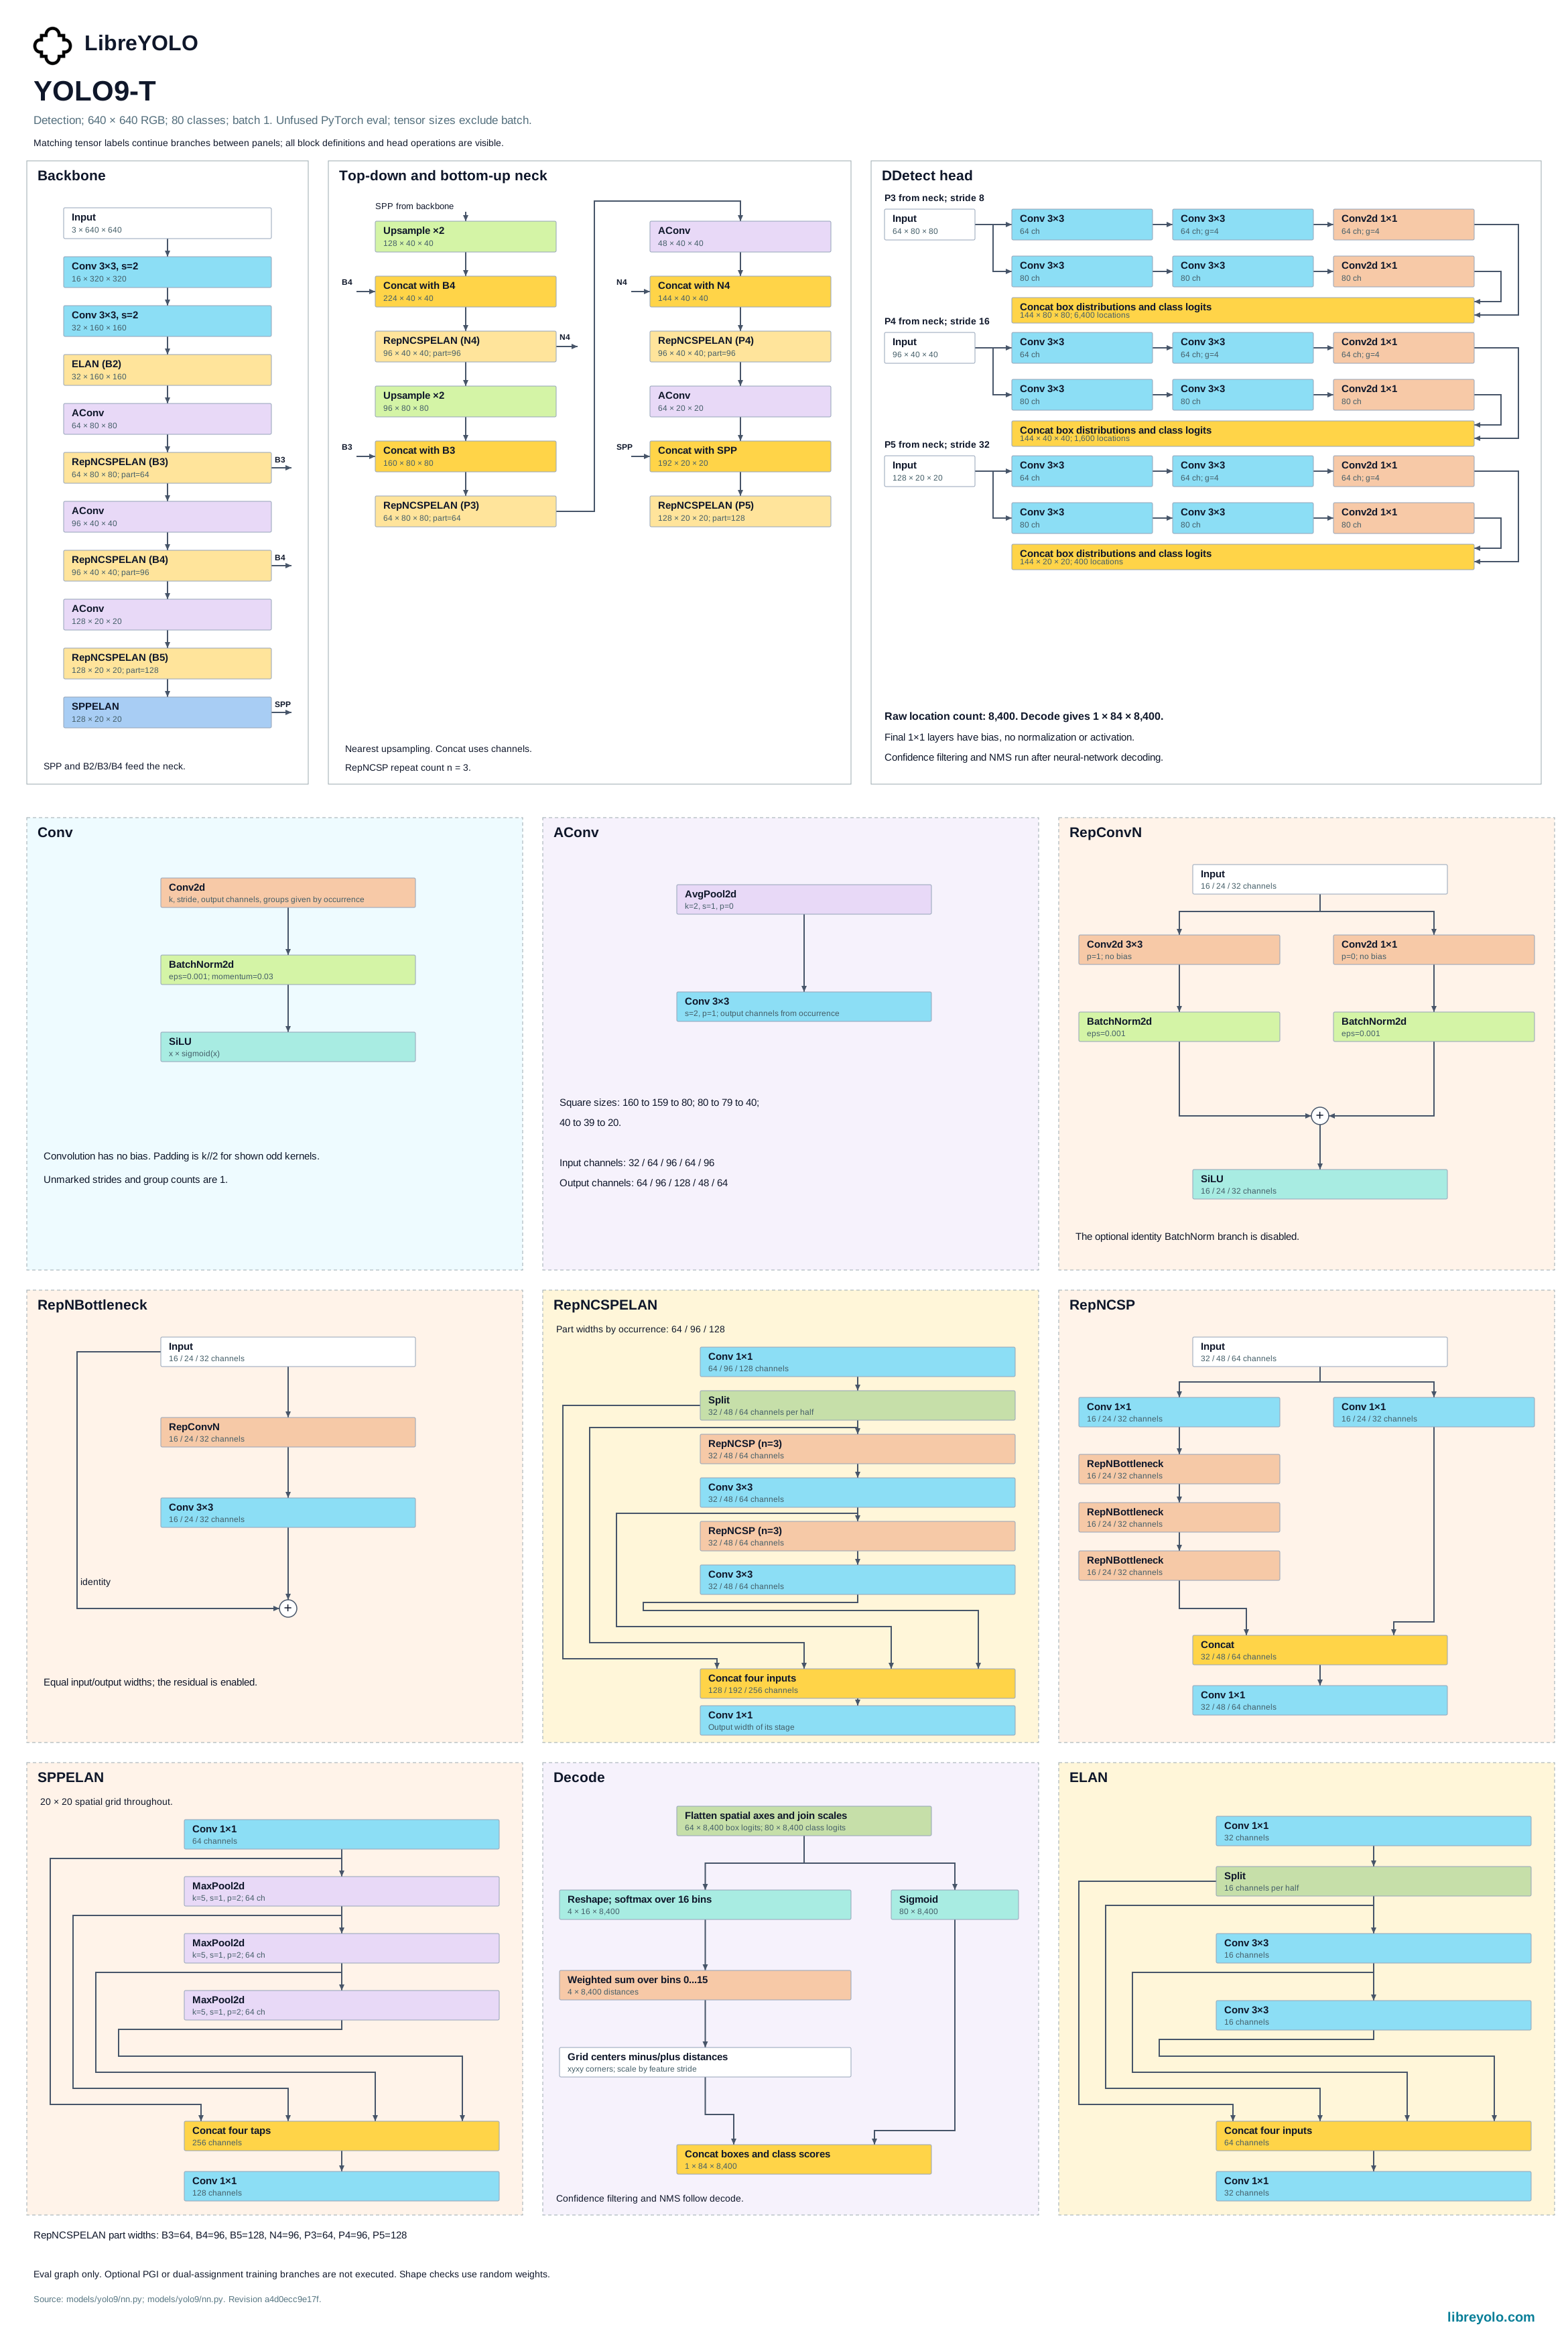
Detektor konvolusional satu tahap: satu tahap menilai grid kotak yang padat dan NMS membuang duplikat. LibreYOLO menyediakan tiga variannya, salah satunya tidak memiliki tahap NMS.
- Task
- detection
- Ukuran
- yolo9: t, s, m, c at 640 px; yolo9_p2: t, s at 640 px
- Instalasi
pip install libreyolo- Tier dukungan
- Unggulan, sejak v1.0.0. Fitur dirancang dan divalidasi sepenuhnya pada GPU di sini terlebih dahulu.
- Lisensi
- Kode MIT, bobot MIT. Penggunaan komersial
Instalasi
YOLOv9 tidak memerlukan komponen tambahan selain paket dasar.
pip install libreyoloPrediksi
Bobot diunduh dari Hugging Face saat pertama kali digunakan dan disimpan dalam cache lokal.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreYOLO9s.pt")result = model(SAMPLE_IMAGE, save=True) for box in result.boxes: print(box.cls, box.conf, box.xyxy)libreyolo predict model=LibreYOLO9s.pt save=True \ source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpgfrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Pemanggilan sama, checkpoint berbeda. Head end-to-end mengembalikan prediksi# dengan skor teratasnya sendiri, sehingga NMS tidak berjalan dan iou diabaikan.model = LibreYOLO("LibreYOLO9E2Es.pt")result = model(SAMPLE_IMAGE, conf=0.25, max_det=300) print(len(result.boxes))Objek Results yang dikembalikan sama dengan yang dikembalikan setiap family, jadi mengganti
detektor hanya memerlukan perubahan satu baris. Pada model dasar dan stride-4, conf
menetapkan ambang batas confidence dan iou menetapkan ambang NMS. Model end-to-end tidak
menjalankan NMS dan mengabaikan iou, sehingga conf dan max_det menentukan bentuk
outputnya. Lihat prediksi untuk sumber, streaming, dan penanganan hasil.
Varian
Tiga varian memakai satu backbone. Ketiganya hanya mendeteksi dan menerima argumen yang sama.
Model dasar memprediksi pada tiga skala feature dan menghapus kotak duplikat dengan NMS.
Model end-to-end mempertahankan head tersebut dan menambahkan cabang pencocokan one-to-one di sampingnya. Inferensi hanya membaca cabang one-to-one dan mengambil prediksi dengan skor teratas, sehingga NMS tidak berjalan. Pilih model ini jika runtime deployment tidak memiliki operator NMS.
Model stride-4 mengekspos satu level lebih atas pada backbone, memperpanjang neck ke level tersebut, dan memprediksi pada empat skala, bukan tiga. Skala tambahan ditujukan untuk objek yang hanya mencakup sedikit piksel; satu checkpoint yang dipublikasikan untuknya dilatih pada gambar udara. Checkpoint deteksi dasar dapat ditransfer ke model ini: backbone dan neck dimuat tanpa perubahan, ketiga tower head pretrained bergeser satu slot, dan tower stride-4 dimulai dari inisialisasi acak.
| Checkpoint | Input (piksel) | mAP 50-95 | Parameter (juta) |
|---|---|---|---|
| LibreYOLO9c | 640 | 56.4 | 25.5 |
| LibreYOLO9m | 640 | 55.3 | 20.12 |
| LibreYOLO9s | 640 | 55.9 | 7.2 |
| LibreYOLO9t | 640 | 41.8 | 2.04 |
COCO val2017, 500 images. Diukur oleh perangkat benchmark LibreYOLO dan dipublikasikan di Vision Analysis, tempat latensi pada berbagai hardware dan runtime dibandingkan serta rekaman lengkap setiap pengujian tersedia.
Pelatihan
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.train(data="my-dataset.yaml", epochs=100, imgsz=640, batch=16)libreyolo train model=LibreYOLO9s.pt data=my-dataset.yaml \ epochs=100 imgsz=640 batch=16from libreyolo import LibreYOLO9P2 # Varian stride-4 tidak memiliki checkpoint COCO sendiri, jadi sebutkan# checkpoint deteksi dasar: backbone dan neck dimuat tanpa perubahan,# sedangkan tower head stride-4 dimulai dari inisialisasi acak.model = LibreYOLO9P2(None, size="s")model.train(data="my-dataset.yaml", epochs=100, pretrained="LibreYOLO9s.pt")pretrained menentukan titik awal proses. Berikan True untuk memuat checkpoint terbitan
bagi model dan ukuran yang sama, atau nama maupun path untuk yang lain. Tensor dengan bentuk
yang tidak cocok dilewati, bukan ditolak, dan proses mencatat jumlah tensor yang dimuat,
sehingga checkpoint yang dilatih pada jumlah kelas berbeda tetap dapat menjadi titik awal.
Model stride-4 tidak memiliki checkpoint COCO terbitan sendiri, sehingga True diselesaikan
menjadi berkas yang tidak ada dan pengunduhan gagal. Sebutkan checkpoint deteksi dasar sebagai
gantinya.
Lihat pelatihan untuk dataset, augmentasi, multi-GPU, dan logger.
Model dasar dapat melatih cabang auxiliary PGI di samping head utamanya. Cabang itu hanya untuk pelatihan: prediksi dan ekspor memakai head utama. Sebuah run memasangnya bila bobot awal membawa tensor PGI atau bila melatih dari nol. Checkpoint dasar yang dipublikasikan tidak membawanya, sehingga fine-tuning dari checkpoint itu hanya melatih head utama dan mencatat hal tersebut di log. aux_weight=0.25 tetap memasang cabang baru dengan bobot loss itu, dan aux_weight=0 membiarkannya mati. Run yang dilanjutkan mempertahankan pengaturan PGI checkpoint-nya. Pada ukuran m dan c, cabang itu adalah cabang upstream: backbone kedua pada gambar input, yang stage-nya dijumlahkan CBFuse dengan tap CBLinear dari backbone utama, beserta head-nya sendiri, masing-masing 12.8M dan 25.7M parameter khusus pelatihan pada 80 kelas. Model end-to-end dan stride-4 tidak punya cabang PGI.
Ketiga varian memotong norma L2 gradien pada 10 sebelum setiap langkah optimizer; clip_max_norm=0 mematikan pemotongan. Penetapan label menilai anchor dalam fp32, termasuk di bawah autocast float16. max_labels=300 membatasi jumlah box yang dipertahankan per gambar pelatihan, dan box di luar batas itu dibuang dengan satu peringatan; memori penetapan mengikuti box nyata tiap gambar, bukan batas tersebut. Momentum SGD naik dari 0.8 ke 0.937 selama tiga epoch. letterbox_pad=None mewarisi penanda checkpoint: bobot tanpa penanda memakai topleft, sedangkan konversi resmi baru mencatat center.
Mosaic YOLO9 dan YOLOX mengutamakan gambar pasangan beranotasi dengan maksimal 20 pengambilan sampel; MixUp YOLO9 memakai kebijakan yang sama. MixUp nonaktif secara default (mixup_prob=0). Bila aktif, rasio blend ditarik dari Beta(1, 1), seragam pada [0, 1], seperti di MultimediaTechLab/YOLO. Lihat histogram peristiwa untuk profil input non-RGB.
Validasi
val() mengembalikan dictionary dengan key metrics/ yang mencakup presisi, recall,
mAP 50, dan mAP 50-95, yang diukur terhadap dataset apa pun dalam format yang digunakan
untuk pelatihan.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mAP50-95"])print(metrics["metrics/mAP50"])libreyolo val model=LibreYOLO9s.pt data=my-dataset.yaml# YAML COCO bawaan menyertakan skrip unduhan tertanam, sehingga# memerlukan izin eksplisit kecuali dataset sudah tersedia secara lokal.libreyolo val model=LibreYOLO9c.pt data=coco.yaml imgsz=640 \ allow_download_scripts=TrueEkspor
| Task | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Detection | Detection to ONNX: didukung | Detection to TorchScript: didukung | Detection to ExecuTorch: didukung | Detection to TensorRT: didukung | Detection to OpenVINO: didukung | Detection to Paddle: didukung | Detection to MNN: didukung | Detection to RKNN: tidak didukung | Detection to ncnn: didukung | Detection to TFLite: tidak didukung | Detection to CoreML: tidak didukung | Detection to Core AI: didukung |
Tanda centang berlaku untuk ketiga varian: jika kemampuannya berbeda, matriks mencantumkan dukungan terlemah dari ketiganya.
Artefak hasil ekspor dimuat kembali melalui LibreYOLO() berdasarkan sufiks berkasnya,
sehingga berkas .onnx atau .engine berperilaku seperti checkpoint dan mengembalikan
Results yang sama. Menjalankan graph pada runtime mandiri tanpa memasang LibreYOLO juga
didukung, tetapi prapemrosesan dan pascapemrosesannya harus ditulis sendiri.
Untuk model deteksi dasar, setengah pascapemrosesan tersebut dapat dipindahkan ke graph.
nms=True pada ekspor ONNX menempatkan suppression di dalam model, dan output pertama
menjadi tensor tetap (1, max_det, 6) dengan baris x1, y1, x2, y2, score, class, yang
diberi padding nol setelah jumlah deteksi. Graph tersebut memakai batch 1 dan tidak memiliki
sumbu dinamis. Model end-to-end dan stride-4 tidak menerima flag itu.
Setiap format memasang komponen tambahan berbeda dan menerima beberapa argumen sendiri. Keduanya dijelaskan pada halaman format tersebut.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.export(format="onnx", imgsz=640)libreyolo export model=LibreYOLO9s.pt format=onnx imgsz=640libreyolo export model=LibreYOLO9s.pt format=onnx nms=True \ conf=0.25 iou=0.45 max_det=300from libreyolo import LibreYOLO, SAMPLE_IMAGE # Factory merutekan berdasarkan sufiks berkas, sehingga artefak hasil ekspor# dimuat seperti checkpoint lain dan mengembalikan objek Results yang sama.model = LibreYOLO("LibreYOLO9s.onnx")result = model(SAMPLE_IMAGE) print(result.boxes.xyxy)TFLite INT8 memakai int8=True dengan data kalibrasi.
Input dan output ONNX
LibreYOLO9
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Warna | RGB |
| Penskalaan | piksel / 255 |
| Normalisasi | tidak ada |
| Ubah ukuran | letterbox, bilinear, nilai padding 114, posisi padding dari kunci metadata letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
Detection, ekspor default
| Output | Bentuk | Arti |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Pascapemrosesan
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Detection, nms=True
| Output | Bentuk | Arti |
|---|---|---|
output | [1, max_det, 6] | Rows are x1, y1, x2, y2, score, class in input-canvas pixels, zero-padded past the detection count. Confidence, IoU and max_det are baked in and recorded as nms_conf, nms_iou and max_det metadata. |
raw | [1, 4 + nc, anchors] | The same tensor as the default export's output, before suppression. |
Pascapemrosesan
- Drop rows whose score is 0 or below your threshold.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
LibreYOLO9E2E
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Warna | RGB |
| Penskalaan | piksel / 255 |
| Normalisasi | tidak ada |
| Ubah ukuran | letterbox, bilinear, nilai padding 114, posisi padding dari kunci metadata letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, ekspor default
| Output | Bentuk | Arti |
|---|---|---|
output | [batch, 4 + nc, anchors] | Predictions of the one-to-one head only. Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Pascapemrosesan
- Transpose to [anchors, 4 + nc].
- Flatten the [anchors, nc] scores into one list of anchors x nc (anchor, class) pairs. Pair i belongs to anchor i / nc (integer division) and class i % nc.
- Keep the 300 highest-scoring pairs (max_det), highest first. One anchor can yield several classes.
- Of those, keep the pairs whose score is above the confidence threshold (0.25 by default).
- Do not run NMS. The one-to-one head is trained to fire once per object, and LibreYOLO ignores the iou setting for this model.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
LibreYOLO9P2
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Warna | RGB |
| Penskalaan | piksel / 255 |
| Normalisasi | tidak ada |
| Ubah ukuran | letterbox, bilinear, nilai padding 114, posisi padding dari kunci metadata letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, ekspor default
| Output | Bentuk | Arti |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 4, 8, 16 and 32, 34000 at 640 x 640. nc is 10 for LibreYOLO9P2s-visdrone. |
Pascapemrosesan
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Untuk memeriksa implementasi Anda sendiri, jalankan file yang sama lewat LibreYOLO: LibreYOLO("model.onnx").predict("image.jpg") mengembalikan hasil acuan. Diverifikasi dengan LibreYOLO 1.7.0.
Checkpoint
Setiap berkas bobot yang dipublikasikan untuk family ini.
| Berkas | Input (piksel) | Lisensi bobot |
|---|---|---|
| Detection | ||
| LibreYOLO9t.pt | 640 | mit |
| LibreYOLO9s.pt | 640 | mit |
| LibreYOLO9m.pt | 640 | mit |
| LibreYOLO9c.pt | 640 | mit |
| LibreYOLO9E2Et.pt | 640 | mit |
| LibreYOLO9E2Es.pt | 640 | mit |
| LibreYOLO9E2Em.pt | 640 | mit |
| LibreYOLO9E2Ec.pt | 640 | mit |
| LibreYOLO9P2s-visdrone.pt | cc-by-nc-sa-3.0 | |
Setiap berkas di atas saat ini tersedia di organisasi LibreYOLO dan diunduh saat pertama kali digunakan.
Lisensi
Periksa lisensi di repositori Hugging Face untuk bobot tertentu yang diunduh. Setiap checkpoint di organisasi LibreYOLO memiliki lisensi, dan lisensinya tidak selalu sama dalam satu family. Repositori tersebut adalah sumber resmi. Ringkasan di bawah menjelaskan ketentuan yang berlaku saat halaman ini terakhir diverifikasi.
Ini adalah deskripsi lisensi yang terlibat, bukan nasihat hukum. Jika jawabannya penting secara komersial, baca sendiri lisensinya dan mintalah nasihat dari penasihat hukum Anda.
- Karya asli
- YOLOv9, MultimediaTechLab
- Lisensi upstream
- MIT
- Sumber upstream
- github.com/MultimediaTechLab/YOLO
- Kode LibreYOLO
- MIT
- Bobot
- MIT, dipublikasikan ulang di huggingface.co/LibreYOLO
- Interpretasi
- MIT is a permissive license, so these weights can be used in commercial and closed-source products. The one standing obligation is to keep the license text and the copyright notice, Kin-Yiu Wong and Hao-Tang Tsui, with any copy you redistribute. It places no condition on your own application code, and a model you train yourself on your own data is yours. Two things are worth knowing beyond that. The code is ported from the authors' MIT re-release of YOLOv9, MultimediaTechLab/YOLO at commit c4cb5f6f, not the GPL-3.0 repository that carries the same model, so the permissive terms come from the source LibreYOLO actually derives from. And one checkpoint in this family is not MIT: the weight repository of the stride-4 VisDrone model, LibreYOLO9P2s-visdrone.pt, declares CC BY-NC-SA 3.0, which rules out commercial use and requires share-alike on derivatives.
Kode ketiga varian di-port dari MultimediaTechLab/YOLO pada commit c4cb5f6f (MIT). Predictor one-to-one pada model end-to-end mengikuti desain DATE oleh Yiqun Chen (Apache-2.0), diimplementasikan untuk LibreYOLO tanpa menyalin kode DATE. Level stride-4 adalah kode LibreYOLO.
Checkpoint aerial stride-4 memprediksi kelas VisDrone. Gunakan lisensi yang dinyatakan penerbit dan tercatat di repositori bobotnya.
Sitasi
@inproceedings{wang2024yolov9,
      title={{YOLOv9}: Learning What You Want to Learn Using Programmable Gradient Information},
      author={Wang, Chien-Yao and Yeh, I-Hau and Liao, Hong-Yuan Mark},
      year={2024},
      booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
}
Disalin dari blok sitasi penulis di github.com/MultimediaTechLab/YOLO#citations.