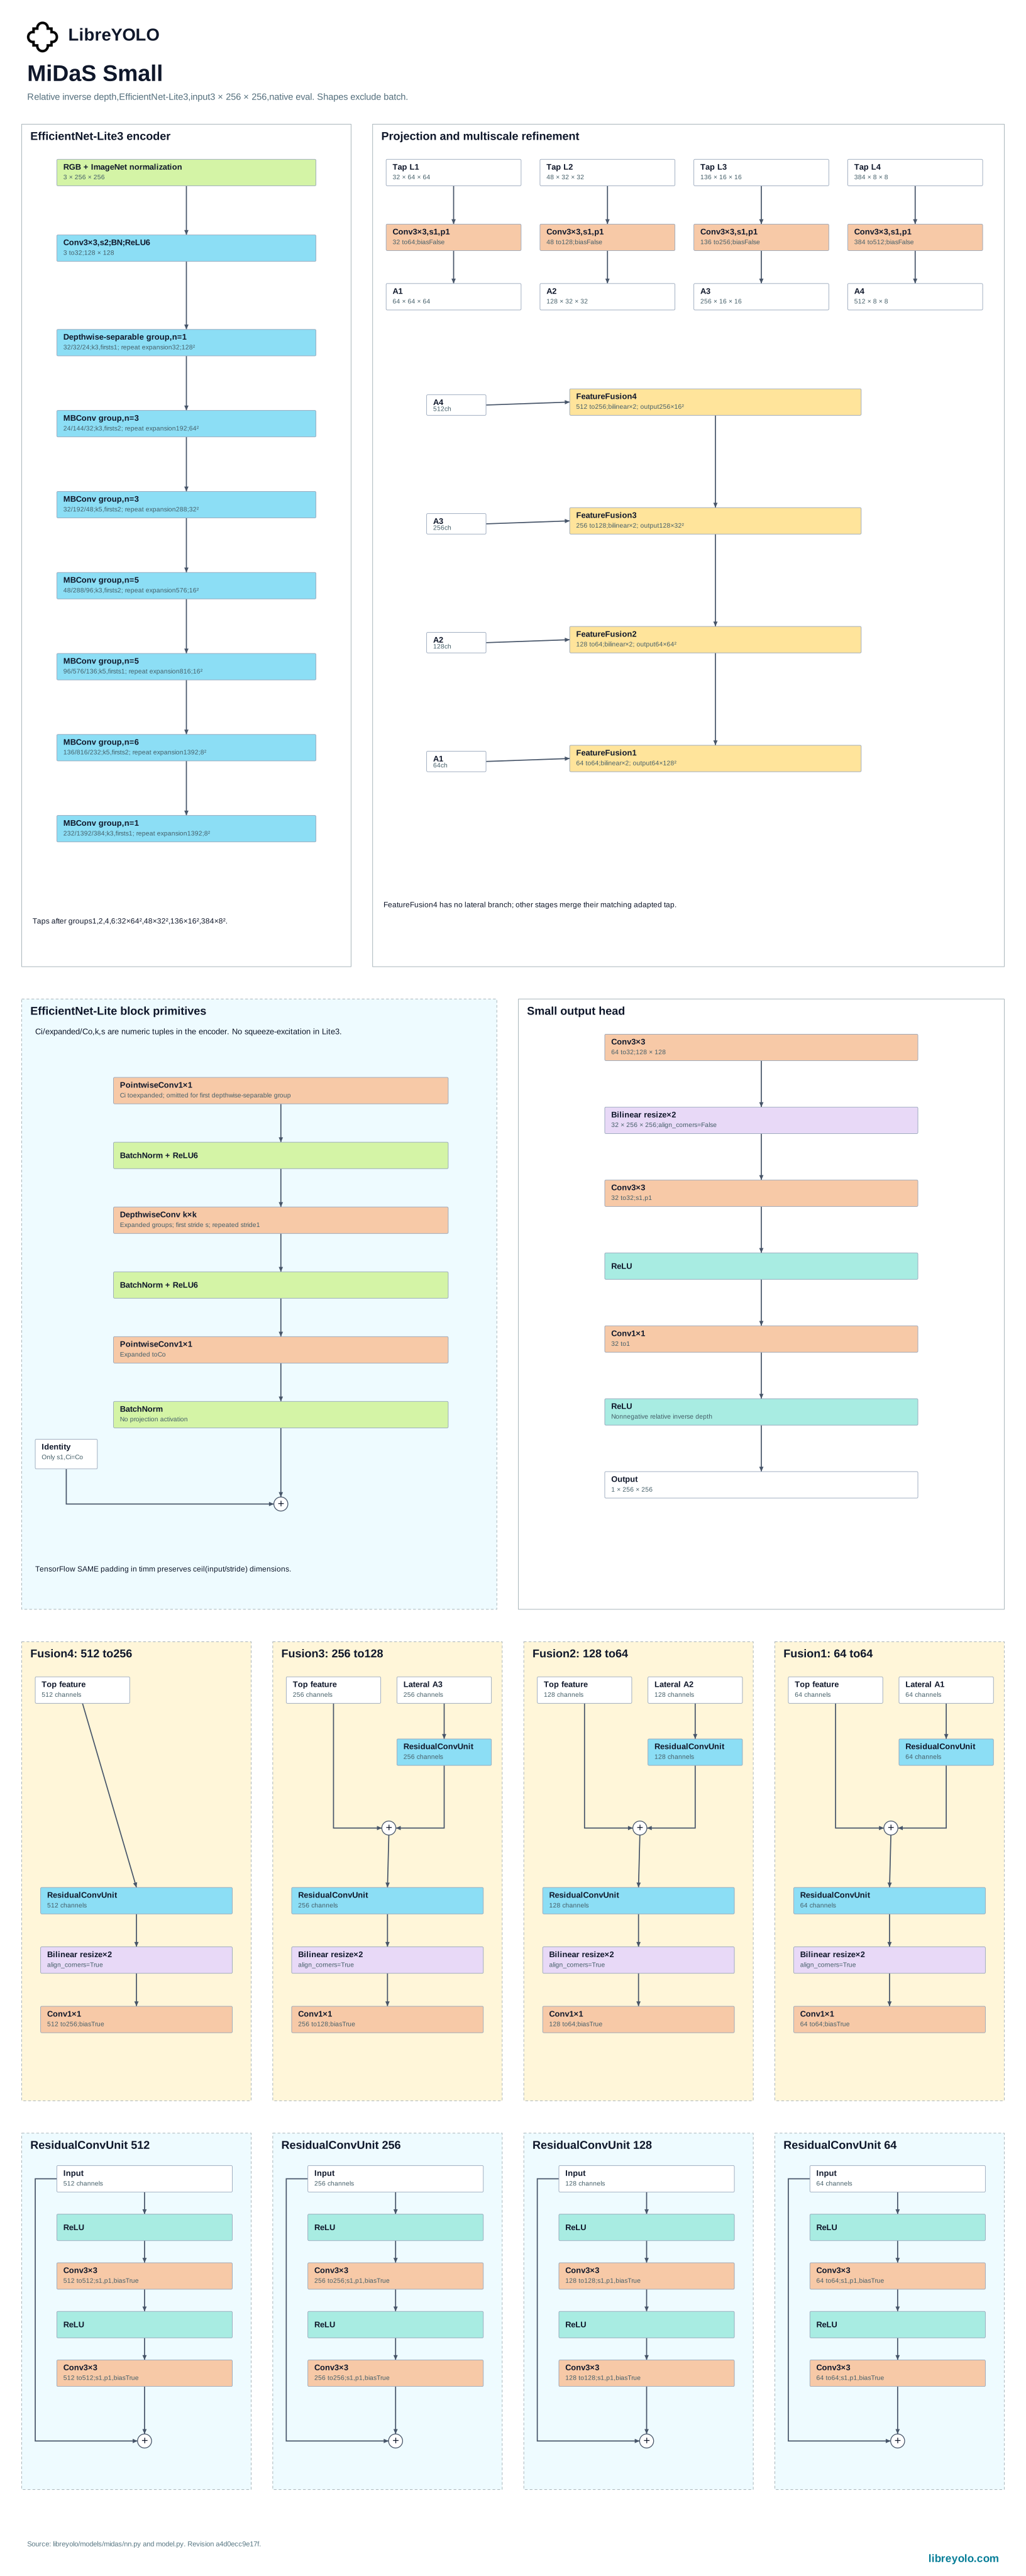
MiDaS
MiDaS는 여러 데이터셋에서 스케일 및 시프트 불변 손실로 학습한 단안 상대 깊이 추정 모델입니다. 이후 계열이 재사용하는 제로샷 깊이 전이 프로토콜을 확립한 연구 계열입니다. LibreYOLO는 깊이 작업의 예측과 제로샷 검증을 지원하지만 학습 경로는 제공하지 않습니다.
- 작업
- depth
- 크기
- s, l at 256 to 384 px
- 설치
pip install "libreyolo[midas]"- 지원 티어
- 추론 전용, v1.5.0부터 지원. 예측, 검증, 내보내기만 지원합니다. 학습 기능은 적용되지 않습니다.
- 라이선스
- 코드 MIT, 가중치 MIT. 상업적 사용
설치
MiDaS의 timm 인코더에는 midas extra가 필요합니다.
pip install "libreyolo[midas]"예측
s와 l 체크포인트는 배포자의 MIT 허가에 따라 LibreYOLO 미러에서 다운로드되어 로컬에 캐시됩니다.
from libreyolo import LibreYOLO, SAMPLE_IMAGE # 처음 사용할 때 미러 체크포인트를 다운로드합니다.model = LibreYOLO("LibreMiDaSl-depth.pt")result = model(SAMPLE_IMAGE, save=True) depth = result.depth_mapprint(depth.min, depth.max, depth.mean)libreyolo predict model=LibreMiDaSl-depth.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # EfficientNet-Lite3 인코더로 DPT-Large의 l 크기보다 작고 빠릅니다.model = LibreYOLO("LibreMiDaSs-depth.pt")result = model(SAMPLE_IMAGE, save=True)result.depth_map에는 조밀한 상대 역깊이 맵이 들어 있습니다. 값이 클수록 카메라에 가깝고, 값에는 미터 단위나 이미지 간 공통 스케일이 없습니다. save=True는 이 맵에 컬러맵을 적용한 시각화를 디스크에 저장하며, Results.plot()은 깊이 맵을 렌더링합니다. 소스, 스트리밍, 결과 처리는 예측을 참조하십시오.
변형
두 변형은 같은 모델의 단순한 크기 차이가 아니라 서로 다른 인코더를 사용합니다. s는 EfficientNet-Lite3 인코더를 사용하는 MiDaS v2.1 Small입니다. l은 ViT-L/16 인코더에 MiDaS가 조밀 예측용으로 도입한 DPT 디코더를 결합한 DPT-Large입니다. 전처리도 다릅니다. s는 ImageNet 평균/표준편차 정규화와 상한 종횡비 크기 조정을 사용하고 l은 최소 종횡비 크기 조정과 평균 및 표준편차 0.5를 사용합니다. 가벼운 CNN이 필요하면 s, transformer 디코더의 정확도가 필요하면 l을 선택합니다.
이 계열은 학습을 제공하지 않습니다. LibreMiDaS.train()은 조건 없이 NotImplementedError를 발생시킵니다.
검증
val()은 공유 깊이 검증기를 실행합니다. 이미지별 최소제곱 스케일과 시프트로 각 예측을 정답에 정렬한 다음 표준 제로샷 상대 깊이 지표인 AbsRel, RMSE, 세 가지 delta 임곗값을 보고합니다.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/abs_rel"])print(metrics["metrics/rmse"])print(metrics["metrics/delta1"])libreyolo val model=LibreMiDaSl-depth.pt data=my-dataset.yaml내보내기
| 작업 | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Depth | Depth to ONNX: 지원함 | Depth to TorchScript: 지원함 | Depth to ExecuTorch: 지원함 | Depth to TensorRT: 지원함 | Depth to OpenVINO: 지원함 | Depth to Paddle: 지원하지 않음 | Depth to MNN: 지원하지 않음 | Depth to RKNN: 지원하지 않음 | Depth to ncnn: 지원함 | Depth to TFLite: 지원하지 않음 | Depth to CoreML: 지원하지 않음 | Depth to Core AI: 지원하지 않음 |
내보낸 아티팩트는 파일 접미사에 따라 LibreYOLO()로 다시 불러옵니다. 따라서 .onnx 또는 .engine 파일은 체크포인트처럼 동작하며 박스 대신 depth_map을 포함한 동일한 Results를 반환합니다.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreMiDaSl-depth.pt format=onnxlibreyolo export model=LibreMiDaSl-depth.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # 팩토리는 파일 접미사에 따라 라우팅하므로 내보낸 아티팩트도# 다른 체크포인트처럼 불러와 동일한 Results 객체를 반환합니다.model = LibreYOLO("LibreMiDaSl-depth.onnx")result = model(SAMPLE_IMAGE) print(result.depth_map.data.shape)라이선스
내려받는 특정 가중치의 Hugging Face 저장소에서 라이선스를 확인하십시오. LibreYOLO 조직의 모든 체크포인트에는 라이선스가 있으며 한 계열 안에서도 항상 같지는 않습니다. 해당 저장소가 신뢰할 수 있는 기준입니다. 아래 요약은 이 페이지를 마지막으로 검증했을 때 적용된 내용을 설명합니다.
관련 라이선스에 관한 설명이며 법률 자문이 아닙니다. 상업적으로 중요한 사안이라면 라이선스를 직접 읽고 별도의 법률 자문을 받으십시오.
- 원작
- MiDaS, Intel Intelligent Systems Lab (Intel ISL)
- 업스트림 라이선스
- MIT
- 업스트림 소스
- github.com/isl-org/MiDaS
- LibreYOLO 코드
- MIT
- 가중치
- MIT, huggingface.co/LibreYOLO에 다시 게시됨
- 해석
- The upstream repository and released weights declare MIT. LibreYOLO mirrors the s and l checkpoints under that publisher grant.
인용
@ARTICLE {Ranftl2022,
    author  = "Ren\'{e} Ranftl and Katrin Lasinger and David Hafner and Konrad Schindler and Vladlen Koltun",
    title   = "Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-Shot Cross-Dataset Transfer",
    journal = "IEEE Transactions on Pattern Analysis and Machine Intelligence",
    year    = "2022",
    volume  = "44",
    number  = "3"
}

@article{Ranftl2021,
	author    = {Ren\'{e} Ranftl and Alexey Bochkovskiy and Vladlen Koltun},
	title     = {Vision Transformers for Dense Prediction},
	journal   = {ICCV},
	year      = {2021},
}github.com/isl-org/MiDaS#citation에 있는 저자의 인용 블록에서 복사했습니다.