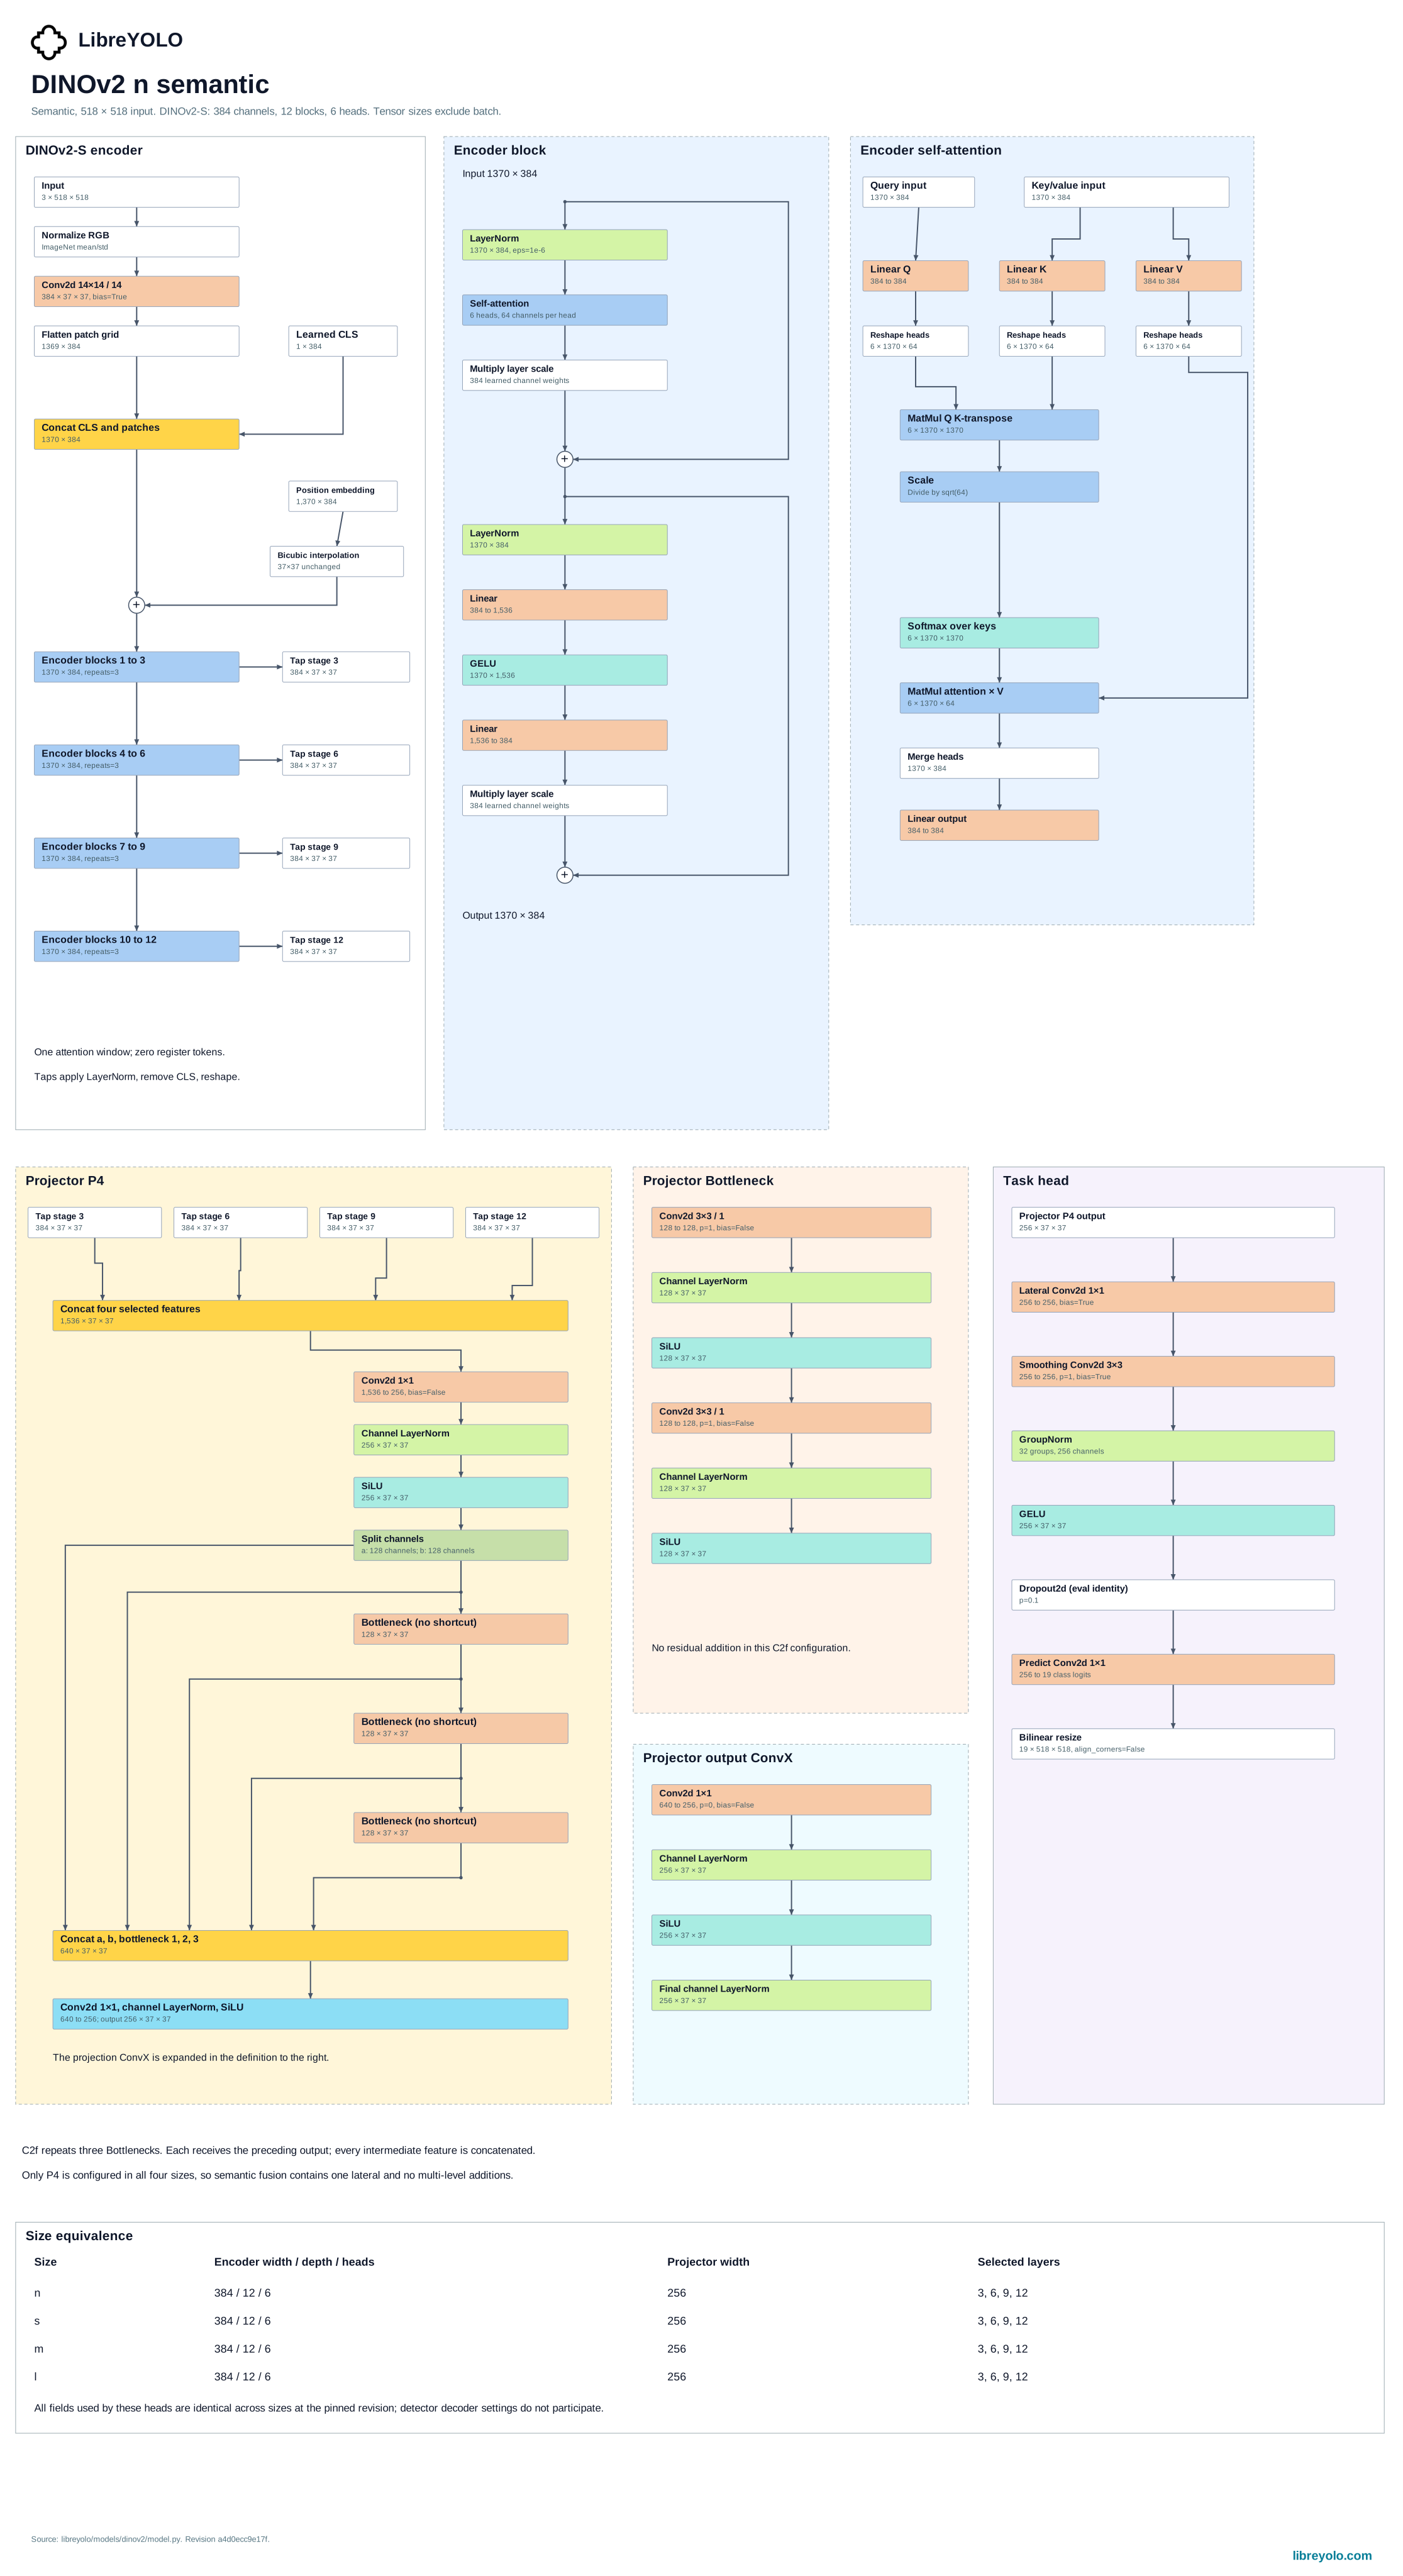
DINOv2
DINOv2 jest samonadzorowanym transformatorem wizji trenowanym przez Meta AI w celu generowania ogólnych cech obrazu bez etykiet. LibreYOLO otacza swoje DINOv2-with-Registers backbone do trzech zadań: segmentacji semantycznej, klasyfikacji i osadzania całego obrazu.
- Zadania
- semantic segmentation, classification, embeddings
- Rozmiary
- n, s, m, l at 518 px
- Instalacja
pip install "libreyolo[rfdetr]"- Poziom obsługi
- Obsługiwany, od wersji v1.3.0. Dodatkowe trenowalne modele: testy CI pozostają zielone, a funkcje są dodawane w miarę możliwości.
- Projekt źródłowy
- DINOv2, autorzy: Meta AI (FAIR), licencja: Apache-2.0. Publikacja, kod źródłowy
- Licencje
- Kod: MIT, wagi: Apache-2.0. Użycie komercyjne
Instalacja
LibreDINOv2 jest rejestrowany tylko wtedy, gdy zainstalowano pakiet
transformers. Jest to ta sama opcjonalna zależność, której RF-DETR wymaga dla
backbone DINOv2, dlatego potrzebny jest ten sam dodatek.
pip install "libreyolo[rfdetr]"Predykcja
LibreYOLO nie publikuje checkpointu LibreDINOv2. Zamiast wczytywać plik, należy
utworzyć otokę bezpośrednio. Domyślne model_path=None pobiera przy pierwszym
użyciu z Hugging Face backbone Meta facebook/dinov2-with-registers-small na
licencji Apache-2.0. Argument task= wybiera wykonywane na nim zadanie.
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Nie istnieje checkpoint LibreYOLO-hosted dla tej rodziny: this# pobiera Apache-2.0 DINOv2-with-Registers-small backbone z# Organizacja Hugging Face Meta. Gęsta głowa zaczyna się losowo# inicjalizacja aż do momentu, gdy ją wytrenujesz (zobacz Trenuj poniżej).model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= to liczba klas w twoim zbiorze danych; głowa liniowa zaczyna# losowo inicjalizowane aż do momentu, gdy je wytrenujesz.model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Omija każdą głowę zadania: sam backbone wystarczy, więc to# nie wymaga dopracowywania, aby być użytecznym.model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D), L2-normalizedfrom libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # Wygodna nakładka: uruchamia predict() i układa każdy wiersz w jeden# (N, D) tensor.features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" i task="classify" dodają do backbone odpowiednio gęstą lub
liniową głowicę. Głowica jest inicjalizowana losowo i staje się użyteczna dopiero
po wytrenowaniu (zobacz sekcję Trenowanie). task="embed" pomija
wszystkie głowice i zwraca końcowy, znormalizowany token CLS backbone jako jeden
wiersz reprezentujący cały obraz w result.embeddings, dlatego nie wymaga
trenowania. result.boxes zawsze ma wartość None, ponieważ żadne z trzech
zadań nie tworzy detekcji instancji. Zobacz stronę
predykcji, aby poznać źródła, streaming i obsługę wyników.
Warianty
size wybiera szerokość projektora RF-DETR-style nałożoną na backbone, a nie sam backbone: każdy rozmiar korzysta z tego samego kodera DINOv2-S (małego). Segmentacja semantyczna działa na natywnej siatce kwadratowych patchy DINOv2; klasyfikacja i osadzanie działają w mniejszej rozdzielczości klasyfikacyjnej używanej do trenowania liniowej sondy.
Trenowanie
Zadania task="semantic" i task="classify" obsługują trenowanie. Zadanie
task="embed" nie ma zależnej od klas głowicy do dopasowania, dlatego wywołanie
dla niego train() zgłasza NotImplementedError.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)Główne argumenty kluczowe tutaj to batch_size i lr, a nie batch i lr0 używane przez większość innych rodzin; batch i lr0 są nadal akceptowane i mapowane na nie, ale podanie obu powoduje błąd konfliktu. output_dir= (domyślnie None) zastępuje project=/name= jako główny sposób umieszczania biegu, chociaż bezpośrednie podanie project=/name= nadal działa. Zobacz trenowanie dotyczące zbiorów danych, augmentacji, wielu GPU i loggerów.
Nowe uruchomienia tworzą katalog runs/train/dinov2_exp z kolejnym numerem i exist_ok=False. resume=True przywraca stan trenera i zachowuje wybrany katalog uruchomienia. Klasyfikacja obsługuje cls_pw i class_weights, opisane w sekcji hiperparametrów.
Walidacja
val() zwraca słownik kluczy metrics/: mIoU i dokładność pikseli dla task="semantic", dokładność top-1 i top-5 dla task="classify". task="embed" nie ma prawdziwej wartości do oceny i zgłasza NotImplementedError, jeśli wywołasz val() na nim.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])Kalibracja klasyfikacji i embeddingów korzysta z pipeline'u klasyfikacji modelu. Ewaluacja używa transformacji danej rodziny.
Eksport
| Zadanie | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX: obsługiwane | Semantic segmentation to TorchScript: obsługiwane | Semantic segmentation to ExecuTorch: obsługiwane | Semantic segmentation to TensorRT: obsługiwane | Semantic segmentation to OpenVINO: obsługiwane | Semantic segmentation to Paddle: brak obsługi | Semantic segmentation to MNN: brak obsługi | Semantic segmentation to RKNN: brak obsługi | Semantic segmentation to ncnn: brak obsługi | Semantic segmentation to TFLite: brak obsługi | Semantic segmentation to CoreML: brak obsługi | Semantic segmentation to Core AI: brak obsługi |
| Classification | Classification to ONNX: obsługiwane | Classification to TorchScript: obsługiwane | Classification to ExecuTorch: obsługiwane | Classification to TensorRT: obsługiwane | Classification to OpenVINO: obsługiwane | Classification to Paddle: brak obsługi | Classification to MNN: brak obsługi | Classification to RKNN: brak obsługi | Classification to ncnn: brak obsługi | Classification to TFLite: brak obsługi | Classification to CoreML: brak obsługi | Classification to Core AI: obsługiwane |
| Embeddings | Embeddings to ONNX: obsługiwane | Embeddings to TorchScript: obsługiwane | Embeddings to ExecuTorch: obsługiwane | Embeddings to TensorRT: obsługiwane | Embeddings to OpenVINO: obsługiwane | Embeddings to Paddle: brak obsługi | Embeddings to MNN: brak obsługi | Embeddings to RKNN: brak obsługi | Embeddings to ncnn: brak obsługi | Embeddings to TFLite: obsługiwane | Embeddings to CoreML: brak obsługi | Embeddings to Core AI: brak obsługi |
Każde zadanie obsługuje inny podzbiór formatów, pokazany powyżej. Wyeksportowany artefakt można ponownie załadować przez LibreYOLO() na jego rozszerzeniu pliku, więc plik .onnx lub .engine działa jak checkpoint i zwraca ten sam Results. Eksport pokazuje argumenty, które akceptuje każdy format.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # Fabryka kieruje na podstawie rozszerzenia pliku, więc eksportowany artefakt się ładuje# jak każdy checkpoint i zwraca ten sam obiekt Results. Eksport# nazywa plik z zadania, tutaj LibreDINOv2s-sem.onnx.model = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)Licencjonowanie
Sprawdź licencję w repozytorium konkretnych pobieranych wag na Hugging Face. Każdy checkpoint w organizacji LibreYOLO ma licencję, która nie zawsze jest taka sama w całej rodzinie. To repozytorium jest źródłem rozstrzygającym, a poniższe podsumowanie opisuje stan z chwili ostatniej weryfikacji tej strony.
To opis obowiązujących licencji, a nie porada prawna. Jeśli odpowiedź ma znaczenie komercyjne, przeczytaj licencje i zasięgnij własnej porady prawnej.
- Oryginalna praca
- DINOv2, Meta AI (FAIR)
- Licencja projektu źródłowego
- Apache-2.0
- Kod źródłowy projektu
- github.com/facebookresearch/dinov2
- Kod LibreYOLO
- MIT
- Wagi
- Apache-2.0, rozpowszechniane przez autorów. LibreYOLO ich nie hostuje ani nie udostępnia kopii.
- Interpretacja
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
Wiersz „Wagi” powyżej podaje obowiązującą licencję Apache-2.0, ale LibreYOLO nie
publikuje ponownie żadnych artefaktów tej rodziny na Hugging Face i nie ma
własnego checkpointu LibreDINOv2. Wywołanie
LibreDINOv2(model_path=None) pobiera niezmienione repozytorium Meta
facebook/dinov2-with-registers-small.
Cytowanie
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
Skopiowano z bloku cytowania autorów w github.com/facebookresearch/dinov2#citing-dinov2.