MiDaS
MiDaS estymuje monokularną głębię względną i jest trenowany z funkcją straty niezmienną względem skali i przesunięcia na mieszanych zbiorach danych. To linia prac, która ustanowiła protokół transferu głębi zero-shot używany przez późniejsze rodziny. LibreYOLO obsługuje go w zadaniu estymacji głębi: do predykcji i walidacji zero-shot, bez ścieżki trenowania.
- Zadania
- depth
- Rozmiary
- s, l at 256 to 384 px
- Instalacja
pip install "libreyolo[midas]"- Poziom obsługi
- Tylko inferencja, od wersji v1.5.0. Tylko predykcja, walidacja i eksport. Funkcje trenowania nie mają zastosowania.
- Projekt źródłowy
- MiDaS, autorzy: Intel Intelligent Systems Lab (Intel ISL), licencja: MIT. Publikacja, kod źródłowy
- Licencje
- Kod: MIT, wagi: MIT. Użycie komercyjne
Instalacja
MiDaS wymaga dodatku midas dla enkoderów timm.
pip install "libreyolo[midas]"Predykcja
Checkpointy s i l są pobierane z kopii w repozytoriach LibreYOLO na licencji MIT wydawcy i przechowywane w lokalnej pamięci podręcznej.
from libreyolo import LibreYOLO, SAMPLE_IMAGE # Przy pierwszym użyciu pobiera kopię checkpointu.model = LibreYOLO("LibreMiDaSl-depth.pt")result = model(SAMPLE_IMAGE, save=True) depth = result.depth_mapprint(depth.min, depth.max, depth.mean)libreyolo predict model=LibreMiDaSl-depth.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Enkoder EfficientNet-Lite3, mniejszy i szybszy niż rozmiar DPT-Large l.model = LibreYOLO("LibreMiDaSs-depth.pt")result = model(SAMPLE_IMAGE, save=True)result.depth_map zawiera gęstą mapę względnej odwrotności głębi: większe wartości oznaczają mniejszą odległość od kamery, a wartości nie mają jednostki metrycznej ani wspólnej skali między obrazami. save=True zapisuje na dysku wizualizację mapy z nałożonymi kolorami; Results.plot() renderuje mapę głębi. Źródła, streaming i obsługę wyników opisano w sekcji predykcji.
Warianty
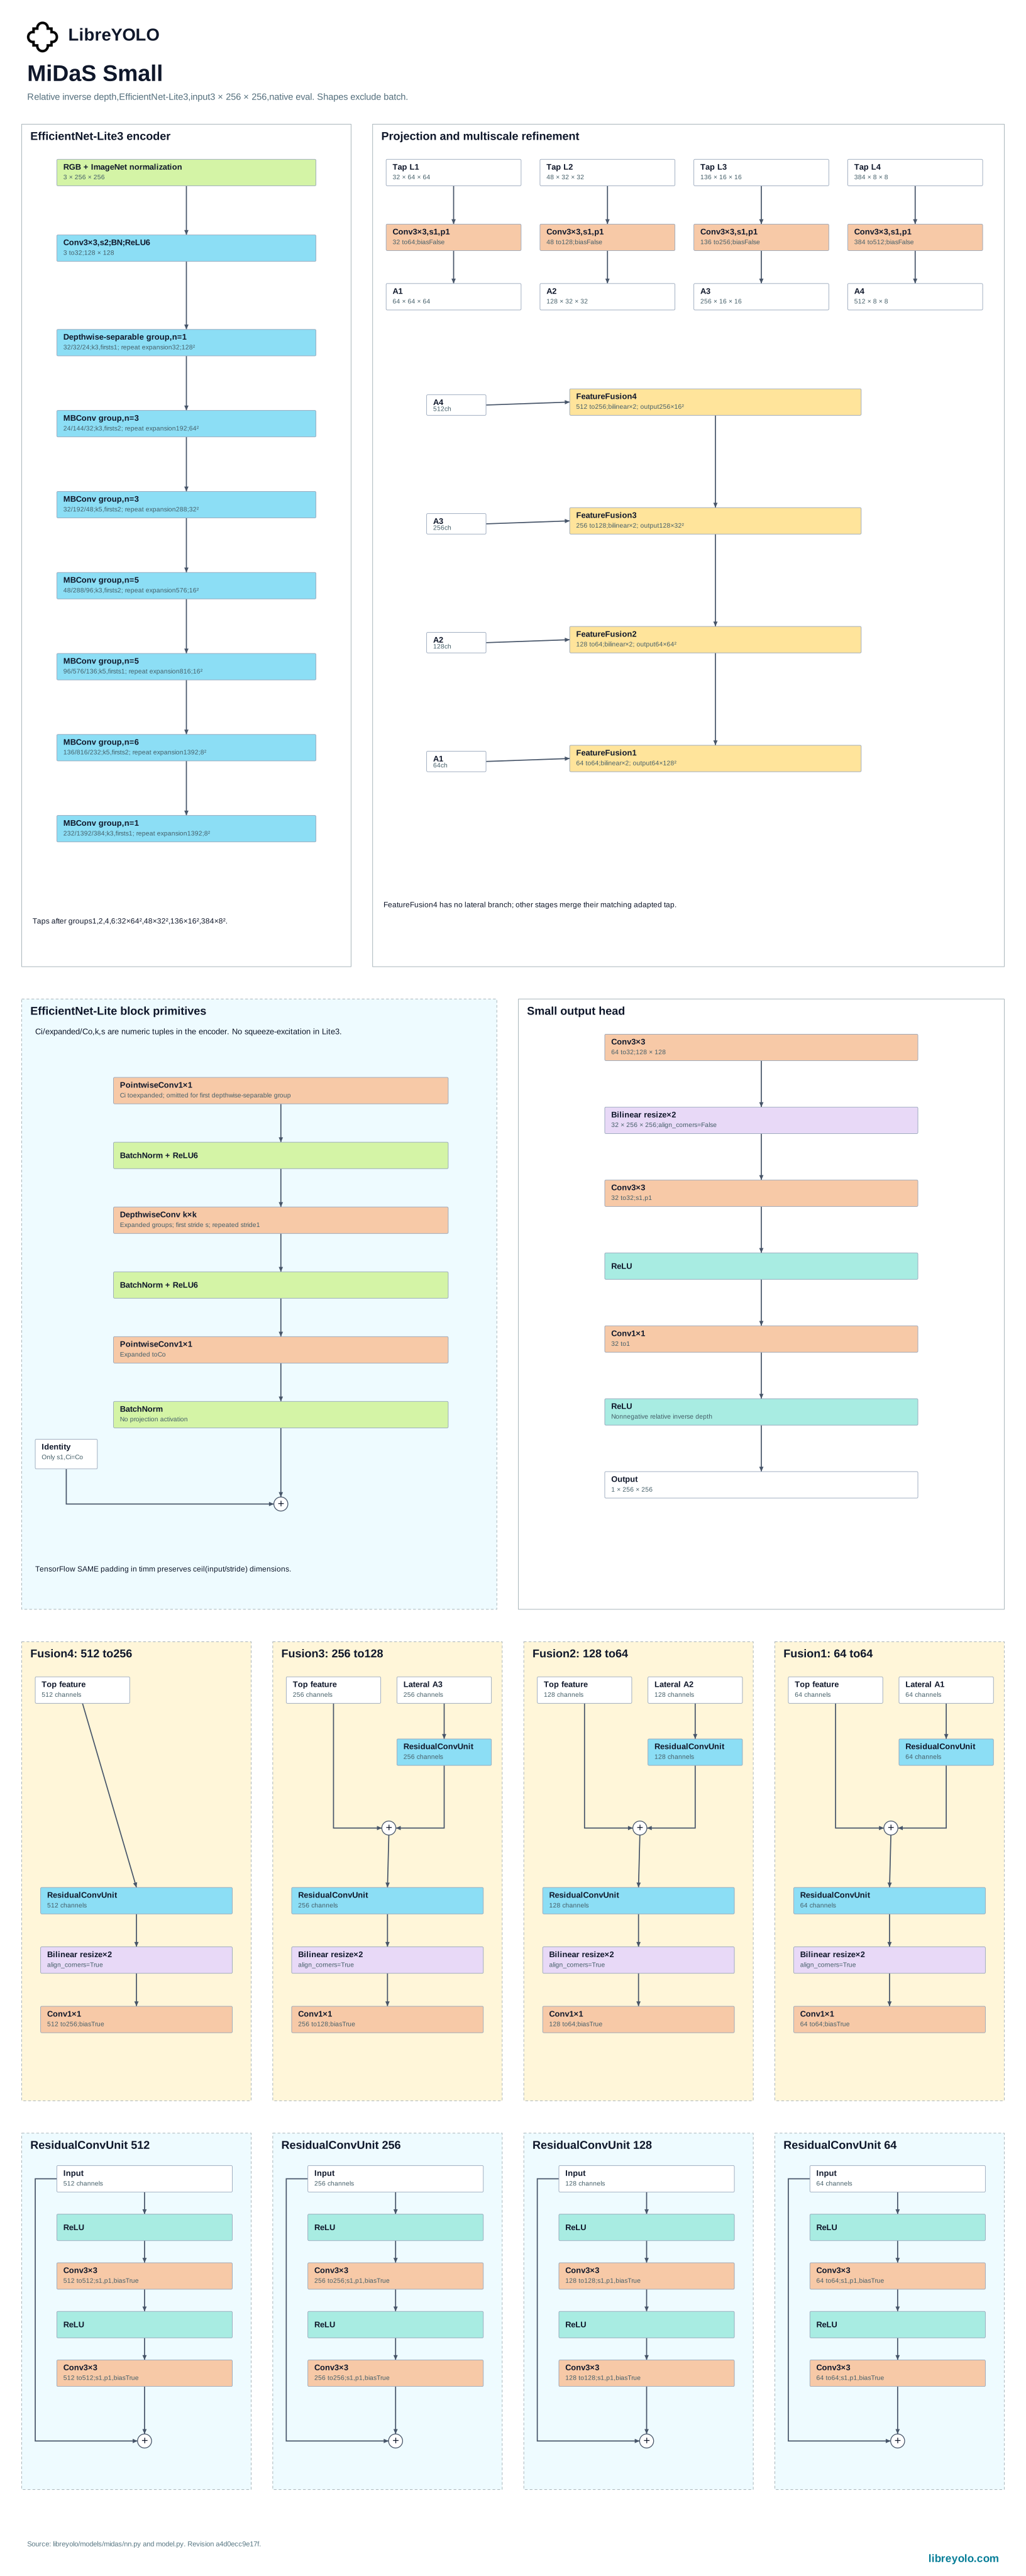
Dostępne są dwa warianty z różnymi enkoderami, a nie tylko różne skale tej samej
architektury. s to MiDaS v2.1 Small z enkoderem EfficientNet-Lite3. l to
DPT-Large z enkoderem ViT-L/16 i dekoderem DPT wprowadzonym przez MiDaS do
gęstej predykcji. Różni je także przetwarzanie wstępne. s stosuje zmianę
rozmiaru proporcji z górną granicą oraz normalizację średnią/odchyleniem
standardowym ImageNet. l stosuje minimalną zmianę rozmiaru proporcji ze
średnią i odchyleniem standardowym 0.5. s należy wybrać jako lżejszą sieć CNN,
a l dla dokładności dekodera transformerowego.
Ta rodzina nie obsługuje trenowania. LibreMiDaS.train() zawsze zgłasza
NotImplementedError.
Walidacja
val() uruchamia wspólny walidator głębi. Dopasowuje każdą predykcję do jej
danych referencyjnych (ground truth), obliczając dla każdego obrazu skalę i
przesunięcie metodą najmniejszych kwadratów, po czym zwraca standardowe metryki
głębi względnej zero-shot: AbsRel, RMSE i trzy progi delta.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/abs_rel"])print(metrics["metrics/rmse"])print(metrics["metrics/delta1"])libreyolo val model=LibreMiDaSl-depth.pt data=my-dataset.yamlEksport
| Zadanie | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Depth | Depth to ONNX: obsługiwane | Depth to TorchScript: obsługiwane | Depth to ExecuTorch: obsługiwane | Depth to TensorRT: obsługiwane | Depth to OpenVINO: obsługiwane | Depth to Paddle: brak obsługi | Depth to MNN: brak obsługi | Depth to RKNN: brak obsługi | Depth to ncnn: obsługiwane | Depth to TFLite: brak obsługi | Depth to CoreML: brak obsługi | Depth to Core AI: brak obsługi |
Wyeksportowany artefakt jest ponownie ładowany przez LibreYOLO() na podstawie
rozszerzenia pliku, więc plik .onnx lub .engine zachowuje się jak checkpoint
i zwraca ten sam obiekt Results, z depth_map zamiast ramek.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreMiDaSl-depth.pt format=onnxlibreyolo export model=LibreMiDaSl-depth.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Fabryka wybiera ścieżkę na podstawie rozszerzenia pliku, więc wyeksportowany artefakt# ładuje się jak każdy checkpoint i zwraca ten sam obiekt Results.model = LibreYOLO("LibreMiDaSl-depth.onnx")result = model(SAMPLE_IMAGE) print(result.depth_map.data.shape)Licencja
Sprawdź licencję w repozytorium konkretnych pobieranych wag na Hugging Face. Każdy checkpoint w organizacji LibreYOLO ma licencję, która nie zawsze jest taka sama w całej rodzinie. To repozytorium jest źródłem rozstrzygającym, a poniższe podsumowanie opisuje stan z chwili ostatniej weryfikacji tej strony.
To opis obowiązujących licencji, a nie porada prawna. Jeśli odpowiedź ma znaczenie komercyjne, przeczytaj licencje i zasięgnij własnej porady prawnej.
- Oryginalna praca
- MiDaS, Intel Intelligent Systems Lab (Intel ISL)
- Licencja projektu źródłowego
- MIT
- Kod źródłowy projektu
- github.com/isl-org/MiDaS
- Kod LibreYOLO
- MIT
- Wagi
- MIT, ponownie opublikowane w huggingface.co/LibreYOLO
- Interpretacja
- The upstream repository and released weights declare MIT. LibreYOLO mirrors the s and l checkpoints under that publisher grant.
Cytowanie
@ARTICLE {Ranftl2022,
    author  = "Ren\'{e} Ranftl and Katrin Lasinger and David Hafner and Konrad Schindler and Vladlen Koltun",
    title   = "Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-Shot Cross-Dataset Transfer",
    journal = "IEEE Transactions on Pattern Analysis and Machine Intelligence",
    year    = "2022",
    volume  = "44",
    number  = "3"
}

@article{Ranftl2021,
	author    = {Ren\'{e} Ranftl and Alexey Bochkovskiy and Vladlen Koltun},
	title     = {Vision Transformers for Dense Prediction},
	journal   = {ICCV},
	year      = {2021},
}
Skopiowano z bloku cytowania autorów w github.com/isl-org/MiDaS#citation.