YOLOv9
Jednoetapowy detektor konwolucyjny: jeden przebieg ocenia gęstą siatkę ramek, a NMS usuwa duplikaty. LibreYOLO zawiera trzy jego warianty, z których jeden nie korzysta z NMS.
- Zadania
- detection
- Rozmiary
- yolo9: t, s, m, c at 640 px; yolo9_p2: t, s at 640 px
- Instalacja
pip install libreyolo- Poziom obsługi
- Flagowy, od wersji v1.0.0. Tutaj funkcje są najpierw projektowane i w pełni walidowane na GPU.
- Projekt źródłowy
- YOLOv9, autorzy: MultimediaTechLab, licencja: MIT. Publikacja, kod źródłowy
- Licencje
- Kod: MIT, wagi: MIT. Użycie komercyjne
Instalacja
YOLOv9 nie wymaga niczego poza pakietem podstawowym.
pip install libreyoloPredykcja
Przy pierwszym użyciu wagi są pobierane z Hugging Face i zapisywane w lokalnej pamięci podręcznej.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreYOLO9s.pt")result = model(SAMPLE_IMAGE, save=True) for box in result.boxes: print(box.cls, box.conf, box.xyxy)libreyolo predict model=LibreYOLO9s.pt save=True \ source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpgfrom libreyolo import LibreYOLO, SAMPLE_IMAGE # To samo wywołanie, inny punkt kontrolny. Głowica end-to-end zwraca własne# predykcje z najwyższymi wynikami, więc NMS nie jest wykonywane, a iou jest ignorowane.model = LibreYOLO("LibreYOLO9E2Es.pt")result = model(SAMPLE_IMAGE, conf=0.25, max_det=300) print(len(result.boxes))Zwracany obiekt Results jest taki sam dla każdej rodziny, więc zamiana na
inny detektor wymaga zmiany jednego wiersza. W modelach bazowym i z krokiem 4
parametr conf ustawia próg pewności, a iou próg NMS. Model end-to-end nie
wykonuje NMS i ignoruje iou, dlatego jego wynik kształtują conf i max_det.
Informacje o źródłach, strumieniowaniu i obsłudze wyników znajdziesz w sekcji
predykcja.
Warianty
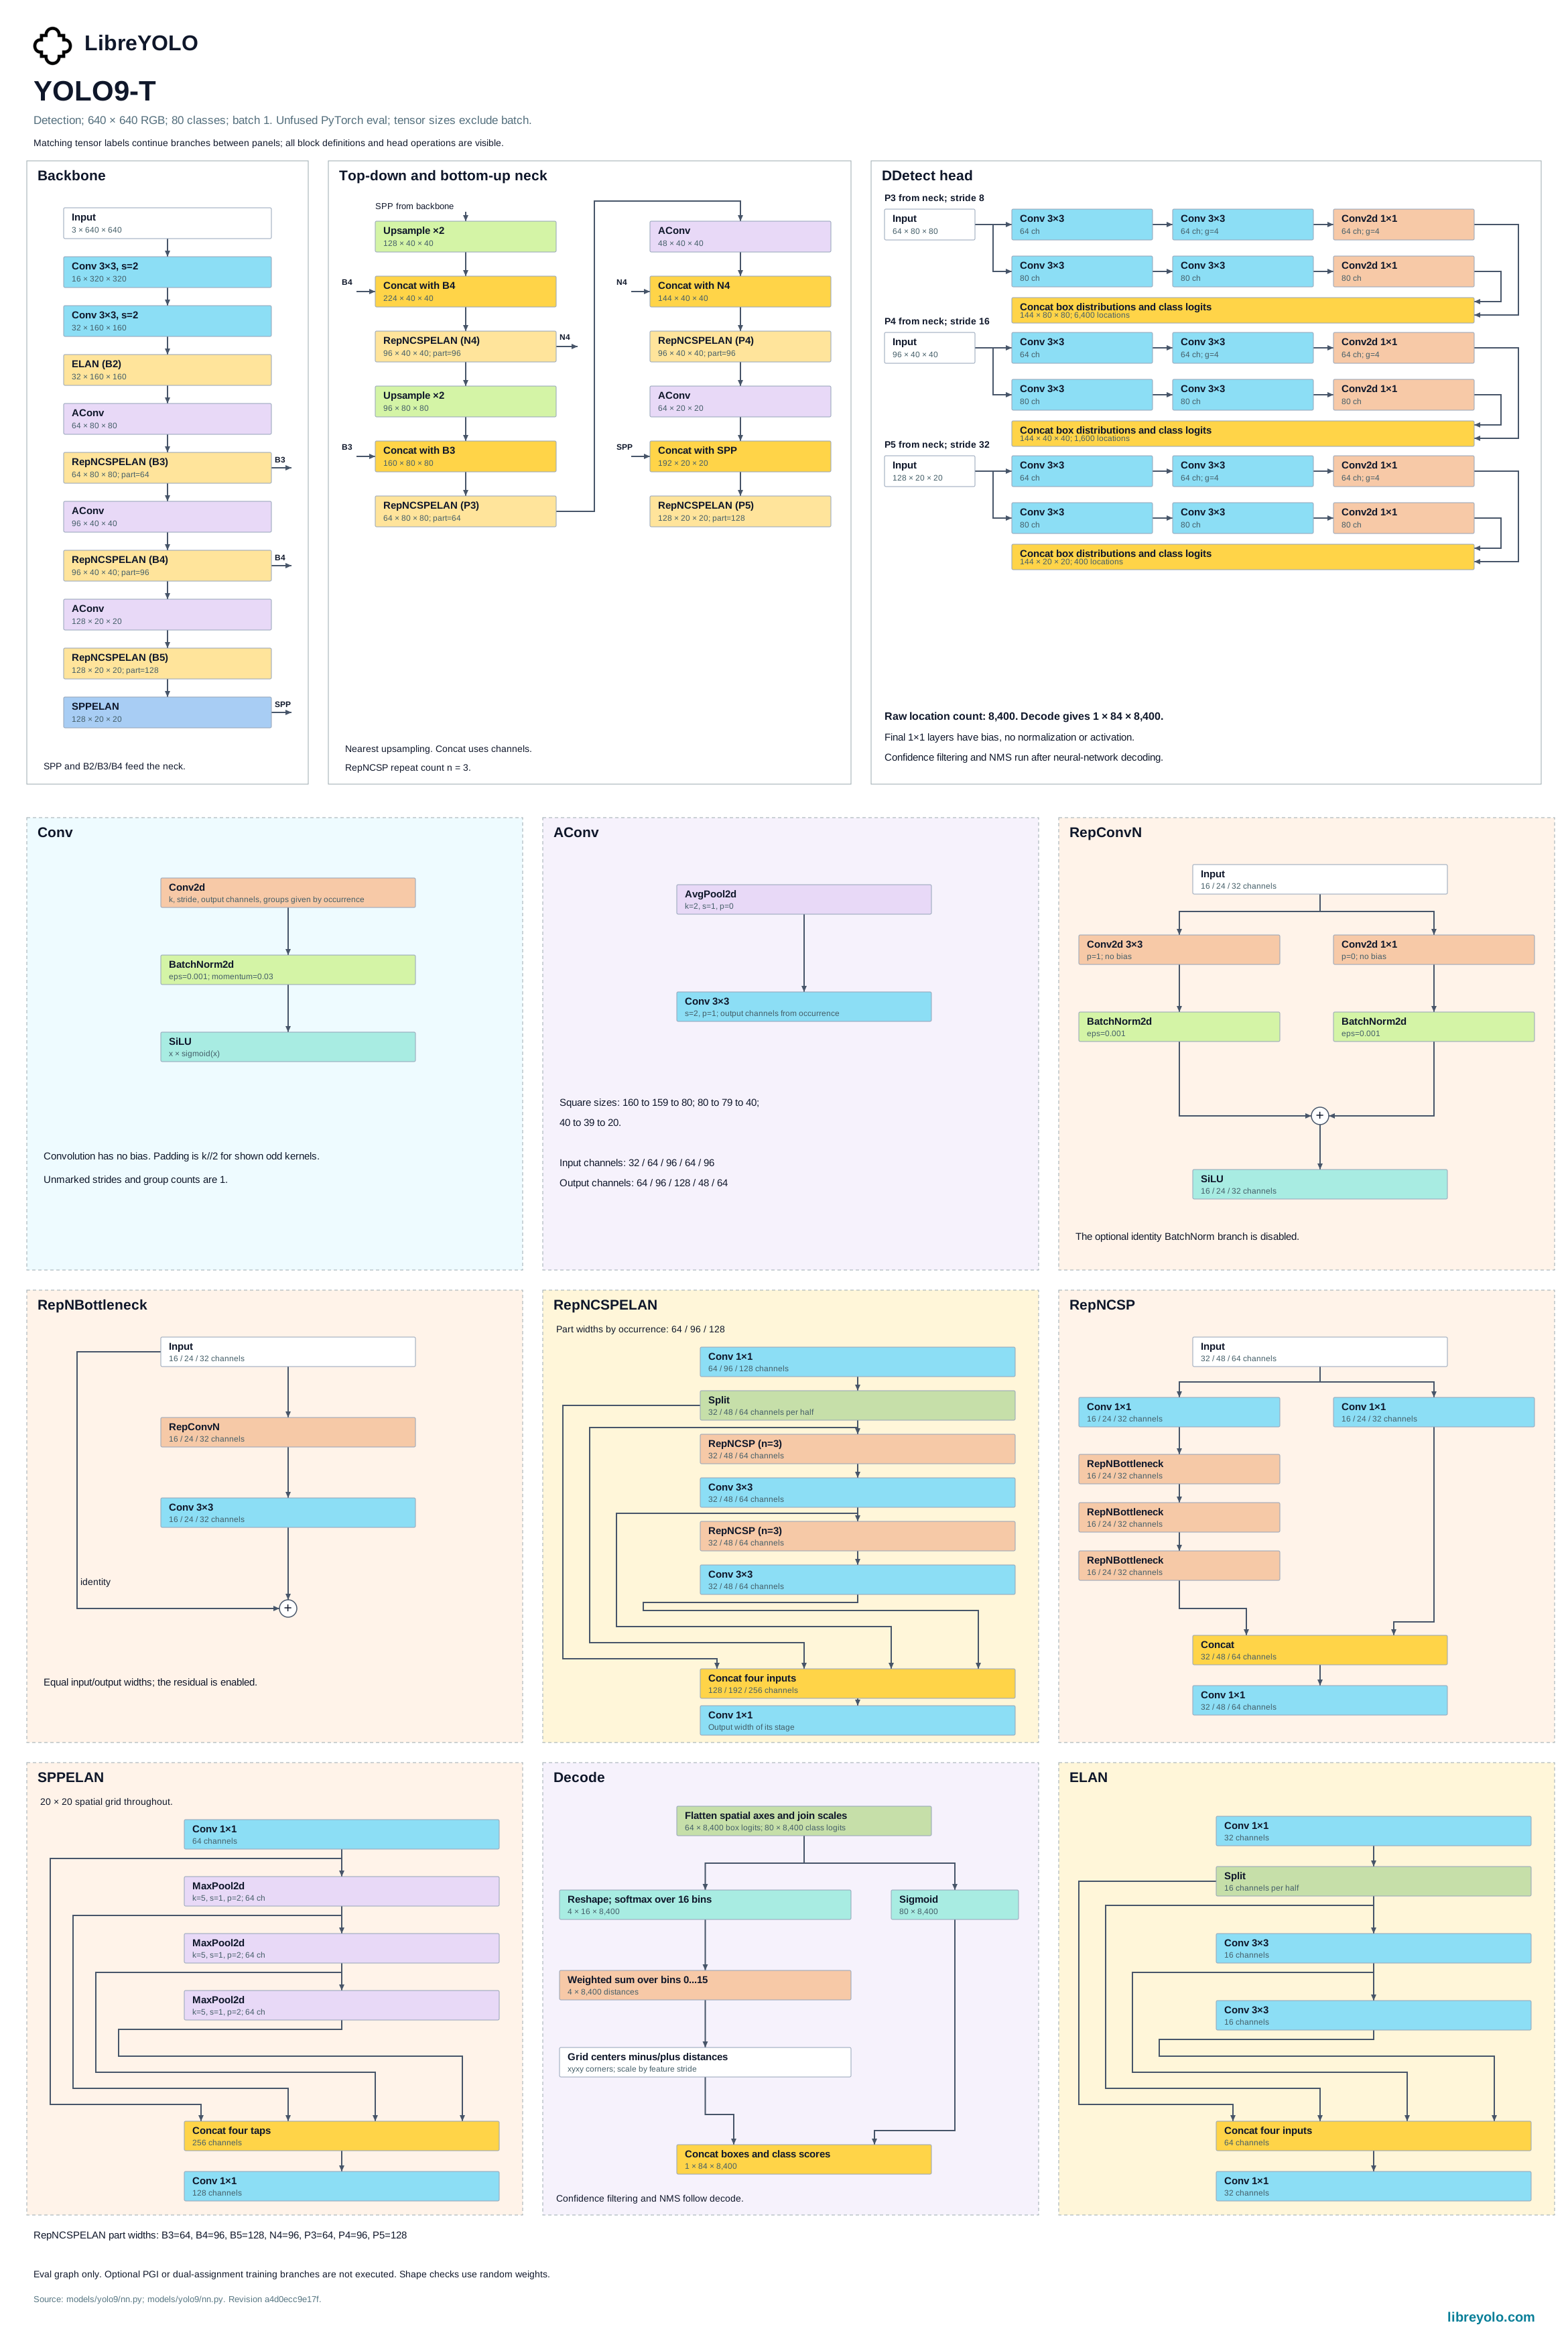
Trzy warianty korzystają ze wspólnego backbone. Wszystkie trzy służą wyłącznie do detekcji i przyjmują te same argumenty.
Model bazowy wykonuje predykcję na trzech skalach cech i usuwa zduplikowane ramki za pomocą NMS.
Model end-to-end zachowuje tę głowicę i dodaje obok niej gałąź dopasowania jeden do jednego. Wnioskowanie odczytuje wyłącznie gałąź jeden do jednego i wybiera jej predykcje z najwyższymi wynikami, dlatego NMS nie jest wykonywane. Wybierz ten model, gdy docelowe środowisko uruchomieniowe nie ma operatora NMS.
Model z krokiem 4 udostępnia jeden poziom wcześniej w backbone, rozszerza do niego moduł neck i wykonuje predykcję na czterech skalach zamiast trzech. Dodatkowa skala jest przeznaczona dla obiektów obejmujących niewiele pikseli. Jedyny opublikowany dla niej punkt kontrolny wytrenowano na obrazach lotniczych. Bazowe punkty kontrolne detekcji można do niego przenieść: backbone i neck są ładowane bez zmian, trzy wstępnie wytrenowane wieże głowicy przesuwają się o jedną pozycję, a wieża z krokiem 4 zaczyna od losowej inicjalizacji.
| Checkpoint modelu | Wejście (px) | mAP 50-95 | Parametry (mln) |
|---|---|---|---|
| LibreYOLO9c | 640 | 56.4 | 25.5 |
| LibreYOLO9m | 640 | 55.3 | 20.12 |
| LibreYOLO9s | 640 | 55.9 | 7.2 |
| LibreYOLO9t | 640 | 41.8 | 2.04 |
COCO val2017, 500 images. Wyniki zmierzono za pomocą zestawu benchmarkowego LibreYOLO i opublikowano w Vision Analysis, gdzie porównywane są opóźnienia na różnych urządzeniach i w różnych środowiskach uruchomieniowych oraz znajdują się pełne zapisy przebiegów.
Trenowanie
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.train(data="my-dataset.yaml", epochs=100, imgsz=640, batch=16)libreyolo train model=LibreYOLO9s.pt data=my-dataset.yaml \ epochs=100 imgsz=640 batch=16from libreyolo import LibreYOLO9P2 # Wariant z krokiem 4 nie ma własnego punktu kontrolnego COCO, dlatego należy# wskazać bazowy punkt kontrolny detekcji: backbone i neck zostaną załadowane# bez zmian, a wieża głowicy z krokiem 4 rozpocznie od losowej inicjalizacji.model = LibreYOLO9P2(None, size="s")model.train(data="my-dataset.yaml", epochs=100, pretrained="LibreYOLO9s.pt")Parametr pretrained określa punkt początkowy przebiegu. Przekaż True, aby
załadować opublikowany punkt kontrolny tego samego modelu i rozmiaru, albo nazwę
lub ścieżkę do dowolnego innego. Tensory o niedopasowanym kształcie są pomijane,
a nie odrzucane, a przebieg zapisuje liczbę załadowanych tensorów. Dzięki temu
punkt kontrolny wytrenowany z inną liczbą klas nadal nadaje się na punkt początkowy.
Model z krokiem 4 nie ma własnego opublikowanego punktu kontrolnego COCO, dlatego
True wskazuje w tym przypadku nieistniejący plik, a pobieranie kończy się
niepowodzeniem. Zamiast tego wskaż bazowy punkt kontrolny detekcji.
Informacje o zbiorach danych, augmentacji, wielu GPU i loggerach znajdziesz w sekcji trenowanie.
Model bazowy może trenować pomocniczą gałąź PGI obok głównej głowicy. Gałąź jest
używana tylko podczas trenowania: predykcja i eksport używają głównej głowicy.
Uruchomienie dołącza ją, gdy wagi startowe zawierają tensory PGI albo gdy
trenuje od zera. Opublikowane checkpointy bazowe nie zawierają żadnego, więc
dostrajanie z nich trenuje tylko główną głowicę i to odnotowuje w logu.
aux_weight=0.25 mimo to dołącza nową gałąź z tą wagą funkcji straty, a
aux_weight=0 zostawia ją wyłączoną. Wznowione uruchomienie zachowuje
konfigurację PGI ze swojego checkpointu. W rozmiarach m i c gałąź jest tą z
oryginału: drugi backbone na obrazie wejściowym, którego etapy CBFuse sumuje z
odczytami CBLinear z głównego backbone, oraz własna głowica, czyli 12.8M i
25.7M parametrów używanych tylko podczas trenowania przy 80 klasach. Modele
end-to-end i z krokiem 4 nie mają gałęzi PGI.
Wszystkie trzy warianty obcinają normę L2 gradientu do 10 przed każdym krokiem
optymalizatora; clip_max_norm=0 wyłącza obcinanie. Przypisanie etykiet ocenia
kotwice w fp32, także przy autocast float16. max_labels=300 ogranicza liczbę
ramek zachowanych na obraz treningowy, a ramki ponad ten limit są odrzucane z
jednorazowym ostrzeżeniem; pamięć przypisania zależy od rzeczywistych ramek
każdego obrazu, a nie od limitu. Momentum SGD rośnie z 0.8 do 0.937 w trakcie
trzech epok. letterbox_pad=None dziedziczy znacznik checkpointu: nieoznaczone
wagi używają topleft, a nowe oficjalne konwersje zapisują center.
Mosaic w YOLO9 i YOLOX preferuje obrazy z adnotacjami, wykonując najwyżej 20 losowań; MixUp w YOLO9 stosuje tę samą regułę. MixUp jest domyślnie wyłączony (mixup_prob=0). Gdy jest włączony, współczynnik mieszania jest losowany z rozkładu Beta(1, 1), jednostajnego na [0, 1], tak jak w MultimediaTechLab/YOLO. Profile wejścia inne niż RGB opisano w sekcji histogramów zdarzeń.
Walidacja
Metoda val() zwraca słownik kluczy metrics/ obejmujących precyzję, czułość,
mAP 50 i mAP 50-95, mierzone na dowolnym zbiorze danych w formacie użytym do trenowania.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mAP50-95"])print(metrics["metrics/mAP50"])libreyolo val model=LibreYOLO9s.pt data=my-dataset.yaml# Dołączony plik yaml COCO zawiera osadzony skrypt pobierania, dlatego wymaga# jawnego zezwolenia, chyba że zbiór danych jest już dostępny lokalnie.libreyolo val model=LibreYOLO9c.pt data=coco.yaml imgsz=640 \ allow_download_scripts=TrueEksport
| Zadanie | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Detection | Detection to ONNX: obsługiwane | Detection to TorchScript: obsługiwane | Detection to ExecuTorch: obsługiwane | Detection to TensorRT: obsługiwane | Detection to OpenVINO: obsługiwane | Detection to Paddle: obsługiwane | Detection to MNN: obsługiwane | Detection to RKNN: brak obsługi | Detection to ncnn: obsługiwane | Detection to TFLite: brak obsługi | Detection to CoreML: brak obsługi | Detection to Core AI: obsługiwane |
Znacznik wyboru dotyczy wszystkich trzech wariantów. Jeśli ich obsługa formatu się różni, macierz podaje najsłabszy poziom spośród trzech.
Wyeksportowany artefakt jest ponownie ładowany przez LibreYOLO() na podstawie
rozszerzenia pliku, więc plik .onnx lub .engine zachowuje się jak punkt
kontrolny i zwraca ten sam obiekt Results. Obsługiwane jest także uruchamianie
grafu w samym środowisku uruchomieniowym bez zainstalowanego LibreYOLO, ale wówczas
samodzielnie trzeba zaimplementować przetwarzanie wstępne i końcowe.
Dla bazowego modelu detekcji część przetwarzania końcowego można przenieść do
grafu. Ustawienie nms=True podczas eksportu ONNX umieszcza tłumienie wewnątrz
modelu, a pierwszy wynik staje się stałym tensorem (1, max_det, 6), którego
wiersze mają postać x1, y1, x2, y2, score, class i są dopełniane zerami po
liczbie detekcji. Taki graf ma partię 1 i nie zawiera osi dynamicznych. Modele
end-to-end i z krokiem 4 nie przyjmują tej flagi.
Każdy format instaluje inny dodatek i przyjmuje kilka własnych argumentów. Obie informacje znajdują się na stronie danego formatu.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.export(format="onnx", imgsz=640)libreyolo export model=LibreYOLO9s.pt format=onnx imgsz=640libreyolo export model=LibreYOLO9s.pt format=onnx nms=True \ conf=0.25 iou=0.45 max_det=300from libreyolo import LibreYOLO, SAMPLE_IMAGE # Fabryka wybiera ścieżkę na podstawie rozszerzenia pliku, dlatego# artefakt ładuje się jak punkt kontrolny i zwraca ten sam obiekt Results.model = LibreYOLO("LibreYOLO9s.onnx")result = model(SAMPLE_IMAGE) print(result.boxes.xyxy)TFLite INT8 używa int8=True z danymi kalibracyjnymi.
Wejścia i wyjścia ONNX
LibreYOLO9
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Kolor | RGB |
| Skalowanie | piksel / 255 |
| Normalizacja | brak |
| Zmiana rozmiaru | letterbox, bilinear, wartość wypełnienia 114, pozycja wypełnienia z klucza metadanych letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
Detection, eksport domyślny
| Wyjście | Kształt | Znaczenie |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Przetwarzanie końcowe
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Detection, nms=True
| Wyjście | Kształt | Znaczenie |
|---|---|---|
output | [1, max_det, 6] | Rows are x1, y1, x2, y2, score, class in input-canvas pixels, zero-padded past the detection count. Confidence, IoU and max_det are baked in and recorded as nms_conf, nms_iou and max_det metadata. |
raw | [1, 4 + nc, anchors] | The same tensor as the default export's output, before suppression. |
Przetwarzanie końcowe
- Drop rows whose score is 0 or below your threshold.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
LibreYOLO9E2E
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Kolor | RGB |
| Skalowanie | piksel / 255 |
| Normalizacja | brak |
| Zmiana rozmiaru | letterbox, bilinear, wartość wypełnienia 114, pozycja wypełnienia z klucza metadanych letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, eksport domyślny
| Wyjście | Kształt | Znaczenie |
|---|---|---|
output | [batch, 4 + nc, anchors] | Predictions of the one-to-one head only. Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Przetwarzanie końcowe
- Transpose to [anchors, 4 + nc].
- Flatten the [anchors, nc] scores into one list of anchors x nc (anchor, class) pairs. Pair i belongs to anchor i / nc (integer division) and class i % nc.
- Keep the 300 highest-scoring pairs (max_det), highest first. One anchor can yield several classes.
- Of those, keep the pairs whose score is above the confidence threshold (0.25 by default).
- Do not run NMS. The one-to-one head is trained to fire once per object, and LibreYOLO ignores the iou setting for this model.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
LibreYOLO9P2
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Kolor | RGB |
| Skalowanie | piksel / 255 |
| Normalizacja | brak |
| Zmiana rozmiaru | letterbox, bilinear, wartość wypełnienia 114, pozycja wypełnienia z klucza metadanych letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, eksport domyślny
| Wyjście | Kształt | Znaczenie |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 4, 8, 16 and 32, 34000 at 640 x 640. nc is 10 for LibreYOLO9P2s-visdrone. |
Przetwarzanie końcowe
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Aby sprawdzić własną implementację, uruchom ten sam plik w LibreYOLO: LibreYOLO("model.onnx").predict("image.jpg") zwraca wyniki wzorcowe. Zweryfikowano w LibreYOLO 1.7.0.
Punkty kontrolne
Wszystkie opublikowane pliki wag dla tej rodziny.
| Plik | Wejście (px) | Licencja wag |
|---|---|---|
| Detection | ||
| LibreYOLO9t.pt | 640 | mit |
| LibreYOLO9s.pt | 640 | mit |
| LibreYOLO9m.pt | 640 | mit |
| LibreYOLO9c.pt | 640 | mit |
| LibreYOLO9E2Et.pt | 640 | mit |
| LibreYOLO9E2Es.pt | 640 | mit |
| LibreYOLO9E2Em.pt | 640 | mit |
| LibreYOLO9E2Ec.pt | 640 | mit |
| LibreYOLO9P2s-visdrone.pt | cc-by-nc-sa-3.0 | |
Każdy z powyższych plików jest obecnie dostępny w organizacji LibreYOLO i pobierany przy pierwszym użyciu.
Licencjonowanie
Sprawdź licencję w repozytorium konkretnych pobieranych wag na Hugging Face. Każdy checkpoint w organizacji LibreYOLO ma licencję, która nie zawsze jest taka sama w całej rodzinie. To repozytorium jest źródłem rozstrzygającym, a poniższe podsumowanie opisuje stan z chwili ostatniej weryfikacji tej strony.
To opis obowiązujących licencji, a nie porada prawna. Jeśli odpowiedź ma znaczenie komercyjne, przeczytaj licencje i zasięgnij własnej porady prawnej.
- Oryginalna praca
- YOLOv9, MultimediaTechLab
- Licencja projektu źródłowego
- MIT
- Kod źródłowy projektu
- github.com/MultimediaTechLab/YOLO
- Kod LibreYOLO
- MIT
- Wagi
- MIT, ponownie opublikowane w huggingface.co/LibreYOLO
- Interpretacja
- MIT is a permissive license, so these weights can be used in commercial and closed-source products. The one standing obligation is to keep the license text and the copyright notice, Kin-Yiu Wong and Hao-Tang Tsui, with any copy you redistribute. It places no condition on your own application code, and a model you train yourself on your own data is yours. Two things are worth knowing beyond that. The code is ported from the authors' MIT re-release of YOLOv9, MultimediaTechLab/YOLO at commit c4cb5f6f, not the GPL-3.0 repository that carries the same model, so the permissive terms come from the source LibreYOLO actually derives from. And one checkpoint in this family is not MIT: the weight repository of the stride-4 VisDrone model, LibreYOLO9P2s-visdrone.pt, declares CC BY-NC-SA 3.0, which rules out commercial use and requires share-alike on derivatives.
Kod wszystkich trzech wariantów jest przeniesiony z
MultimediaTechLab/YOLO z commita
c4cb5f6f (MIT). Predyktor one-to-one modelu end-to-end podąża za projektem
DATE autorstwa Yiqun Chen
(Apache-2.0), zaimplementowanym dla LibreYOLO bez kopiowania kodu DATE. Poziom o
kroku 4 to kod LibreYOLO.
Checkpoint do zdjęć lotniczych z krokiem 4 przewiduje klasy VisDrone. Należy stosować licencję zadeklarowaną przez wydawcę w repozytorium wag.
Cytowanie
@inproceedings{wang2024yolov9,
      title={{YOLOv9}: Learning What You Want to Learn Using Programmable Gradient Information},
      author={Wang, Chien-Yao and Yeh, I-Hau and Liao, Hong-Yuan Mark},
      year={2024},
      booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
}
Skopiowano z bloku cytowania autorów w github.com/MultimediaTechLab/YOLO#citations.