MiDaS
MiDaS là mô hình ước lượng độ sâu tương đối đơn ảnh được huấn luyện bằng loss bất biến theo scale và shift trên các dataset hỗn hợp, hướng nghiên cứu đã thiết lập giao thức transfer độ sâu zero-shot mà các họ sau này dùng lại. LibreYOLO hỗ trợ mô hình cho tác vụ độ sâu: dự đoán và xác thực zero-shot, không có tuyến huấn luyện.
- Tác vụ
- depth
- Kích thước
- s, l at 256 to 384 px
- Cài đặt
pip install "libreyolo[midas]"- Bậc hỗ trợ
- Chỉ suy luận, từ v1.5.0. Chỉ dự đoán, kiểm định và xuất. Không áp dụng các tính năng huấn luyện.
- Giấy phép
- Mã nguồn MIT, trọng số MIT. Sử dụng thương mại
Cài đặt
MiDaS cần extra midas cho các bộ mã hóa timm.
pip install "libreyolo[midas]"Dự đoán
Checkpoint s và l được tải từ các bản sao của LibreYOLO theo giấy phép MIT của nhà phát hành và được lưu vào bộ nhớ đệm cục bộ.
from libreyolo import LibreYOLO, SAMPLE_IMAGE # Tải bản sao checkpoint ở lần dùng đầu tiênmodel = LibreYOLO("LibreMiDaSl-depth.pt")result = model(SAMPLE_IMAGE, save=True) depth = result.depth_mapprint(depth.min, depth.max, depth.mean)libreyolo predict model=LibreMiDaSl-depth.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Encoder EfficientNet-Lite3, nhỏ và nhanh hơn kích thước l DPT-Large.model = LibreYOLO("LibreMiDaSs-depth.pt")result = model(SAMPLE_IMAGE, save=True)result.depth_map chứa bản đồ độ sâu nghịch đảo tương đối dày đặc: giá trị cao hơn nghĩa là gần camera hơn, và các giá trị không có đơn vị đo lường hay thang đo chung giữa các ảnh. save=True ghi bản trực quan hóa tô màu của bản đồ này ra đĩa; Results.plot() dựng bản đồ độ sâu. Xem dự đoán để biết nguồn đầu vào, streaming và cách xử lý kết quả.
Biến thể
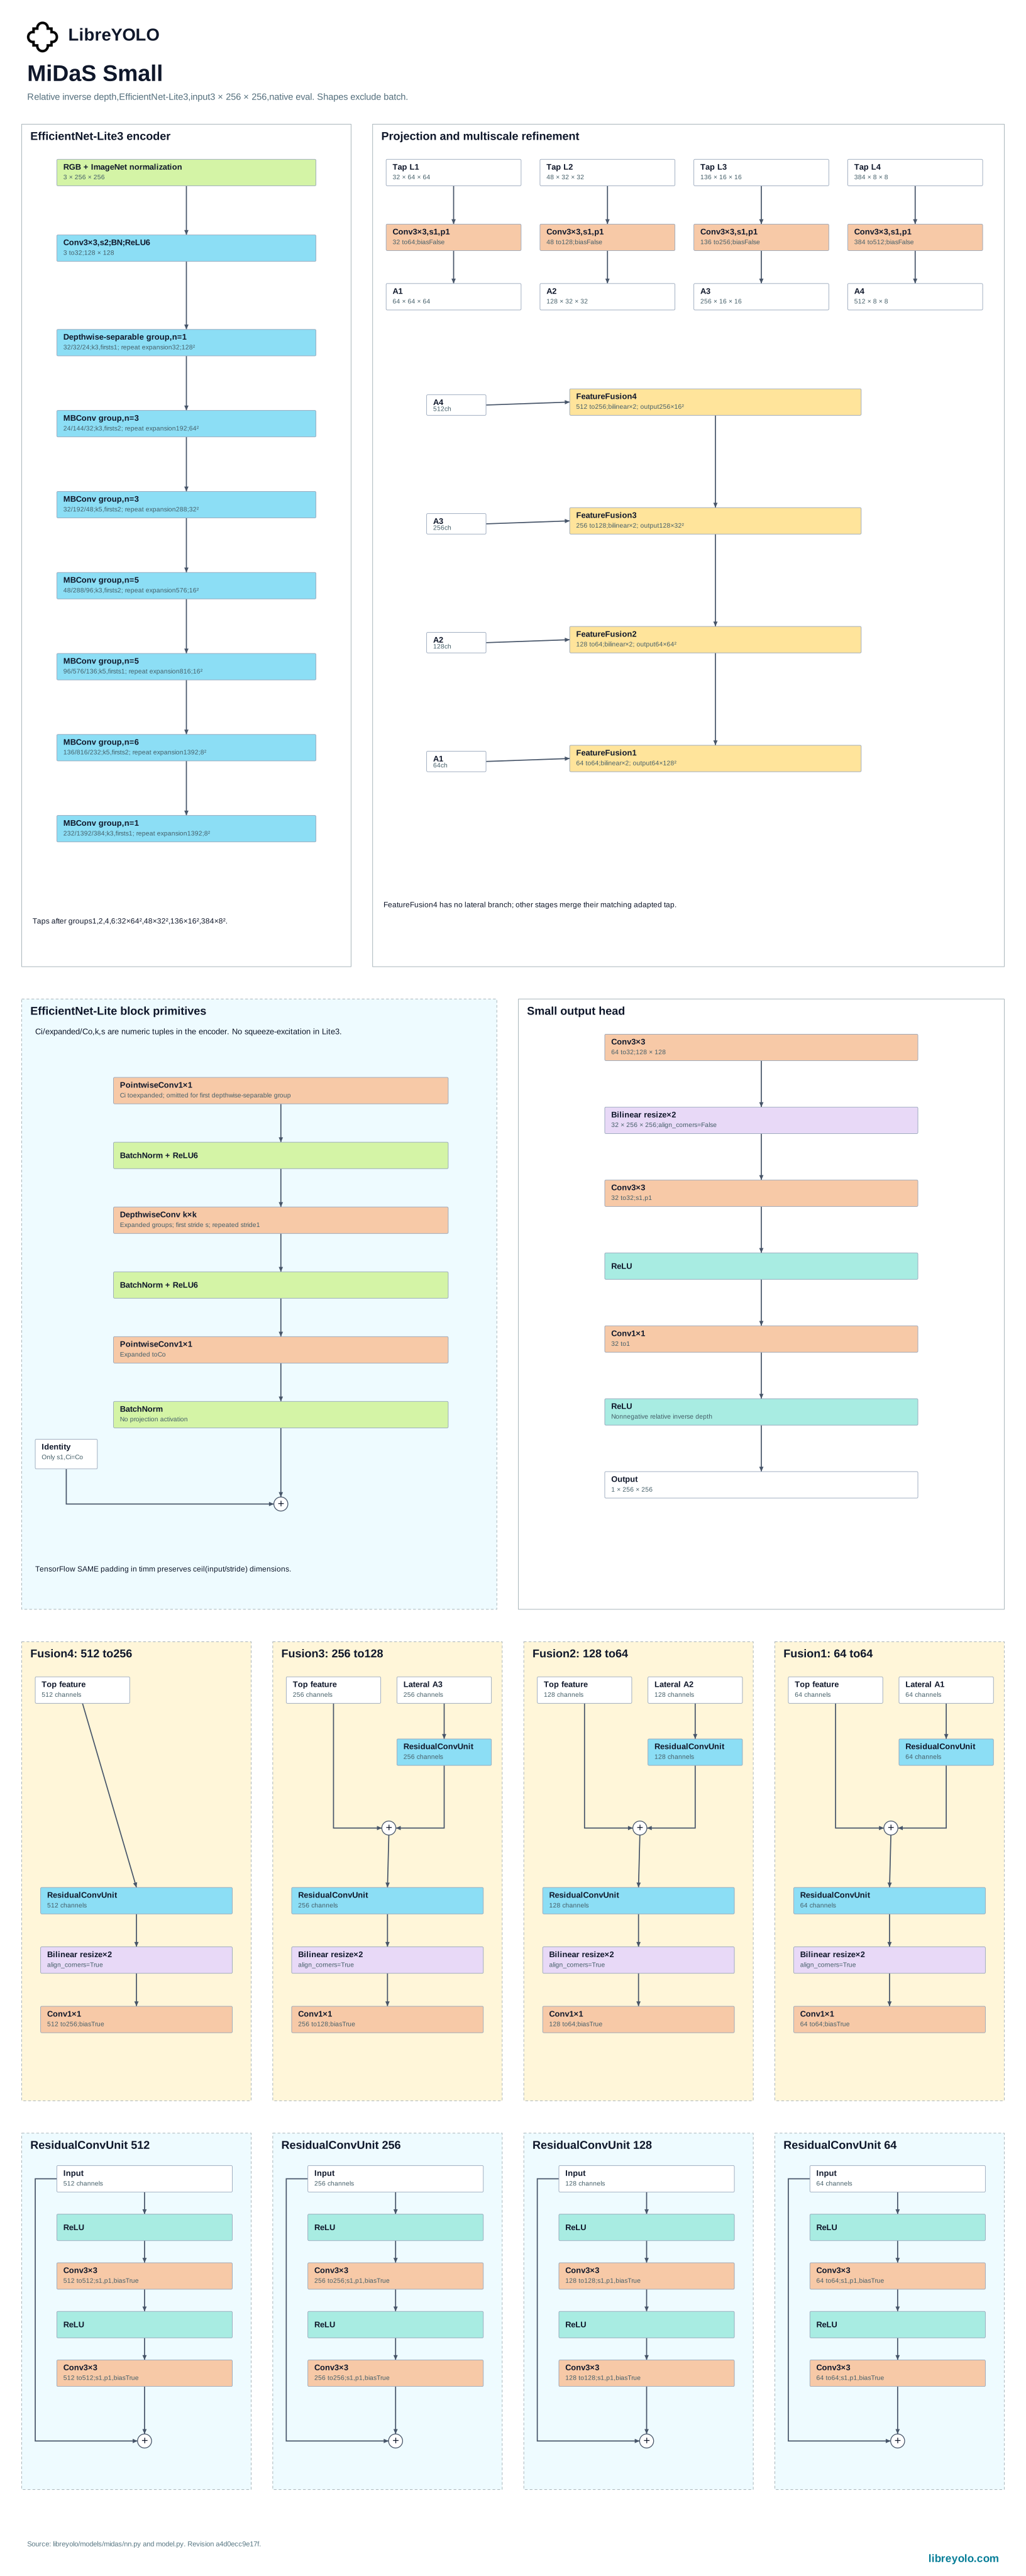
Có hai biến thể với encoder khác nhau, không chỉ là các scale khác nhau của cùng một encoder. s là MiDaS v2.1 Small, một encoder EfficientNet-Lite3. l là DPT-Large, encoder ViT-L/16 với decoder DPT mà MiDaS đưa vào cho dự đoán dense. Chúng cũng tiền xử lý khác nhau: s dùng phép đổi kích thước theo tỷ lệ với giới hạn trên cùng chuẩn hóa mean/std ImageNet, còn l dùng phép đổi kích thước theo tỷ lệ tối thiểu với mean và std 0.5. Chọn s cho CNN nhẹ hơn, l cho độ chính xác của transformer decoder.
Họ mô hình này không cung cấp huấn luyện. LibreMiDaS.train() luôn phát sinh NotImplementedError.
Xác thực
val() chạy trình xác thực độ sâu dùng chung: hàm căn chỉnh từng dự đoán với ground truth bằng scale và shift bình phương tối thiểu theo từng ảnh, rồi báo cáo các metric độ sâu tương đối zero-shot tiêu chuẩn là AbsRel, RMSE và ba ngưỡng delta.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/abs_rel"])print(metrics["metrics/rmse"])print(metrics["metrics/delta1"])libreyolo val model=LibreMiDaSl-depth.pt data=my-dataset.yamlXuất
| Tác vụ | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Depth | Depth to ONNX: được hỗ trợ | Depth to TorchScript: được hỗ trợ | Depth to ExecuTorch: được hỗ trợ | Depth to TensorRT: được hỗ trợ | Depth to OpenVINO: được hỗ trợ | Depth to Paddle: không được hỗ trợ | Depth to MNN: không được hỗ trợ | Depth to RKNN: không được hỗ trợ | Depth to ncnn: được hỗ trợ | Depth to TFLite: không được hỗ trợ | Depth to CoreML: không được hỗ trợ | Depth to Core AI: không được hỗ trợ |
Artifact đã xuất được tải lại qua LibreYOLO() dựa trên hậu tố tệp, vì vậy tệp .onnx hoặc .engine hoạt động như checkpoint và trả về cùng đối tượng Results, với depth_map thay cho box.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreMiDaSl-depth.pt format=onnxlibreyolo export model=LibreMiDaSl-depth.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Factory định tuyến dựa trên hậu tố tệp, vì vậy artifact đã xuất tải# như mọi checkpoint và trả về cùng đối tượng Results.model = LibreYOLO("LibreMiDaSl-depth.onnx")result = model(SAMPLE_IMAGE) print(result.depth_map.data.shape)Giấy phép
Hãy kiểm tra giấy phép trong repo Hugging Face của trọng số cụ thể mà bạn tải xuống. Mỗi checkpoint trong tổ chức LibreYOLO đều có giấy phép riêng và giấy phép có thể khác nhau trong cùng một họ. Repo đó là nguồn có thẩm quyền; phần tóm tắt dưới đây mô tả các điều khoản áp dụng khi trang này được kiểm chứng lần gần nhất.
Đây là phần mô tả các giấy phép liên quan, không phải tư vấn pháp lý. Nếu câu trả lời có ý nghĩa về mặt thương mại, hãy tự đọc các giấy phép và tham khảo cố vấn của riêng bạn.
- Công trình gốc
- MiDaS, Intel Intelligent Systems Lab (Intel ISL)
- Giấy phép thượng nguồn
- MIT
- Nguồn thượng nguồn
- github.com/isl-org/MiDaS
- Mã nguồn LibreYOLO
- MIT
- Trọng số
- MIT, được phát hành lại tại huggingface.co/LibreYOLO
- Diễn giải
- The upstream repository and released weights declare MIT. LibreYOLO mirrors the s and l checkpoints under that publisher grant.
Trích dẫn
@ARTICLE {Ranftl2022,
    author  = "Ren\'{e} Ranftl and Katrin Lasinger and David Hafner and Konrad Schindler and Vladlen Koltun",
    title   = "Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-Shot Cross-Dataset Transfer",
    journal = "IEEE Transactions on Pattern Analysis and Machine Intelligence",
    year    = "2022",
    volume  = "44",
    number  = "3"
}

@article{Ranftl2021,
	author    = {Ren\'{e} Ranftl and Alexey Bochkovskiy and Vladlen Koltun},
	title     = {Vision Transformers for Dense Prediction},
	journal   = {ICCV},
	year      = {2021},
}
Được sao chép từ khối trích dẫn của tác giả tại github.com/isl-org/MiDaS#citation.