YOLOv9
Một detector tích chập một giai đoạn: một lượt chấm điểm lưới box dày đặc và NMS loại các bản trùng lặp. LibreYOLO cung cấp ba biến thể, trong đó một biến thể không có bước NMS.
- Tác vụ
- detection
- Kích thước
- yolo9: t, s, m, c at 640 px; yolo9_p2: t, s at 640 px
- Cài đặt
pip install libreyolo- Bậc hỗ trợ
- Chủ lực, từ v1.0.0. Các tính năng được thiết kế và kiểm chứng đầy đủ trên GPU ở bậc này trước tiên.
- Giấy phép
- Mã nguồn MIT, trọng số MIT. Sử dụng thương mại
Cài đặt
YOLOv9 không cần extra ngoài gói cơ sở.
pip install libreyoloDự đoán
Trọng số được tải từ Hugging Face ở lần dùng đầu tiên và lưu vào bộ nhớ đệm cục bộ.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreYOLO9s.pt")result = model(SAMPLE_IMAGE, save=True) for box in result.boxes: print(box.cls, box.conf, box.xyxy)libreyolo predict model=LibreYOLO9s.pt save=True \ source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpgfrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Cùng lời gọi, checkpoint khác. Head đầu cuối tự trả về các dự đoán có# điểm cao nhất, nên NMS không chạy và iou bị bỏ qua.model = LibreYOLO("LibreYOLO9E2Es.pt")result = model(SAMPLE_IMAGE, conf=0.25, max_det=300) print(len(result.boxes))Đối tượng Results trả về là loại mà mọi họ đều trả về, nên việc đổi sang
detector khác chỉ cần sửa một dòng. Trên mô hình cơ sở và stride-4, conf đặt
ngưỡng độ tin cậy và iou đặt ngưỡng NMS. Mô hình đầu cuối không chạy NMS và bỏ
qua iou, vì vậy conf cùng max_det quyết định hình dạng đầu ra. Xem
dự đoán để biết về nguồn, streaming và xử lý kết quả.
Các biến thể
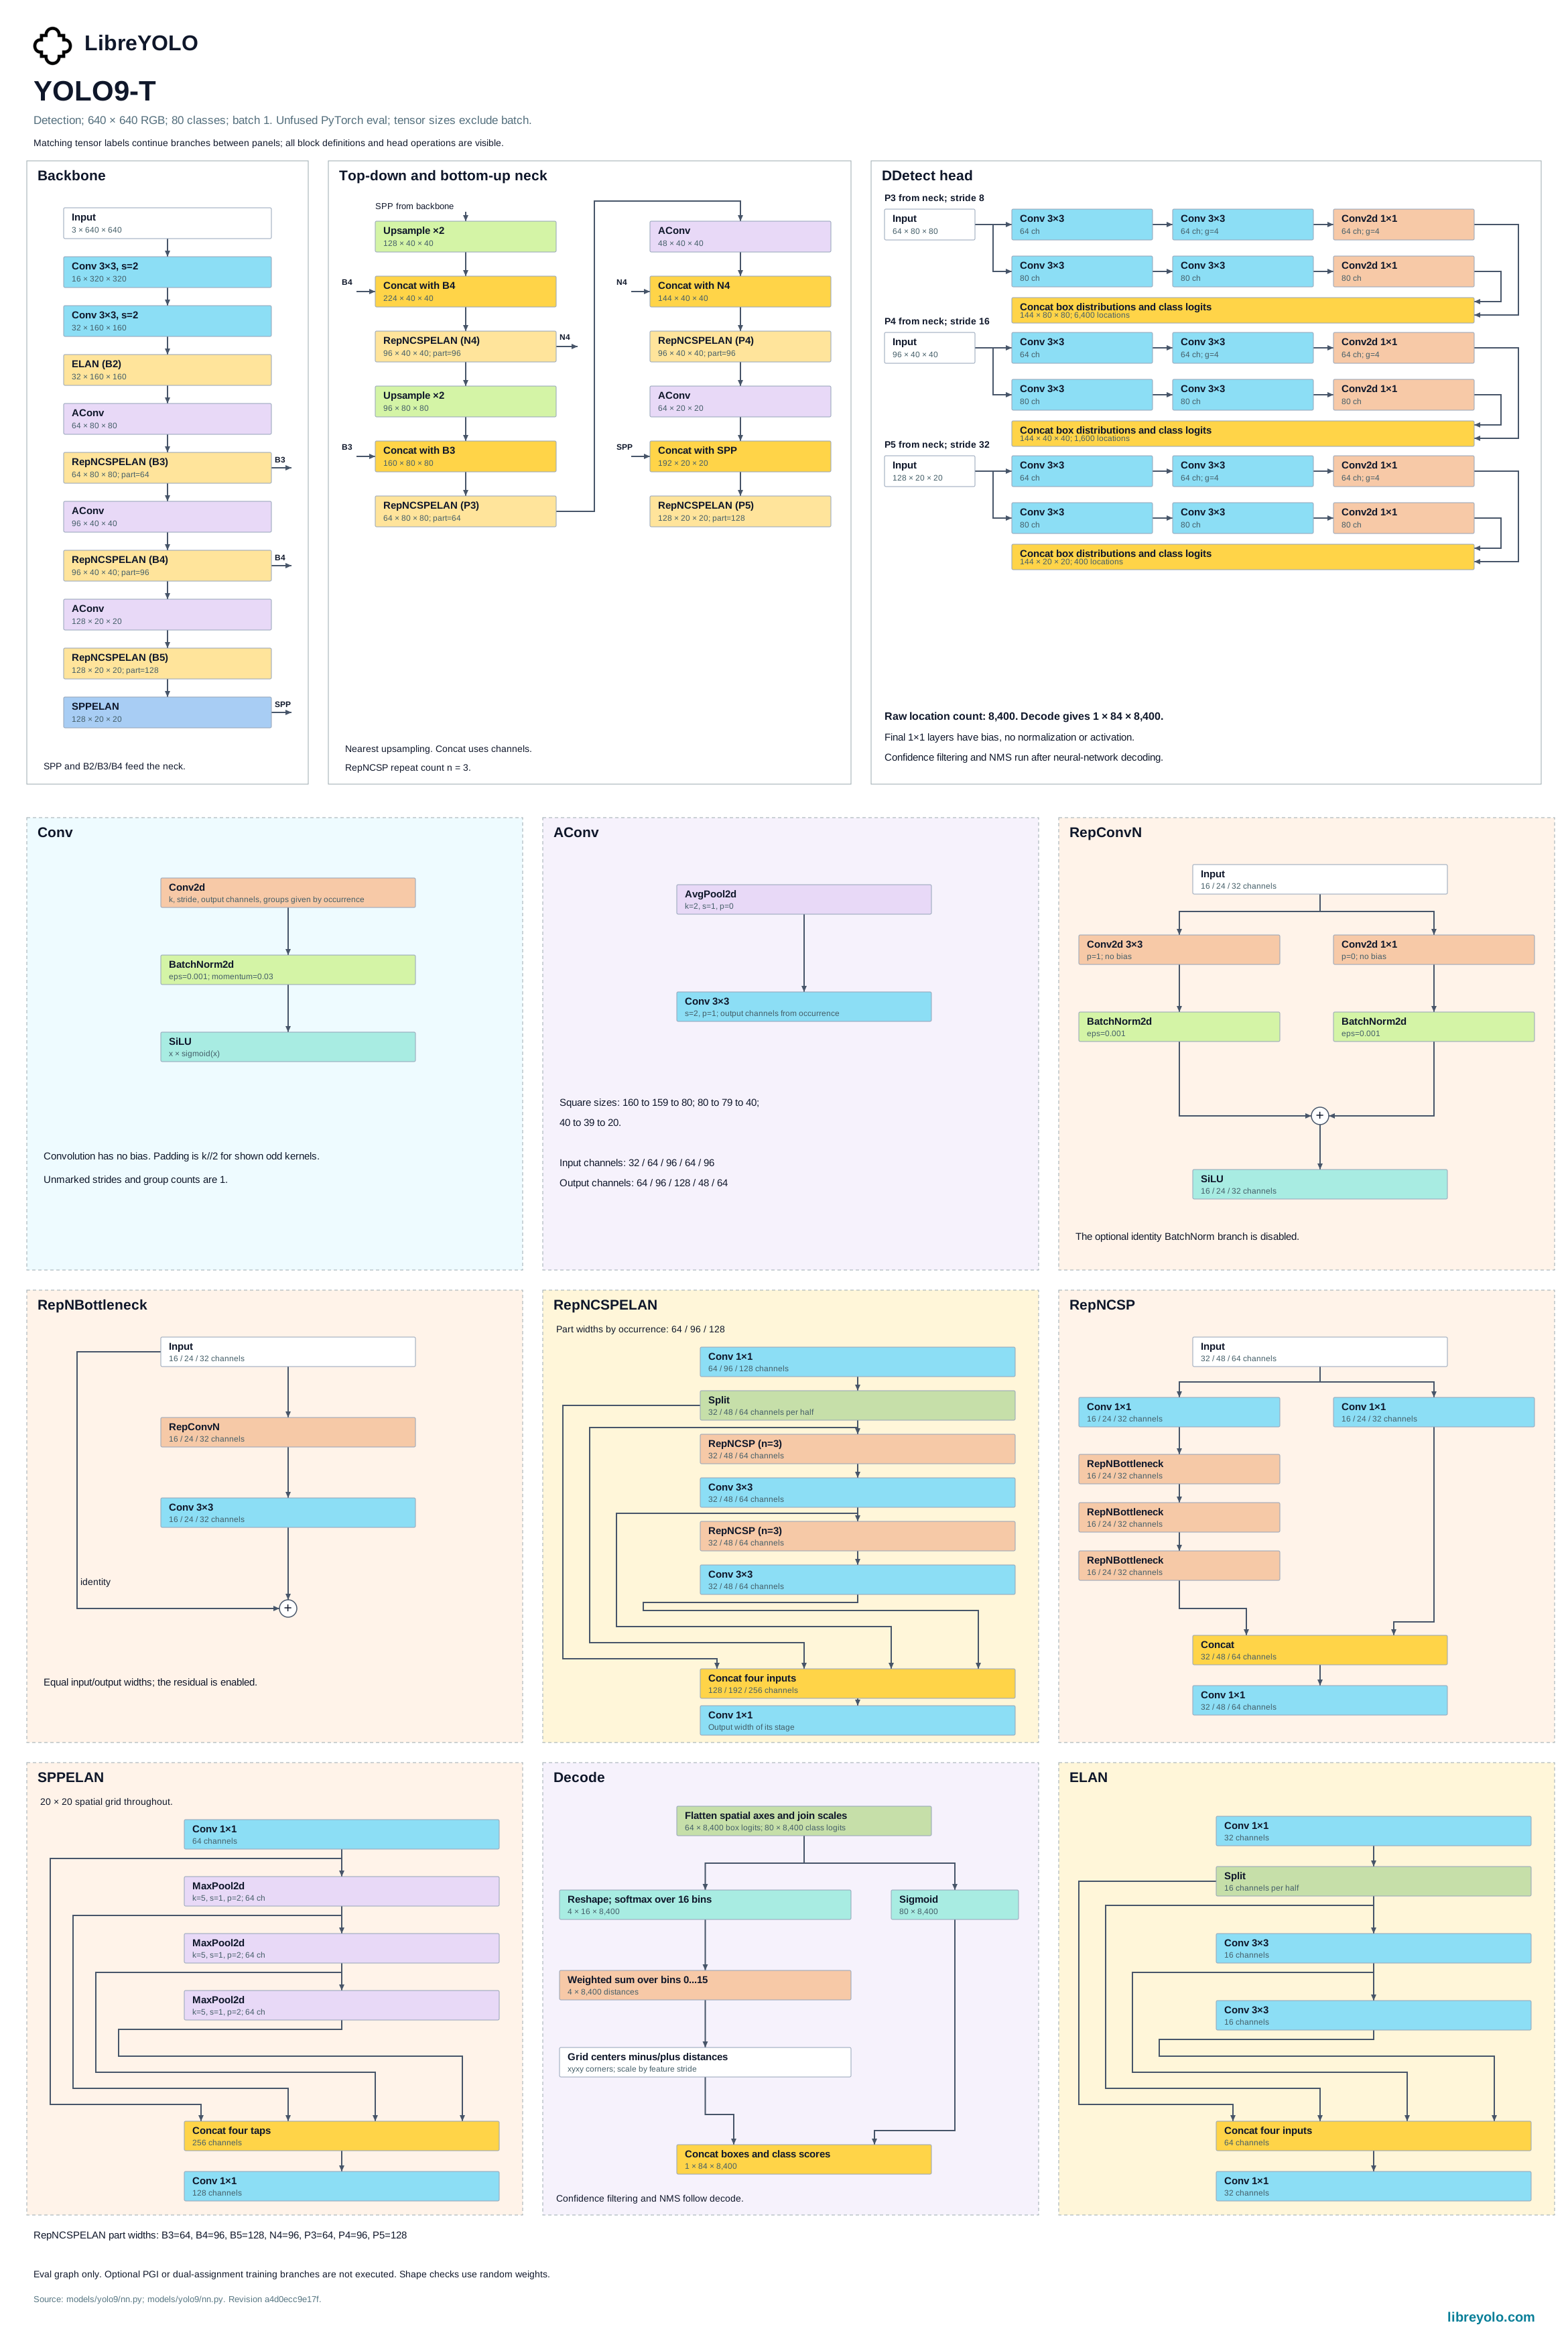
Ba biến thể dùng chung một backbone. Cả ba chỉ thực hiện phát hiện và nhận cùng các đối số.
Mô hình cơ sở dự đoán trên ba thang feature và loại box trùng lặp bằng NMS.
Mô hình đầu cuối giữ head đó và thêm một nhánh ghép một-một bên cạnh. Suy luận chỉ đọc nhánh một-một và lấy các dự đoán có điểm cao nhất, nên NMS không chạy. Chọn mô hình này khi runtime triển khai không có toán tử NMS.
Mô hình stride-4 đưa ra một cấp cao hơn trên backbone, mở rộng neck xuống cấp đó và dự đoán trên bốn thang thay vì ba. Thang bổ sung dành cho đối tượng chỉ chiếm ít pixel; checkpoint duy nhất đã công bố cho biến thể này được huấn luyện trên ảnh chụp từ trên không. Checkpoint phát hiện cơ sở có thể chuyển sang mô hình: backbone và neck được tải không đổi, ba tower head đã tiền huấn luyện dịch lên một vị trí, còn tower stride-4 bắt đầu từ khởi tạo ngẫu nhiên.
| Checkpoint | Đầu vào (px) | mAP 50-95 | Tham số (M) |
|---|---|---|---|
| LibreYOLO9c | 640 | 56.4 | 25.5 |
| LibreYOLO9m | 640 | 55.3 | 20.12 |
| LibreYOLO9s | 640 | 55.9 | 7.2 |
| LibreYOLO9t | 640 | 41.8 | 2.04 |
COCO val2017, 500 images. Được đo bằng bộ benchmark LibreYOLO và công bố trên Vision Analysis, nơi so sánh độ trễ giữa các phần cứng và runtime, đồng thời lưu trữ đầy đủ bản ghi của từng lần chạy.
Huấn luyện
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.train(data="my-dataset.yaml", epochs=100, imgsz=640, batch=16)libreyolo train model=LibreYOLO9s.pt data=my-dataset.yaml \ epochs=100 imgsz=640 batch=16from libreyolo import LibreYOLO9P2 # Biến thể stride-4 không có checkpoint COCO riêng, nên hãy chỉ định một# checkpoint phát hiện cơ sở: backbone và neck được tải không đổi, còn# tower của head stride-4 bắt đầu từ khởi tạo ngẫu nhiên.model = LibreYOLO9P2(None, size="s")model.train(data="my-dataset.yaml", epochs=100, pretrained="LibreYOLO9s.pt")pretrained quyết định điểm bắt đầu của lượt chạy. Truyền True để tải
checkpoint đã công bố cho cùng mô hình và kích thước, hoặc truyền tên hay đường
dẫn cho trường hợp khác. Tensor có shape không khớp sẽ bị bỏ qua thay vì bị từ
chối, và lượt chạy ghi lại số lượng đã tải, nên checkpoint được huấn luyện với
số lớp khác vẫn là điểm bắt đầu có thể dùng.
Mô hình stride-4 không có checkpoint COCO riêng đã công bố, nên True sẽ phân
giải thành tệp không tồn tại và tải xuống thất bại. Hãy chỉ định checkpoint phát
hiện cơ sở thay thế.
Xem huấn luyện để biết về tập dữ liệu, tăng cường dữ liệu, multi-GPU và logger.
Mô hình cơ sở có thể huấn luyện một nhánh phụ PGI bên cạnh head chính. Nhánh này
chỉ dùng khi huấn luyện: dự đoán và xuất dùng head chính. Một lần chạy gắn nhánh
này khi trọng số khởi đầu có chứa tensor PGI hoặc khi huấn luyện từ đầu. Các
checkpoint cơ sở đã công bố không chứa tensor nào, nên một lần tinh chỉnh từ
chúng chỉ huấn luyện head chính và ghi log điều đó. aux_weight=0.25 vẫn gắn một
nhánh mới với trọng số loss đó, còn aux_weight=0 giữ nhánh này tắt. Một lần
chạy được tiếp tục giữ nguyên thiết lập PGI của checkpoint. Trên các kích thước
m và c, nhánh này là nhánh của upstream: một backbone thứ hai trên ảnh đầu
vào, có các stage được CBFuse cộng với các điểm lấy CBLinear từ backbone
chính, cùng head riêng của nó, lần lượt là 12.8M và 25.7M tham số chỉ dùng khi
huấn luyện ở 80 lớp đối tượng. Các mô hình đầu cuối và stride-4 không có nhánh
PGI.
Cả ba biến thể cắt chuẩn L2 của gradient ở 10 trước mỗi bước optimizer;
clip_max_norm=0 tắt việc cắt. Việc gán nhãn chấm điểm các anchor ở fp32, kể cả
dưới autocast float16. max_labels=300 giới hạn số box được giữ trên mỗi ảnh
huấn luyện, và các box vượt giới hạn bị bỏ kèm một cảnh báo một lần; bộ nhớ gán
nhãn theo số box thực của từng ảnh, không theo giới hạn này. Momentum SGD tăng từ
0.8 lên 0.937 trong ba epoch. letterbox_pad=None kế thừa dấu ghi trong
checkpoint: trọng số không có dấu dùng topleft, còn các bản chuyển đổi chính
thức mới ghi center.
Mosaic của YOLO9 và YOLOX ưu tiên ảnh ghép có nhãn với tối đa 20 lần lấy mẫu; MixUp của YOLO9 dùng cùng chính sách. MixUp tắt theo mặc định (mixup_prob=0). Khi bật, tỉ lệ trộn được lấy từ Beta(1, 1), đồng đều trên [0, 1], như trong MultimediaTechLab/YOLO. Xem histogram sự kiện để biết hồ sơ đầu vào không phải RGB.
Đánh giá
val() trả về từ điển các khóa metrics/ bao gồm precision, recall, mAP 50 và
mAP 50-95, được đo trên bất kỳ tập dữ liệu nào theo định dạng bạn đã huấn luyện.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mAP50-95"])print(metrics["metrics/mAP50"])libreyolo val model=LibreYOLO9s.pt data=my-dataset.yaml# YAML COCO đi kèm chứa script tải xuống nhúng sẵn, nên cần quyền rõ ràng# trừ khi tập dữ liệu đã có cục bộ.libreyolo val model=LibreYOLO9c.pt data=coco.yaml imgsz=640 \ allow_download_scripts=TrueXuất
| Tác vụ | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Detection | Detection to ONNX: được hỗ trợ | Detection to TorchScript: được hỗ trợ | Detection to ExecuTorch: được hỗ trợ | Detection to TensorRT: được hỗ trợ | Detection to OpenVINO: được hỗ trợ | Detection to Paddle: được hỗ trợ | Detection to MNN: được hỗ trợ | Detection to RKNN: không được hỗ trợ | Detection to ncnn: được hỗ trợ | Detection to TFLite: không được hỗ trợ | Detection to CoreML: không được hỗ trợ | Detection to Core AI: được hỗ trợ |
Dấu kiểm áp dụng cho cả ba biến thể: khi chúng khác nhau, ma trận thể hiện mức hỗ trợ yếu nhất trong ba biến thể.
Artifact đã xuất được tải lại qua LibreYOLO() dựa trên hậu tố tệp, vì vậy tệp
.onnx hoặc .engine hoạt động như checkpoint và trả về cùng Results. Cũng
hỗ trợ chạy đồ thị trong runtime độc lập không cài LibreYOLO, nhưng khi đó bạn
phải tự viết bước tiền xử lý và hậu xử lý.
Với mô hình phát hiện cơ sở, nửa hậu xử lý có thể được đưa vào đồ thị. nms=True
trên bản xuất ONNX đặt bước loại bỏ bên trong mô hình, và đầu ra đầu tiên trở thành
tensor cố định (1, max_det, 6) có các hàng là x1, y1, x2, y2, score, class,
được thêm số 0 sau số lượng phát hiện. Đồ thị đó dùng batch 1 và không có trục
động. Mô hình đầu cuối và stride-4 không chấp nhận cờ này.
Mỗi định dạng cài một extra khác nhau và nhận một số đối số riêng. Cả hai đều được trình bày trên trang của định dạng đó.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.export(format="onnx", imgsz=640)libreyolo export model=LibreYOLO9s.pt format=onnx imgsz=640libreyolo export model=LibreYOLO9s.pt format=onnx nms=True \ conf=0.25 iou=0.45 max_det=300from libreyolo import LibreYOLO, SAMPLE_IMAGE # Factory định tuyến theo hậu tố tệp, nên artifact đã xuất được tải# như mọi checkpoint và trả về cùng đối tượng Results.model = LibreYOLO("LibreYOLO9s.onnx")result = model(SAMPLE_IMAGE) print(result.boxes.xyxy)TFLite INT8 dùng int8=True cùng dữ liệu hiệu chuẩn.
Đầu vào và đầu ra ONNX
LibreYOLO9
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Màu | RGB |
| Chuẩn hóa tỉ lệ | pixel / 255 |
| Chuẩn hóa | không có |
| Đổi kích thước | letterbox, bilinear, giá trị đệm 114, vị trí đệm lấy từ khóa metadata letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
Detection, xuất mặc định
| Đầu ra | Hình dạng | Ý nghĩa |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Hậu xử lý
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Detection, nms=True
| Đầu ra | Hình dạng | Ý nghĩa |
|---|---|---|
output | [1, max_det, 6] | Rows are x1, y1, x2, y2, score, class in input-canvas pixels, zero-padded past the detection count. Confidence, IoU and max_det are baked in and recorded as nms_conf, nms_iou and max_det metadata. |
raw | [1, 4 + nc, anchors] | The same tensor as the default export's output, before suppression. |
Hậu xử lý
- Drop rows whose score is 0 or below your threshold.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
LibreYOLO9E2E
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Màu | RGB |
| Chuẩn hóa tỉ lệ | pixel / 255 |
| Chuẩn hóa | không có |
| Đổi kích thước | letterbox, bilinear, giá trị đệm 114, vị trí đệm lấy từ khóa metadata letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, xuất mặc định
| Đầu ra | Hình dạng | Ý nghĩa |
|---|---|---|
output | [batch, 4 + nc, anchors] | Predictions of the one-to-one head only. Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Hậu xử lý
- Transpose to [anchors, 4 + nc].
- Flatten the [anchors, nc] scores into one list of anchors x nc (anchor, class) pairs. Pair i belongs to anchor i / nc (integer division) and class i % nc.
- Keep the 300 highest-scoring pairs (max_det), highest first. One anchor can yield several classes.
- Of those, keep the pairs whose score is above the confidence threshold (0.25 by default).
- Do not run NMS. The one-to-one head is trained to fire once per object, and LibreYOLO ignores the iou setting for this model.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
LibreYOLO9P2
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Màu | RGB |
| Chuẩn hóa tỉ lệ | pixel / 255 |
| Chuẩn hóa | không có |
| Đổi kích thước | letterbox, bilinear, giá trị đệm 114, vị trí đệm lấy từ khóa metadata letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, xuất mặc định
| Đầu ra | Hình dạng | Ý nghĩa |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 4, 8, 16 and 32, 34000 at 640 x 640. nc is 10 for LibreYOLO9P2s-visdrone. |
Hậu xử lý
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Để kiểm tra bản triển khai của bạn, hãy chạy cùng tệp đó qua LibreYOLO: LibreYOLO("model.onnx").predict("image.jpg") trả về kết quả tham chiếu. Đã kiểm chứng với LibreYOLO 1.7.0.
Checkpoint
Mọi tệp trọng số đã công bố cho họ này.
| Tệp | Đầu vào (px) | Giấy phép trọng số |
|---|---|---|
| Detection | ||
| LibreYOLO9t.pt | 640 | mit |
| LibreYOLO9s.pt | 640 | mit |
| LibreYOLO9m.pt | 640 | mit |
| LibreYOLO9c.pt | 640 | mit |
| LibreYOLO9E2Et.pt | 640 | mit |
| LibreYOLO9E2Es.pt | 640 | mit |
| LibreYOLO9E2Em.pt | 640 | mit |
| LibreYOLO9E2Ec.pt | 640 | mit |
| LibreYOLO9P2s-visdrone.pt | cc-by-nc-sa-3.0 | |
Mọi tệp ở trên hiện đều có trong tổ chức LibreYOLO và được tải xuống trong lần sử dụng đầu tiên.
Giấy phép
Hãy kiểm tra giấy phép trong repo Hugging Face của trọng số cụ thể mà bạn tải xuống. Mỗi checkpoint trong tổ chức LibreYOLO đều có giấy phép riêng và giấy phép có thể khác nhau trong cùng một họ. Repo đó là nguồn có thẩm quyền; phần tóm tắt dưới đây mô tả các điều khoản áp dụng khi trang này được kiểm chứng lần gần nhất.
Đây là phần mô tả các giấy phép liên quan, không phải tư vấn pháp lý. Nếu câu trả lời có ý nghĩa về mặt thương mại, hãy tự đọc các giấy phép và tham khảo cố vấn của riêng bạn.
- Công trình gốc
- YOLOv9, MultimediaTechLab
- Giấy phép thượng nguồn
- MIT
- Nguồn thượng nguồn
- github.com/MultimediaTechLab/YOLO
- Mã nguồn LibreYOLO
- MIT
- Trọng số
- MIT, được phát hành lại tại huggingface.co/LibreYOLO
- Diễn giải
- MIT is a permissive license, so these weights can be used in commercial and closed-source products. The one standing obligation is to keep the license text and the copyright notice, Kin-Yiu Wong and Hao-Tang Tsui, with any copy you redistribute. It places no condition on your own application code, and a model you train yourself on your own data is yours. Two things are worth knowing beyond that. The code is ported from the authors' MIT re-release of YOLOv9, MultimediaTechLab/YOLO at commit c4cb5f6f, not the GPL-3.0 repository that carries the same model, so the permissive terms come from the source LibreYOLO actually derives from. And one checkpoint in this family is not MIT: the weight repository of the stride-4 VisDrone model, LibreYOLO9P2s-visdrone.pt, declares CC BY-NC-SA 3.0, which rules out commercial use and requires share-alike on derivatives.
Mã của cả ba biến thể được chuyển từ
MultimediaTechLab/YOLO ở commit
c4cb5f6f (MIT). Bộ dự đoán một-đối-một của mô hình đầu cuối theo thiết kế của
DATE của Yiqun Chen (Apache-2.0), được
triển khai cho LibreYOLO mà không sao chép mã DATE. Cấp stride-4 là mã của
LibreYOLO.
Checkpoint ảnh trên không có stride 4 dự đoán các lớp đối tượng VisDrone. Dùng giấy phép do nhà phát hành công bố và ghi trong repo trọng số.
Trích dẫn
@inproceedings{wang2024yolov9,
      title={{YOLOv9}: Learning What You Want to Learn Using Programmable Gradient Information},
      author={Wang, Chien-Yao and Yeh, I-Hau and Liao, Hong-Yuan Mark},
      year={2024},
      booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
}
Được sao chép từ khối trích dẫn của tác giả tại github.com/MultimediaTechLab/YOLO#citations.