ConvNeXt
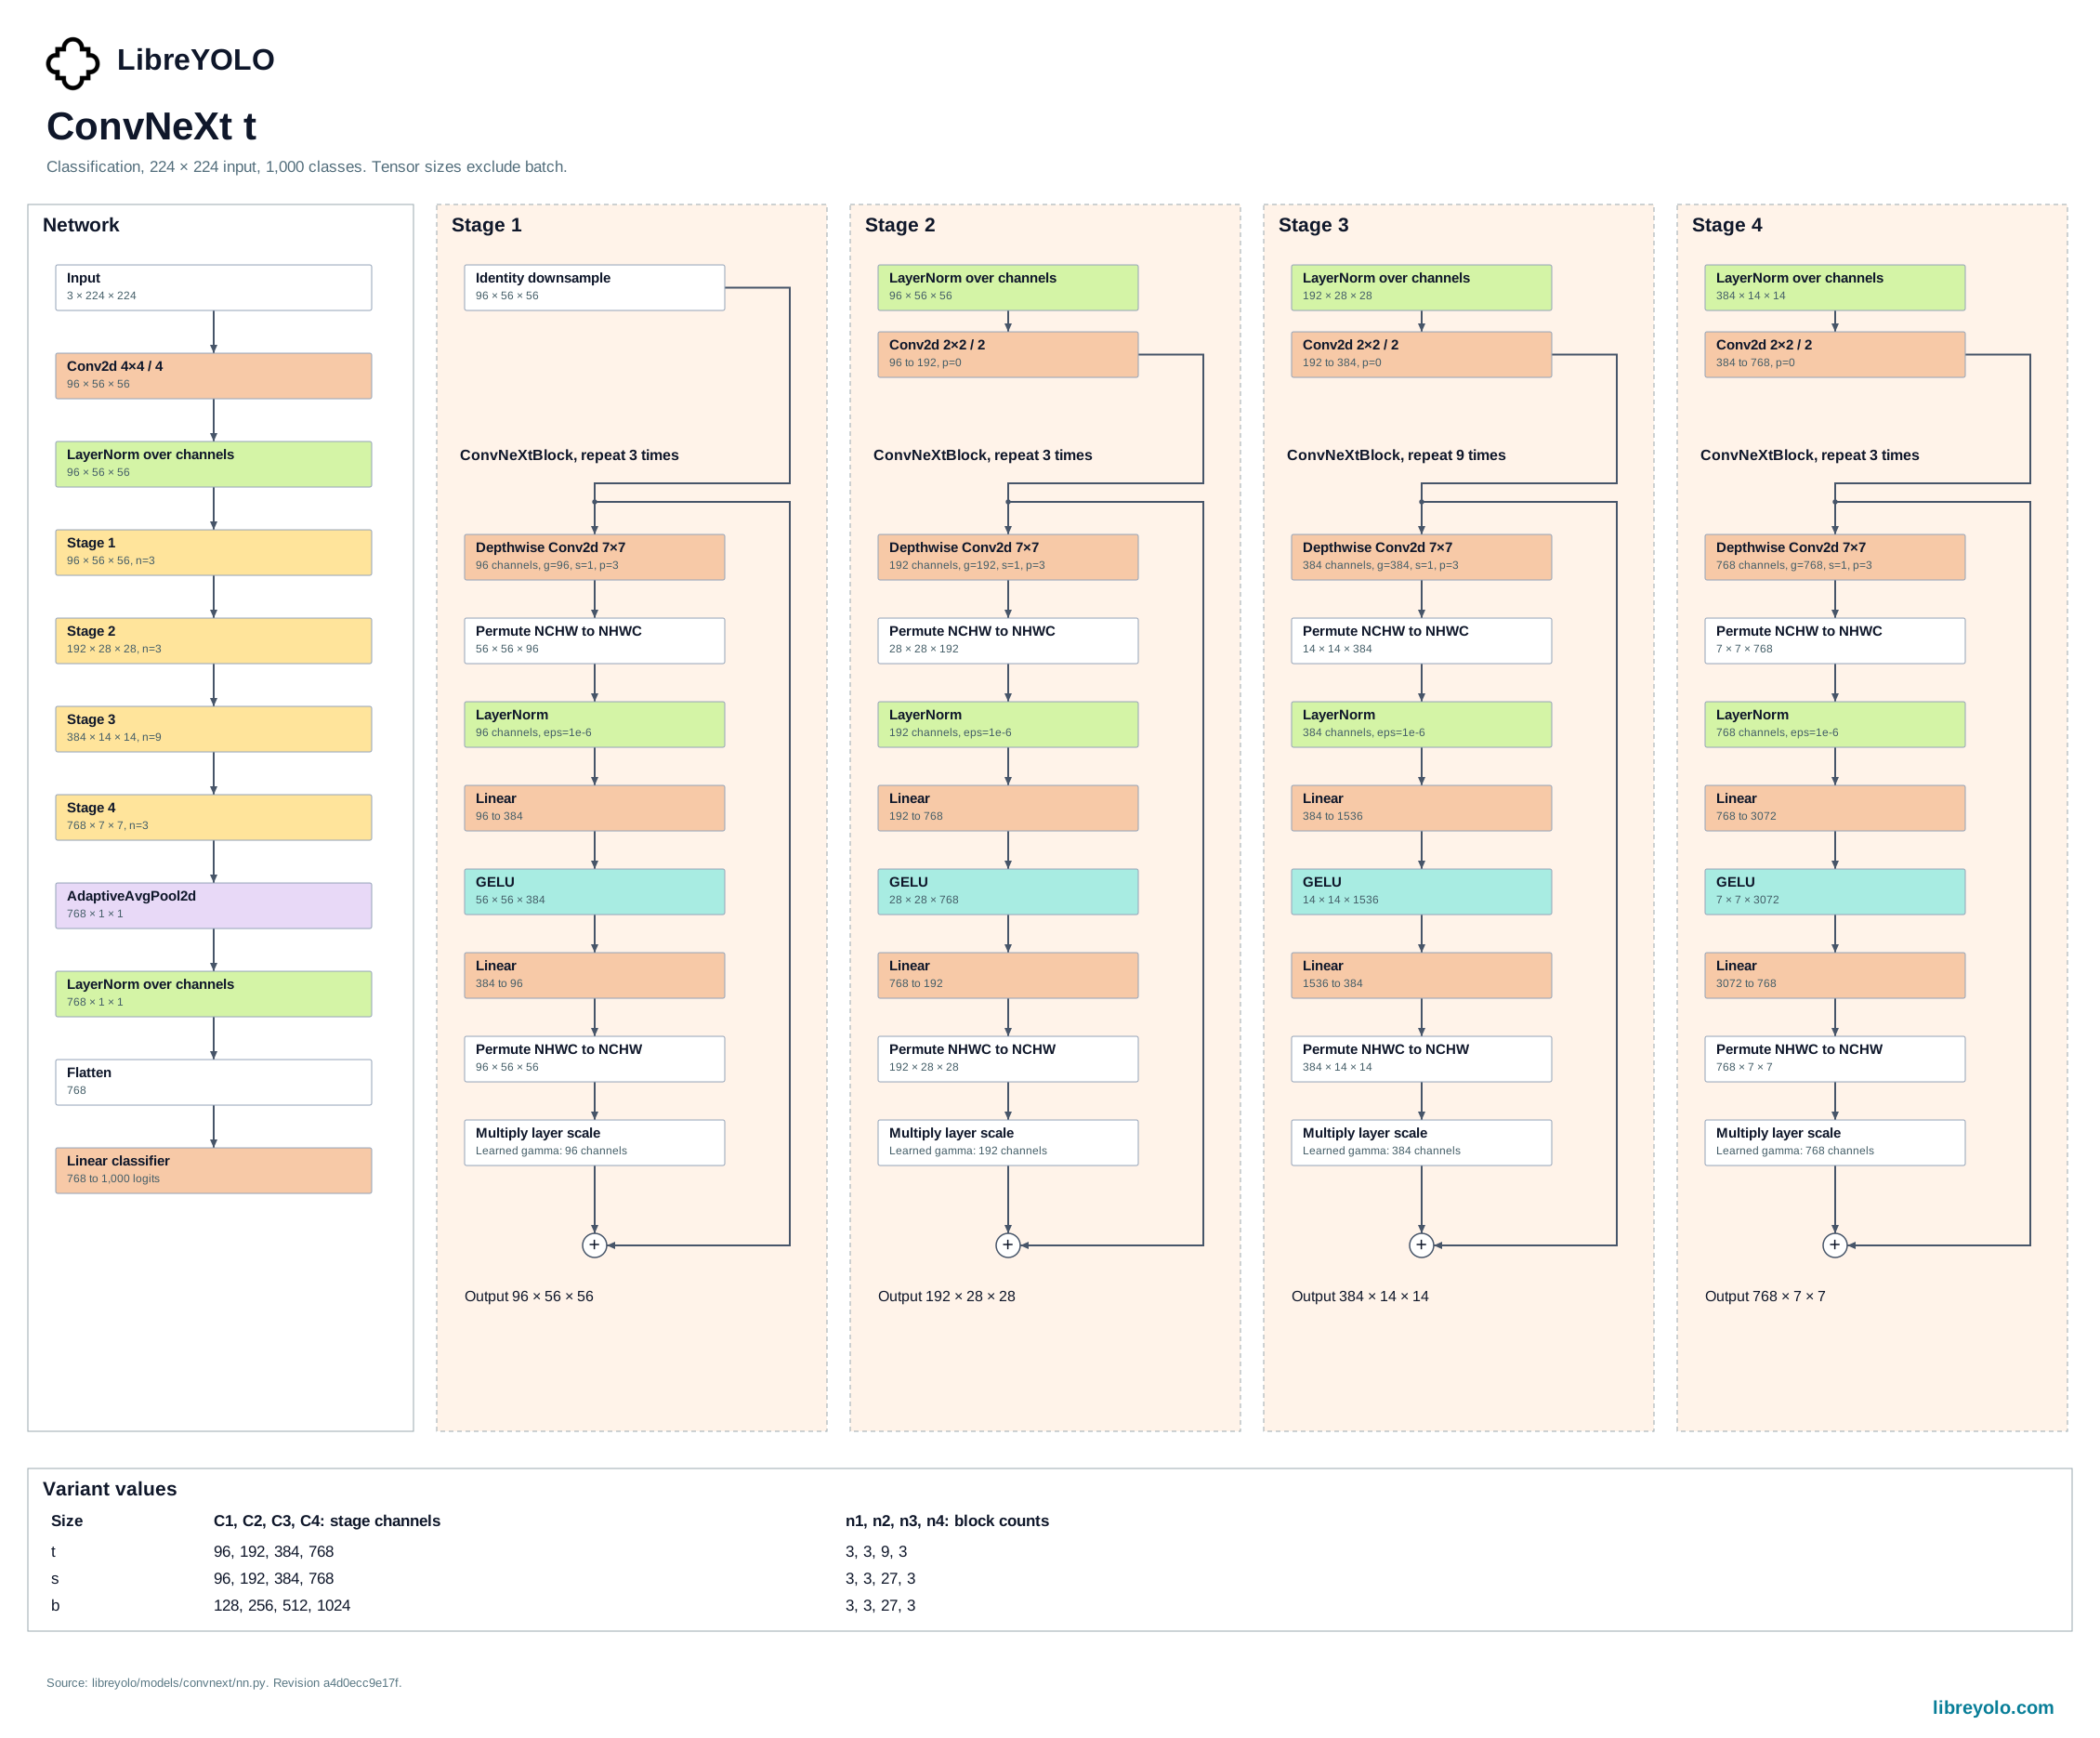
ConvNeXt ist ein Bildklassifikator, der vollständig aus gewöhnlichen Faltungen aufgebaut ist, Block für Block von einem ResNet in Richtung der Designentscheidungen eines Vision Transformers modernisiert. LibreYOLO unterstützt ihn für eine Aufgabe: die Klassifikation.
- Aufgaben
- classification
- Größen
- t, s, b at 224 px
- Installation
pip install libreyolo- Supportstufe
- Unterstützt, seit v1.3.0. Ergänzende trainierbare Modelle: Die CI bleibt grün, Funktionen kommen bei Gelegenheit hinzu.
- Upstream
- ConvNeXt von Meta AI (FAIR), Apache-2.0. Publikation, Quelle
- Lizenzen
- Code MIT, Gewichte Apache-2.0. Kommerzielle Nutzung
Installation
ConvNeXt braucht kein optionales Extra. Alles, was es importiert, steckt in der Basisinstallation.
pip install libreyoloFine-Tuning mit Adaptern über lora=True ist die Ausnahme und braucht das
Extra lora.
pip install "libreyolo[lora]"Vorhersage
Die Gewichte werden beim ersten Aufruf von Hugging Face geladen und lokal zwischengespeichert.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreConvNeXtt-cls.pt")result = model(SAMPLE_IMAGE, save=True) print(result.probs.top1, result.probs.top1conf)print(result.probs.top5)libreyolo predict model=LibreConvNeXtt-cls.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=TrueDas zurückgegebene Results-Objekt ist dasselbe, das jede Familie liefert,
ein anderes Modell einzusetzen ist also eine Änderung von einer Zeile. Ein
Klassifikator führt keine Boxen und keine Masken mit: result.probs enthält
die Vorhersage für das ganze Bild, mit top1, top5, top1conf und
top5conf. conf, iou und max_det werden aus Gründen der API-Parität
akzeptiert, haben aber keine Wirkung, denn bei einem einzelnen
Wahrscheinlichkeitsvektor gibt es nichts, worauf ein Schwellenwert oder eine
Unterdrückung wirken könnte. Siehe Vorhersage für Quellen,
Streaming und den Umgang mit Ergebnissen.
Varianten
Drei Größen, tiny/small/base, alle gleich trainiert und gleich ausgewertet,
die Wahl ist also ein direkter Tausch von Parameterzahl gegen Accuracy. Die
Aufgabe liegt fest: jede Größe deckt nur die Klassifikation ab. Der Name der
Gewichtsdatei endet bei jeder Größe auf -cls.pt, und genau dieses Suffix
liest die Factory, um an diese Familie zu routen; ein task=-Argument ist
nicht nötig.
Training
Das Fine-Tuning startet vom veröffentlichten ImageNet-Backbone und baut die letzte Klassifikatorschicht automatisch auf die Klassenzahl des Zieldatensatzes um.
from libreyolo import LibreYOLO model = LibreYOLO("LibreConvNeXtt-cls.pt")model.train(data="imagenette160", epochs=5)libreyolo train model=LibreConvNeXtt-cls.pt data=imagenette160 epochs=5from libreyolo import LibreYOLO model = LibreYOLO("LibreConvNeXtt-cls.pt")model.train(data="imagenette160", epochs=5, lora=True)libreyolo train model=LibreConvNeXtt-cls.pt data=imagenette160 \ epochs=50 device=0,1 batch=-1Ohne weitere Angaben läuft das Training 100 Epochen mit lr0=1e-3, AdamW,
einem Batch von 64 und Early Stopping nach 50 Epochen ohne Verbesserung.
data akzeptiert ein Datensatzverzeichnis (train/ und val/, ein Ordner
pro Klasse), einen bekannten Kurznamen wie imagenette160 oder eine
.zip-URL. Die Blöcke von ConvNeXt enthalten die nn.Linear-MLPs, die LoRA
braucht, deshalb wird lora=True hier unterstützt und schleust Adapter in die
Block-MLPs ein, statt das ganze Backbone nachzutrainieren.
Siehe Training für Datensätze, Augmentierung, Multi-GPU und Logger.
cls_pw=0 deaktiviert die Loss-Gewichtung; Werte bis 1 verwenden inverse Häufigkeitsgewichte, die auf den Mittelwert 1 normiert sind. class_weights=True verwendet stattdessen anhand der Stichproben normierte inverse Häufigkeiten und lässt sich nicht mit cls_pw>0 kombinieren. Diese Einstellungen müssen beim Fortsetzen übereinstimmen. Siehe Klassifikation.
Validierung
val() gibt ein Dictionary mit metrics/-Schlüsseln zurück. Bei der
Klassifikation sind das die Top-1- und die Top-5-Accuracy über dem
Validierungs-Split.
from libreyolo import LibreYOLO model = LibreYOLO("LibreConvNeXtt-cls.pt")metrics = model.val(data="imagenette160") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])libreyolo val model=LibreConvNeXtt-cls.pt data=imagenette160Validierung und INT8-Kalibrierung verwenden die Auswertungstransformation der Familie. Die Exportmetadaten speichern norm_mean, norm_std und resize_mode; ältere Artefakte greifen auf die Familienwerte zurück. Kalibrierungsvorverarbeiter geben das erforderliche CHW-Array und das Verhältnis zurück.
Export
| Aufgabe | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Classification | Classification to ONNX: unterstützt | Classification to TorchScript: unterstützt | Classification to ExecuTorch: unterstützt | Classification to TensorRT: unterstützt | Classification to OpenVINO: unterstützt | Classification to Paddle: nicht unterstützt | Classification to MNN: nicht unterstützt | Classification to RKNN: nicht unterstützt | Classification to ncnn: unterstützt | Classification to TFLite: unterstützt | Classification to CoreML: nicht unterstützt | Classification to Core AI: unterstützt |
Ein exportiertes Artefakt lädt über sein Dateisuffix wieder durch
LibreYOLO(), eine .onnx- oder .engine-Datei verhält sich also wie ein
Checkpoint und liefert dasselbe Results. Export listet die
Argumente auf, die jedes Format akzeptiert, und die zusätzlichen, die einige
davon mitbringen.
from libreyolo import LibreYOLO model = LibreYOLO("LibreConvNeXtt-cls.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreConvNeXtt-cls.pt format=onnxlibreyolo export model=LibreConvNeXtt-cls.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Die Factory routet über das Dateisuffix: ein exportiertes Artefakt# lädt wie ein Checkpoint und liefert dasselbe Results-Objekt.model = LibreYOLO("LibreConvNeXtt-cls.onnx")result = model(SAMPLE_IMAGE) print(result.probs.top1)Checkpoints
Jede veröffentlichte Gewichtsdatei dieser Familie.
| Datei | Eingabe (px) | Lizenz der Gewichte |
|---|---|---|
| Classification | ||
| LibreConvNeXtt-cls.pt | 224 | apache-2.0 |
| LibreConvNeXts-cls.pt | 224 | apache-2.0 |
| LibreConvNeXtb-cls.pt | 224 | apache-2.0 |
Jede oben aufgeführte Datei ist heute in der LibreYOLO-Organisation verfügbar und wird bei der ersten Verwendung heruntergeladen.
Lizenzierung
Prüfe die Lizenz im Hugging-Face-Repository der konkreten Gewichte, die du herunterlädst. Jeder Checkpoint in der LibreYOLO-Organisation hat eine Lizenz, und sie ist innerhalb einer Familie nicht immer gleich. Dieses Repository ist die maßgebliche Quelle. Die Zusammenfassung unten beschreibt den Stand bei der letzten Verifizierung dieser Seite.
Dies ist eine Beschreibung der beteiligten Lizenzen und keine Rechtsberatung. Wenn die Antwort kommerziell relevant ist, lies die Lizenzen selbst und hole eigenen Rechtsrat ein.
- Originalarbeit
- ConvNeXt, Meta AI (FAIR)
- Upstream-Lizenz
- Apache-2.0
- Upstream-Quelle
- github.com/huggingface/pytorch-image-models
- LibreYOLO-Code
- MIT
- Gewichte
- Apache-2.0, erneut unter huggingface.co/LibreYOLO veröffentlicht
- Einordnung
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. It places no obligation on your own application code, and weights you train yourself on your own data are yours. The architecture is Meta AI's original design, released under MIT at facebookresearch/ConvNeXt; the block definitions, layer-scale parameter and module naming that LibreYOLO's implementation follows come from timm, whose convnext_{tiny,small,base}.fb_in1k ImageNet-1k weights are licensed Apache-2.0 and are what LibreYOLO ships.
Diese Seite behandelt ConvNeXt V1. ConvNeXt V2 ist eine eigene Familie; ihre offiziellen vortrainierten Gewichte behalten CC-BY-NC-4.0.
Zitieren
@Article{liu2022convnet,
  author  = {Zhuang Liu and Hanzi Mao and Chao-Yuan Wu and Christoph Feichtenhofer and Trevor Darrell and Saining Xie},
  title   = {A ConvNet for the 2020s},
  journal = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)},
  year    = {2022},
}
Aus dem Zitierblock der Autoren unter github.com/facebookresearch/ConvNeXt#citation kopiert.