DINOv2
DINOv2 ist ein selbstüberwachter Vision Transformer, den Meta AI ohne Labels für universell einsetzbare Bild-Features trainiert hat. LibreYOLO bindet sein DINOv2-with-Registers-Backbone für drei Aufgaben ein: semantische Segmentierung, Klassifizierung und Ganzbild-Embedding.
- Aufgaben
- semantic segmentation, classification, embeddings
- Größen
- n, s, m, l at 518 px
- Installation
pip install "libreyolo[rfdetr]"- Supportstufe
- Unterstützt, seit v1.3.0. Ergänzende trainierbare Modelle: Die CI bleibt grün, Funktionen kommen bei Gelegenheit hinzu.
- Upstream
- DINOv2 von Meta AI (FAIR), Apache-2.0. Publikation, Quelle
- Lizenzen
- Code MIT, Gewichte Apache-2.0. Kommerzielle Nutzung
Installation
LibreDINOv2 wird nur registriert, wenn transformers installiert ist. Das ist
dieselbe optionale Abhängigkeit, die RF-DETR für sein DINOv2-Backbone benötigt.
Daher ist dasselbe Zusatzpaket erforderlich.
pip install "libreyolo[rfdetr]"Vorhersage
LibreYOLO veröffentlicht keinen LibreDINOv2-Checkpoint. Erzeuge den Wrapper
direkt, statt eine Datei zu laden: model_path=None (der Standardwert) lädt
bei der ersten Verwendung Metas Apache-2.0-Backbone
facebook/dinov2-with-registers-small von Hugging Face herunter. task= wählt
aus, was darauf ausgeführt wird.
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Für diese Familie gibt es keinen von LibreYOLO gehosteten Checkpoint:# Dies lädt das DINOv2-with-Registers-Small-Backbone unter Apache-2.0# von Metas Hugging-Face-Organisation. Der dichte Head ist zufällig# initialisiert, bis du ihn trainierst (siehe Training unten).model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= ist die Klassenanzahl deines Datensatzes. Der lineare Head# ist zufällig initialisiert, bis du ihn trainierst.model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Umgeht alle Aufgaben-Heads. Das Backbone allein reicht aus,# daher ist kein Fine-Tuning nötig.model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D), L2-normalisiertfrom libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # Komfortfunktion: Führt predict() aus und stapelt alle Zeilen zu einem# Tensor der Form (N, D).features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" und task="classify" fügen dem Backbone einen dichten
beziehungsweise linearen Head hinzu. Dieser Head wird zufällig initialisiert
und ist erst nach dem Training nützlich (siehe Training).
task="embed" überspringt alle Heads und gibt das letzte normalisierte
CLS-Token des Backbones als eine Ganzbildzeile in result.embeddings zurück.
Dafür ist überhaupt kein Training erforderlich. result.boxes ist immer
None, weil keine der drei Aufgaben instanzbezogene Erkennungen erzeugt.
Unter Vorhersage findest du Quellen, Streaming und die
Verarbeitung von Ergebnissen.
Varianten
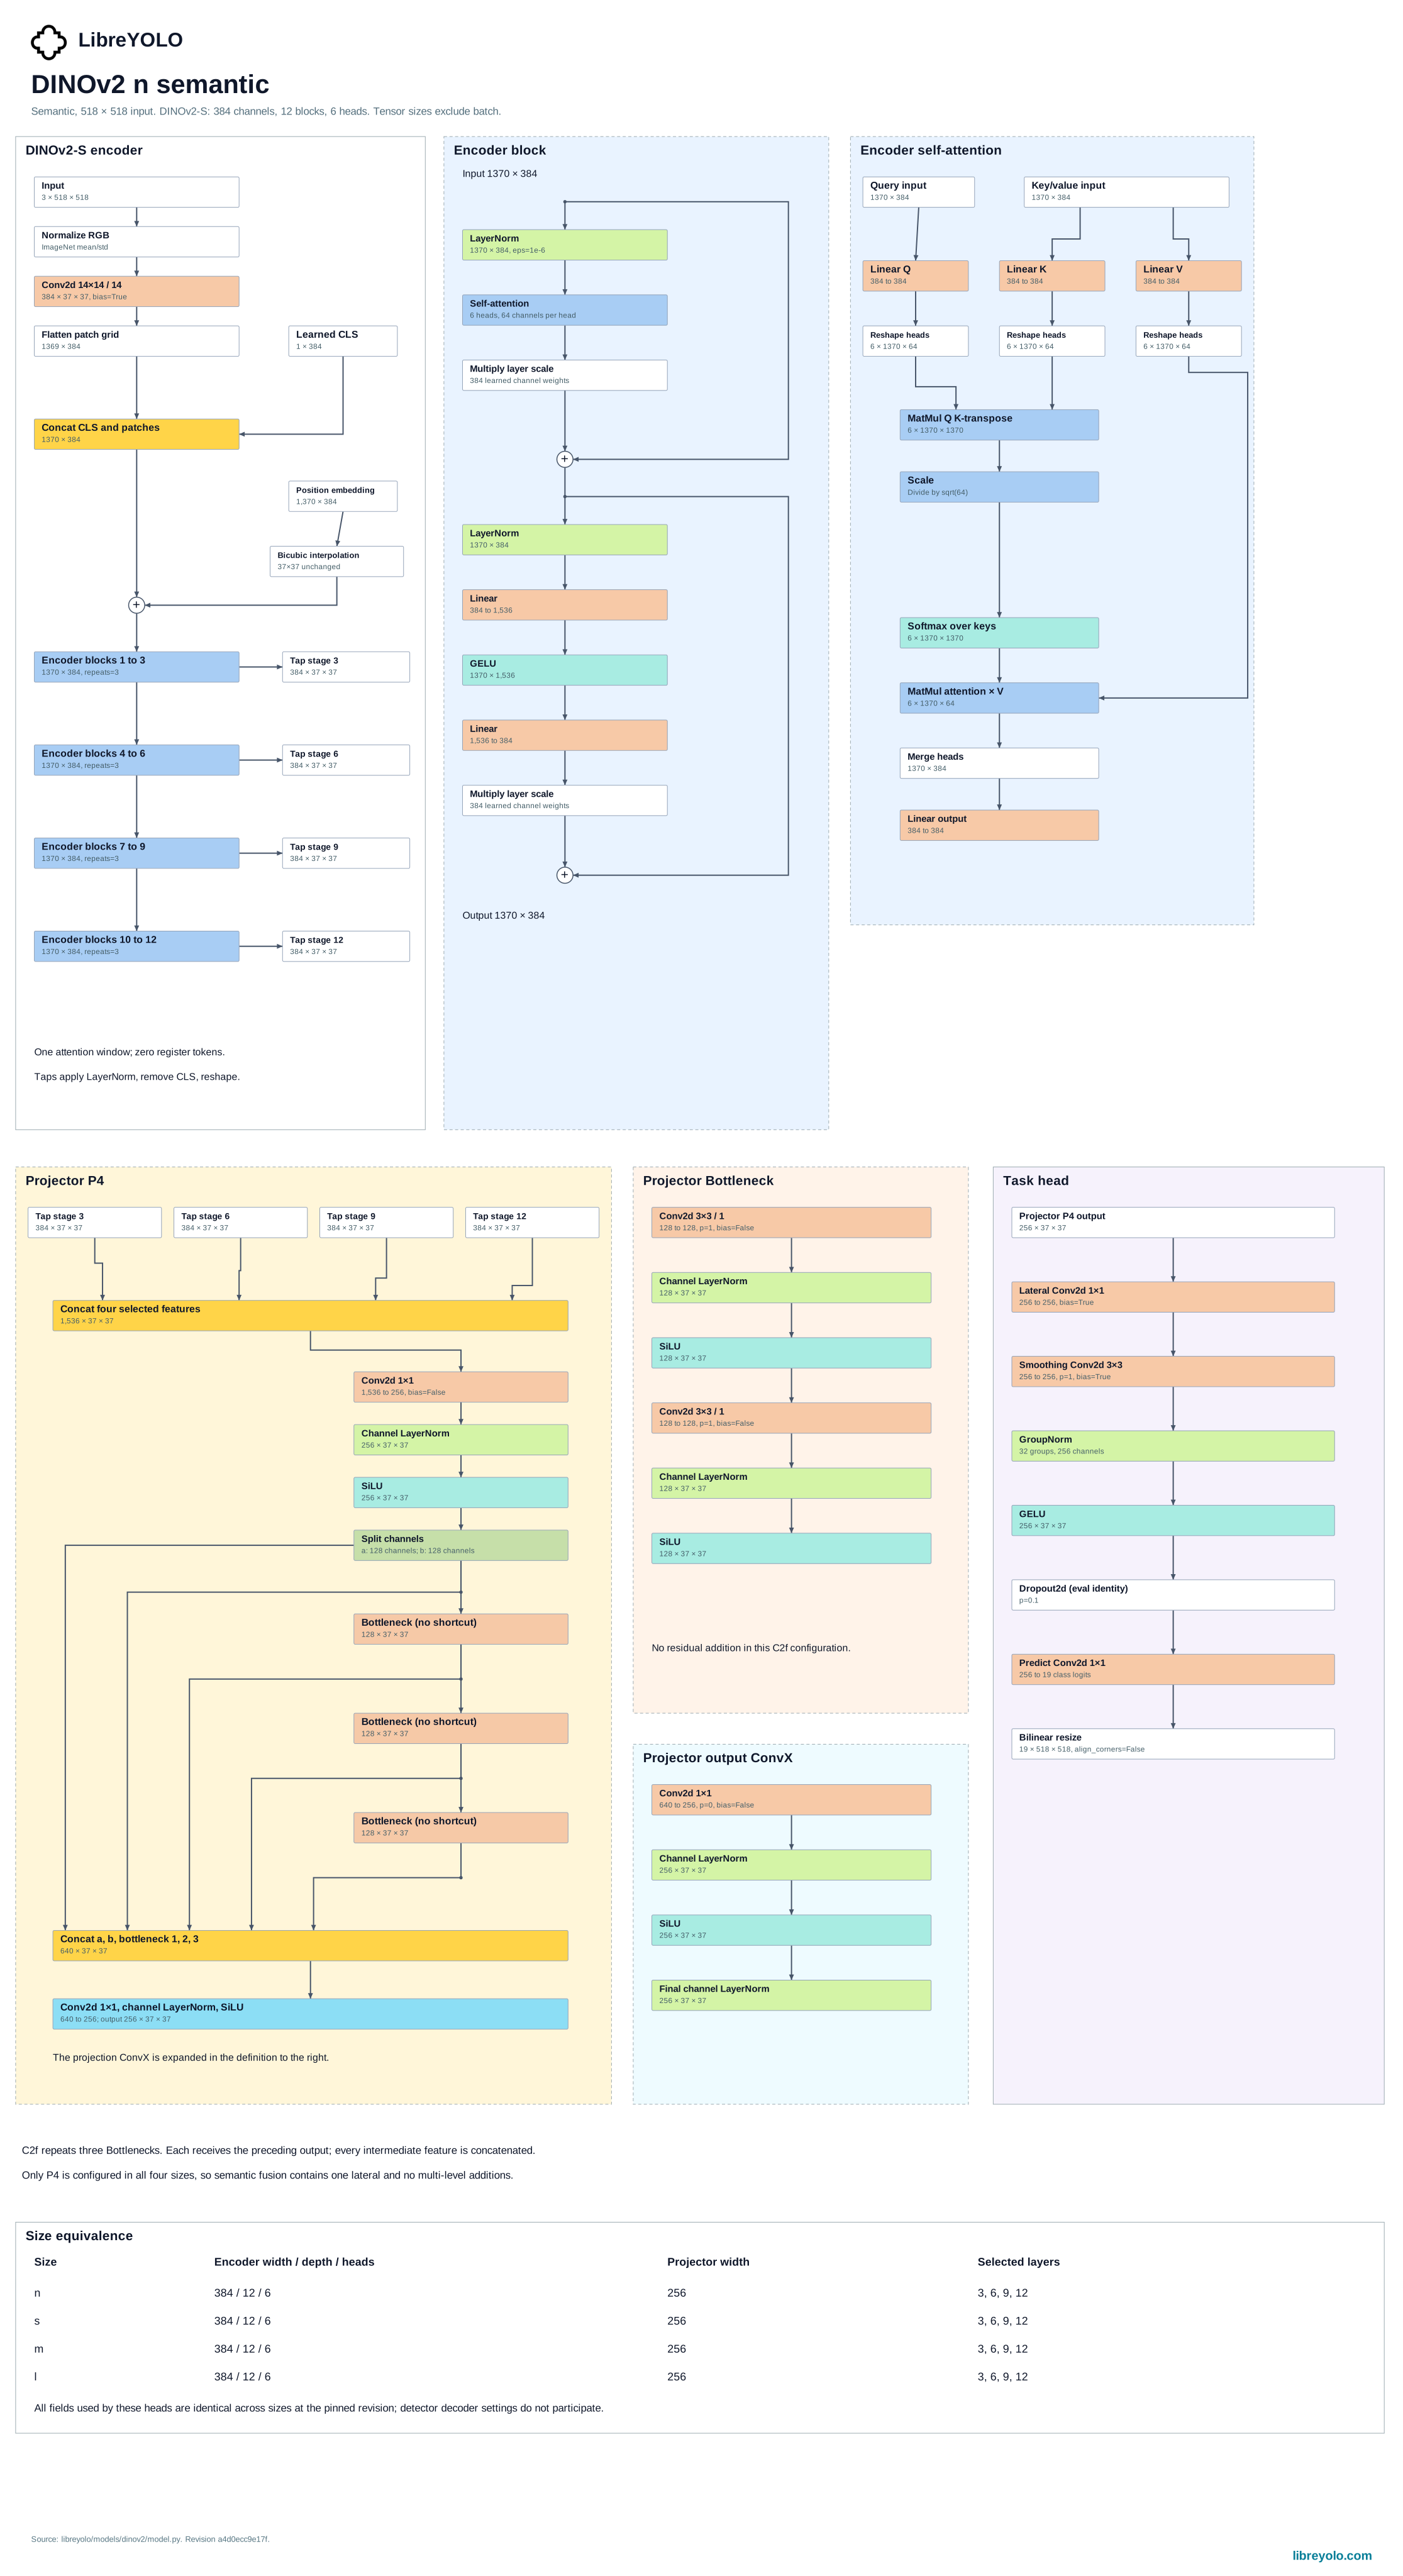
size wählt die Breite des RF-DETR-artigen Projektors auf dem Backbone und
nicht das Backbone selbst. Alle Größen verwenden denselben DINOv2-S-Encoder
(Small). Die semantische Segmentierung läuft auf dem nativen quadratischen
Patch-Raster von DINOv2. Klassifizierung und Embedding nutzen die kleinere
Klassifizierungsauflösung, mit der die lineare Probe trainiert wurde.
Training
task="semantic" und task="classify" können beide trainiert werden.
task="embed" besitzt keinen klassenabhängigen Head, der angepasst werden
könnte, und löst bei einem Aufruf von train() den Fehler NotImplementedError
aus.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)Die primären Schlüsselwortargumente sind hier batch_size und lr, nicht batch und lr0 wie bei den meisten anderen Familien. batch und lr0 werden weiterhin akzeptiert und zugeordnet, aber die Übergabe beider Formen führt zu einem Konfliktfehler. output_dir= (Standard None) ersetzt project=/name= als primären Weg zur Ablage eines Laufs; die direkte Übergabe von project=/name= funktioniert weiterhin. Siehe Training für Datensätze, Augmentierung, Multi-GPU und Logger.
Neue Läufe verwenden ein hochgezähltes runs/train/dinov2_exp mit exist_ok=False. resume=True stellt den Trainer-Zustand wieder her und behält das ausgewählte Laufverzeichnis bei. Die Klassifikation unterstützt cls_pw und class_weights wie unter Hyperparameter beschrieben.
Validierung
val() gibt ein Dictionary mit metrics/-Schlüsseln zurück: mIoU und
Pixel-Accuracy für task="semantic", Top-1- und Top-5-Accuracy für
task="classify". task="embed" besitzt keine Ground Truth für eine
Bewertung und löst beim Aufruf von val() den Fehler NotImplementedError
aus.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])Die Kalibrierung für Klassifikation und Embeddings verwendet die Klassifikationspipeline des Modells. Die Auswertung verwendet die Transformation der Familie.
Export
| Aufgabe | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX: unterstützt | Semantic segmentation to TorchScript: unterstützt | Semantic segmentation to ExecuTorch: unterstützt | Semantic segmentation to TensorRT: unterstützt | Semantic segmentation to OpenVINO: unterstützt | Semantic segmentation to Paddle: nicht unterstützt | Semantic segmentation to MNN: nicht unterstützt | Semantic segmentation to RKNN: nicht unterstützt | Semantic segmentation to ncnn: nicht unterstützt | Semantic segmentation to TFLite: nicht unterstützt | Semantic segmentation to CoreML: nicht unterstützt | Semantic segmentation to Core AI: nicht unterstützt |
| Classification | Classification to ONNX: unterstützt | Classification to TorchScript: unterstützt | Classification to ExecuTorch: unterstützt | Classification to TensorRT: unterstützt | Classification to OpenVINO: unterstützt | Classification to Paddle: nicht unterstützt | Classification to MNN: nicht unterstützt | Classification to RKNN: nicht unterstützt | Classification to ncnn: nicht unterstützt | Classification to TFLite: nicht unterstützt | Classification to CoreML: nicht unterstützt | Classification to Core AI: unterstützt |
| Embeddings | Embeddings to ONNX: unterstützt | Embeddings to TorchScript: unterstützt | Embeddings to ExecuTorch: unterstützt | Embeddings to TensorRT: unterstützt | Embeddings to OpenVINO: unterstützt | Embeddings to Paddle: nicht unterstützt | Embeddings to MNN: nicht unterstützt | Embeddings to RKNN: nicht unterstützt | Embeddings to ncnn: nicht unterstützt | Embeddings to TFLite: unterstützt | Embeddings to CoreML: nicht unterstützt | Embeddings to Core AI: nicht unterstützt |
Jede Aufgabe unterstützt eine andere, oben dargestellte Teilmenge der Formate.
Ein exportiertes Artefakt wird anhand seiner Dateiendung wieder über LibreYOLO()
geladen. Eine .onnx- oder .engine-Datei verhält sich daher wie ein Checkpoint
und gibt dasselbe Results-Objekt zurück. Export führt die
Argumente auf, die von den einzelnen Formaten akzeptiert werden.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # Die Factory entscheidet anhand der Dateiendung, daher wird ein Exportartefakt# wie jeder Checkpoint geladen und gibt dasselbe Results-Objekt zurück. Export# benennt die Datei nach der Aufgabe, hier LibreDINOv2s-sem.onnx.model = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)Lizenzierung
Prüfe die Lizenz im Hugging-Face-Repository der konkreten Gewichte, die du herunterlädst. Jeder Checkpoint in der LibreYOLO-Organisation hat eine Lizenz, und sie ist innerhalb einer Familie nicht immer gleich. Dieses Repository ist die maßgebliche Quelle. Die Zusammenfassung unten beschreibt den Stand bei der letzten Verifizierung dieser Seite.
Dies ist eine Beschreibung der beteiligten Lizenzen und keine Rechtsberatung. Wenn die Antwort kommerziell relevant ist, lies die Lizenzen selbst und hole eigenen Rechtsrat ein.
- Originalarbeit
- DINOv2, Meta AI (FAIR)
- Upstream-Lizenz
- Apache-2.0
- Upstream-Quelle
- github.com/facebookresearch/dinov2
- LibreYOLO-Code
- MIT
- Gewichte
- Apache-2.0, von den Autoren verbreitet. LibreYOLO hostet oder spiegelt sie nicht.
- Einordnung
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
Die Zeile „Gewichte“ oben nennt die gültige Lizenz Apache-2.0. Für diese Familie
wird jedoch nichts unter der LibreYOLO-Organisation auf Hugging Face erneut
veröffentlicht: LibreYOLO hostet keinen eigenen LibreDINOv2-Checkpoint.
LibreDINOv2(model_path=None) lädt unverändert Metas eigenes Repository
facebook/dinov2-with-registers-small herunter.
Zitieren
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
Aus dem Zitierblock der Autoren unter github.com/facebookresearch/dinov2#citing-dinov2 kopiert.