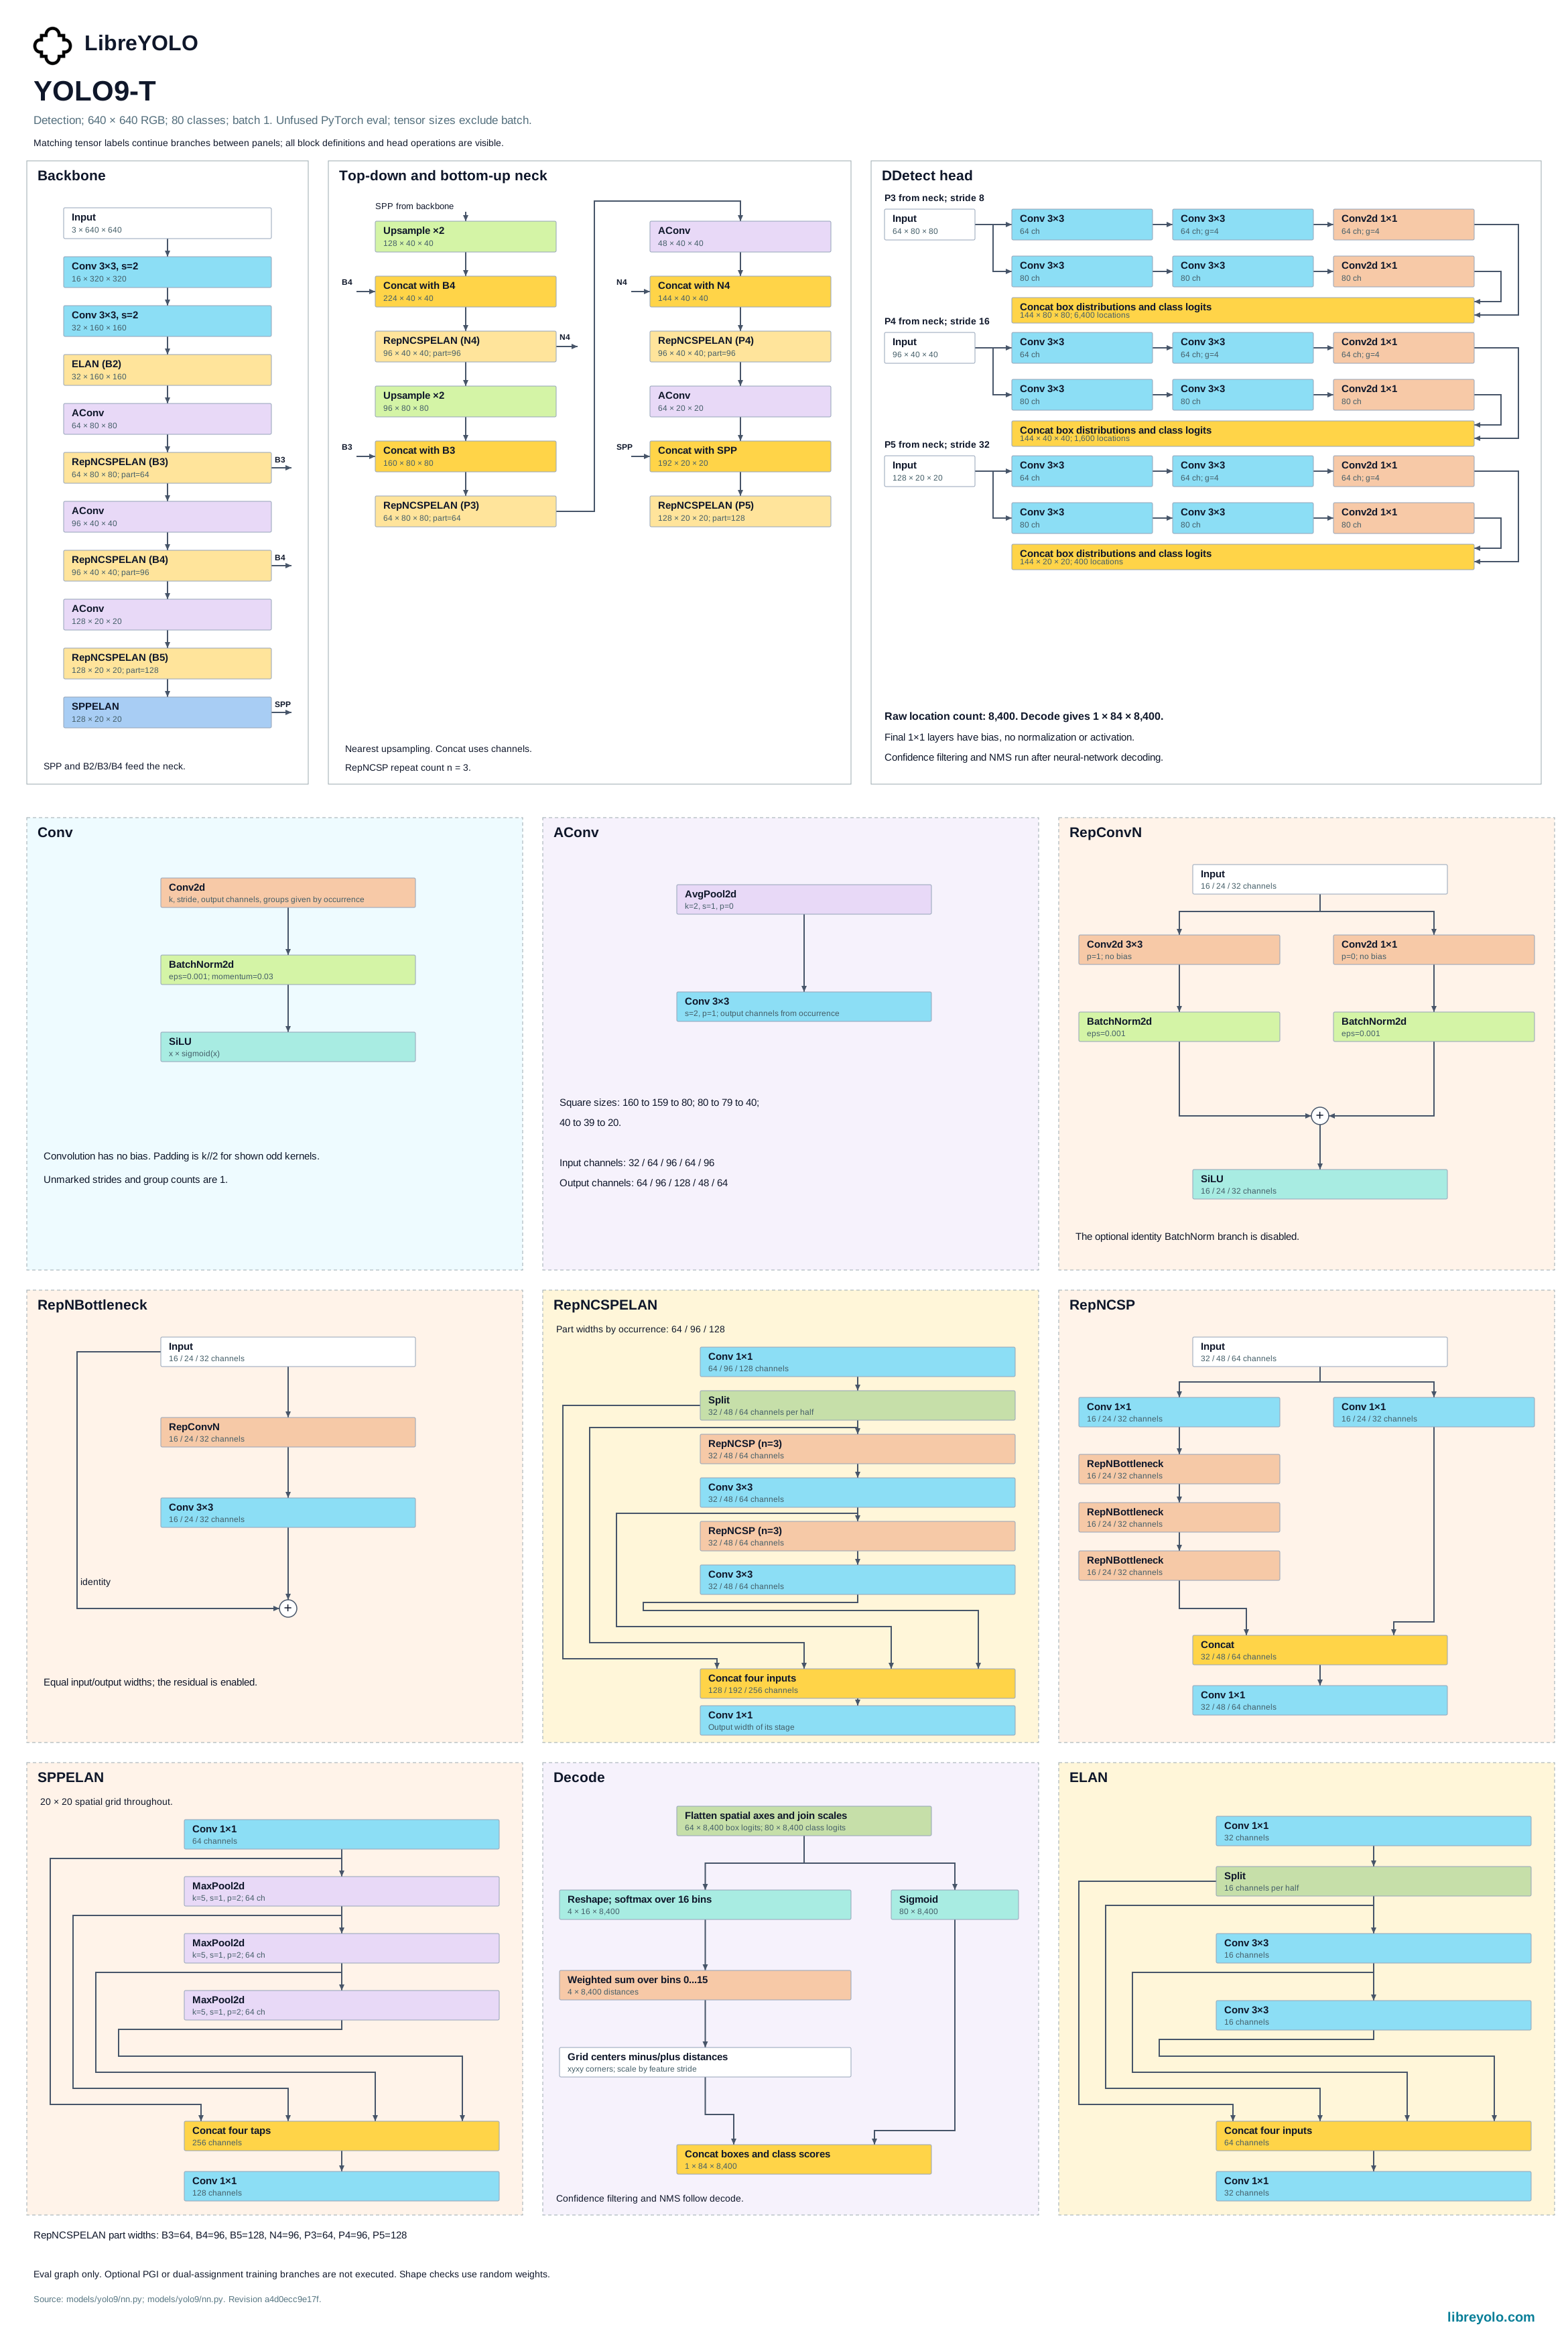
YOLOv9
Ein konvolutionaler Single-Stage-Detektor: Ein Durchlauf bewertet ein dichtes Raster von Boxen und NMS entfernt Duplikate. LibreYOLO bietet drei Varianten, von denen eine ohne NMS-Schritt auskommt.
- Aufgaben
- detection
- Größen
- yolo9: t, s, m, c at 640 px; yolo9_p2: t, s at 640 px
- Installation
pip install libreyolo- Supportstufe
- Flaggschiff, seit v1.0.0. Funktionen werden zuerst hier entwickelt und vollständig auf GPUs validiert.
- Upstream
- YOLOv9 von MultimediaTechLab, MIT. Publikation, Quelle
- Lizenzen
- Code MIT, Gewichte MIT. Kommerzielle Nutzung
Installation
YOLOv9 benötigt neben dem Basispaket kein zusätzliches Extra.
pip install libreyoloVorhersage
Die Gewichte werden bei der ersten Verwendung von Hugging Face heruntergeladen und lokal zwischengespeichert.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreYOLO9s.pt")result = model(SAMPLE_IMAGE, save=True) for box in result.boxes: print(box.cls, box.conf, box.xyxy)libreyolo predict model=LibreYOLO9s.pt save=True \ source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpgfrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Derselbe Aufruf mit einem anderen Checkpoint. Der End-to-End-Kopf liefert# seine am höchsten bewerteten Vorhersagen selbst, daher wird kein NMS ausgeführt und iou ignoriert.model = LibreYOLO("LibreYOLO9E2Es.pt")result = model(SAMPLE_IMAGE, conf=0.25, max_det=300) print(len(result.boxes))Das zurückgegebene Results-Objekt entspricht dem jeder anderen Familie, sodass der Wechsel zu einem anderen Detektor nur eine einzige Codezeile erfordert. Bei den Basismodellen und den Stride-4-Modellen legt conf den Konfidenzschwellenwert und iou den NMS-Schwellenwert fest. Das End-to-End-Modell führt kein NMS aus und ignoriert iou, daher bestimmen conf und max_det seine Ausgabe. Unter Vorhersage findest du Informationen zu Quellen, Streaming und Ergebnisverarbeitung.
Varianten
Drei Varianten verwenden denselben Backbone. Alle drei sind ausschließlich für die Objekterkennung vorgesehen und akzeptieren dieselben Argumente.
Das Basismodell sagt auf drei Merkmalsskalen vorher und entfernt doppelte Boxen mit NMS.
Das End-to-End-Modell behält diesen Kopf bei und ergänzt daneben einen Zweig mit One-to-One-Zuordnung. Die Inferenz liest ausschließlich diesen Zweig und übernimmt dessen am höchsten bewertete Vorhersagen, weshalb kein NMS ausgeführt wird. Wähle diese Variante, wenn deine Ziellaufzeitumgebung keinen NMS-Operator besitzt.
Das Stride-4-Modell greift eine Ebene weiter oben im Backbone ab, erweitert den Neck bis zu dieser Ebene und sagt auf vier statt drei Skalen vorher. Die zusätzliche Skala ist für Objekte gedacht, die nur wenige Pixel belegen. Der einzige dafür veröffentlichte Checkpoint wurde auf Luftbildern trainiert. Basischeckpoints zur Objekterkennung lassen sich darauf übertragen. Backbone und Neck werden unverändert geladen, die drei vortrainierten Kopftürme rücken um einen Platz nach oben und der Stride-4-Turm wird zufällig initialisiert.
| Checkpoint | Eingabe (px) | mAP 50-95 | Parameter (M) |
|---|---|---|---|
| LibreYOLO9c | 640 | 56.4 | 25.5 |
| LibreYOLO9m | 640 | 55.3 | 20.12 |
| LibreYOLO9s | 640 | 55.9 | 7.2 |
| LibreYOLO9t | 640 | 41.8 | 2.04 |
COCO val2017, 500 images. Gemessen mit dem LibreYOLO-Benchmarksystem und auf Vision Analysis veröffentlicht. Dort werden Latenzen verschiedener Hardware und Runtimes verglichen und die vollständigen Laufprotokolle bereitgestellt.
Training
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.train(data="my-dataset.yaml", epochs=100, imgsz=640, batch=16)libreyolo train model=LibreYOLO9s.pt data=my-dataset.yaml \ epochs=100 imgsz=640 batch=16from libreyolo import LibreYOLO9P2 # Die Stride-4-Variante besitzt keinen eigenen COCO-Checkpoint. Gib daher einen# Basischeckpoint zur Objekterkennung an: Backbone und Neck werden unverändert geladen,# während der Stride-4-Kopfturm zufällig initialisiert wird.model = LibreYOLO9P2(None, size="s")model.train(data="my-dataset.yaml", epochs=100, pretrained="LibreYOLO9s.pt")pretrained bestimmt den Ausgangspunkt des Laufs. Übergib True, um den veröffentlichten Checkpoint für dasselbe Modell und dieselbe Größe zu laden, oder einen Namen beziehungsweise Pfad für andere Gewichte. Tensoren mit unpassender Form werden übersprungen statt abgelehnt. Der Lauf protokolliert die Anzahl der geladenen Tensoren, sodass auch ein mit einer anderen Klassenanzahl trainierter Checkpoint als Ausgangspunkt dienen kann.
Das Stride-4-Modell besitzt keinen eigenen veröffentlichten COCO-Checkpoint. True wird dafür zu einer nicht vorhandenen Datei aufgelöst und der Download schlägt fehl. Gib stattdessen einen Basischeckpoint zur Objekterkennung an.
Unter Training findest du Informationen zu Datensätzen, Augmentation, Multi-GPU und Loggern.
Das Basismodell kann neben seinem Haupt-Head einen PGI-Hilfszweig trainieren. Der Zweig wird nur beim Training verwendet: Vorhersage und Export nutzen den Haupt-Head. Ein Lauf hängt ihn an, wenn die Startgewichte PGI-Tensoren enthalten oder das Training von Grund auf neu beginnt. Die veröffentlichten Basis-Checkpoints enthalten keine, daher trainiert ein Fine-Tuning von ihnen nur den Haupt-Head und protokolliert das. aux_weight=0.25 hängt trotzdem einen neuen Zweig mit diesem Loss-Gewicht an, aux_weight=0 hält ihn ausgeschaltet. Ein fortgesetzter Lauf behält das PGI-Setup seines Checkpoints. Bei den Größen m und c ist der Zweig der aus dem Upstream: ein zweites Backbone auf dem Eingabebild, dessen Stufen CBFuse mit CBLinear-Abgriffen des Haupt-Backbones aufsummiert, und ein eigener Head, bei 80 Klassen 12.8M und 25.7M Parameter, die nur im Training existieren. Das End-to-End-Modell und das Stride-4-Modell haben keinen PGI-Zweig.
Alle drei Varianten beschneiden die L2-Norm des Gradienten vor jedem Optimizer-Schritt auf 10; clip_max_norm=0 schaltet das Clipping ab. Die Label-Zuweisung bewertet Anchors in fp32, auch unter float16-Autocast. max_labels=300 begrenzt die pro Trainingsbild behaltenen Boxen, darüber hinausgehende Boxen werden mit einer einmaligen Warnung verworfen; der Speicherbedarf der Zuweisung folgt den tatsächlichen Boxen jedes Bildes, nicht der Obergrenze. Das SGD-Momentum steigt während drei Epochen von 0.8 auf 0.937. letterbox_pad=None übernimmt den Checkpoint-Eintrag: Nicht markierte Gewichte verwenden topleft, neue offizielle Konvertierungen speichern center.
Mosaic in YOLO9 und YOLOX bevorzugt annotierte Partnerbilder bei höchstens 20 Ziehungen; YOLO9-MixUp verwendet dieselbe Regel. MixUp ist standardmäßig aus (mixup_prob=0). Ist es an, wird das Mischverhältnis aus Beta(1, 1) gezogen, gleichverteilt auf [0, 1], wie in MultimediaTechLab/YOLO. Siehe Ereignishistogramme für Eingabeprofile ohne RGB.
Validierung
val() gibt ein Dictionary mit metrics/-Schlüsseln für Precision, Recall, mAP 50 und mAP 50-95 zurück, gemessen anhand jedes Datensatzes im Format, das du für das Training verwendet hast.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mAP50-95"])print(metrics["metrics/mAP50"])libreyolo val model=LibreYOLO9s.pt data=my-dataset.yaml# Die mitgelieferte COCO-YAML-Datei enthält ein Downloadskript und benötigt# daher eine ausdrückliche Berechtigung, sofern der Datensatz noch nicht lokal vorliegt.libreyolo val model=LibreYOLO9c.pt data=coco.yaml imgsz=640 \ allow_download_scripts=TrueExport
| Aufgabe | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Detection | Detection to ONNX: unterstützt | Detection to TorchScript: unterstützt | Detection to ExecuTorch: unterstützt | Detection to TensorRT: unterstützt | Detection to OpenVINO: unterstützt | Detection to Paddle: unterstützt | Detection to MNN: unterstützt | Detection to RKNN: nicht unterstützt | Detection to ncnn: unterstützt | Detection to TFLite: nicht unterstützt | Detection to CoreML: nicht unterstützt | Detection to Core AI: unterstützt |
Ein Häkchen gilt für alle drei Varianten. Wo sie sich unterscheiden, zeigt die Matrix die schwächste Unterstützung der drei.
Ein exportiertes Artefakt wird über seine Dateiendung wieder durch LibreYOLO() geladen. Eine .onnx- oder .engine-Datei verhält sich daher wie ein Checkpoint und gibt dasselbe Results-Objekt zurück. Du kannst den Graphen auch in einer eigenständigen Laufzeitumgebung ohne installiertes LibreYOLO ausführen. Dann musst du Vor- und Nachverarbeitung selbst implementieren.
Beim Basismodell zur Objekterkennung lässt sich die Nachverarbeitung in den Graphen verschieben. nms=True bei einem ONNX-Export bettet die Unterdrückung in das Modell ein. Die erste Ausgabe wird zu einem festen Tensor der Form (1, max_det, 6), dessen Zeilen x1, y1, x2, y2, score, class enthalten und hinter der Anzahl der Erkennungen mit Nullen aufgefüllt werden. Dieser Graph besitzt Batchgröße 1 und keine dynamischen Achsen. Das End-to-End-Modell und das Stride-4-Modell akzeptieren dieses Flag nicht.
Jedes Format installiert ein anderes Extra und besitzt eigene Argumente. Beides ist auf der Seite des jeweiligen Formats beschrieben.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.export(format="onnx", imgsz=640)libreyolo export model=LibreYOLO9s.pt format=onnx imgsz=640libreyolo export model=LibreYOLO9s.pt format=onnx nms=True \ conf=0.25 iou=0.45 max_det=300from libreyolo import LibreYOLO, SAMPLE_IMAGE # Die Factory leitet anhand der Dateiendung weiter, daher wird ein exportiertes Artefakt# wie jeder Checkpoint geladen und gibt dasselbe Results-Objekt zurück.model = LibreYOLO("LibreYOLO9s.onnx")result = model(SAMPLE_IMAGE) print(result.boxes.xyxy)TFLite INT8 verwendet int8=True mit Kalibrierungsdaten.
ONNX-Ein- und Ausgaben
LibreYOLO9
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Farbe | RGB |
| Skalierung | Pixel / 255 |
| Normalisierung | keine |
| Größenanpassung | letterbox, bilinear, Füllwert 114, Position der Füllung aus dem Metadatenschlüssel letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
Detection, Standardexport
| Ausgabe | Form | Bedeutung |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Nachbearbeitung
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Detection, nms=True
| Ausgabe | Form | Bedeutung |
|---|---|---|
output | [1, max_det, 6] | Rows are x1, y1, x2, y2, score, class in input-canvas pixels, zero-padded past the detection count. Confidence, IoU and max_det are baked in and recorded as nms_conf, nms_iou and max_det metadata. |
raw | [1, 4 + nc, anchors] | The same tensor as the default export's output, before suppression. |
Nachbearbeitung
- Drop rows whose score is 0 or below your threshold.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
LibreYOLO9E2E
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Farbe | RGB |
| Skalierung | Pixel / 255 |
| Normalisierung | keine |
| Größenanpassung | letterbox, bilinear, Füllwert 114, Position der Füllung aus dem Metadatenschlüssel letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, Standardexport
| Ausgabe | Form | Bedeutung |
|---|---|---|
output | [batch, 4 + nc, anchors] | Predictions of the one-to-one head only. Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Nachbearbeitung
- Transpose to [anchors, 4 + nc].
- Flatten the [anchors, nc] scores into one list of anchors x nc (anchor, class) pairs. Pair i belongs to anchor i / nc (integer division) and class i % nc.
- Keep the 300 highest-scoring pairs (max_det), highest first. One anchor can yield several classes.
- Of those, keep the pairs whose score is above the confidence threshold (0.25 by default).
- Do not run NMS. The one-to-one head is trained to fire once per object, and LibreYOLO ignores the iou setting for this model.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
LibreYOLO9P2
| Tensor | images float32 [batch, 3, height, width] |
|---|---|
| Farbe | RGB |
| Skalierung | Pixel / 255 |
| Normalisierung | keine |
| Größenanpassung | letterbox, bilinear, Füllwert 114, Position der Füllung aus dem Metadatenschlüssel letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, Standardexport
| Ausgabe | Form | Bedeutung |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 4, 8, 16 and 32, 34000 at 640 x 640. nc is 10 for LibreYOLO9P2s-visdrone. |
Nachbearbeitung
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Um deine eigene Implementierung zu prüfen, lade dieselbe Datei mit LibreYOLO: LibreYOLO("model.onnx").predict("image.jpg") liefert die Referenzergebnisse. Geprüft mit LibreYOLO 1.7.0.
Checkpoints
Alle für diese Familie veröffentlichten Gewichtsdateien.
| Datei | Eingabe (px) | Lizenz der Gewichte |
|---|---|---|
| Detection | ||
| LibreYOLO9t.pt | 640 | mit |
| LibreYOLO9s.pt | 640 | mit |
| LibreYOLO9m.pt | 640 | mit |
| LibreYOLO9c.pt | 640 | mit |
| LibreYOLO9E2Et.pt | 640 | mit |
| LibreYOLO9E2Es.pt | 640 | mit |
| LibreYOLO9E2Em.pt | 640 | mit |
| LibreYOLO9E2Ec.pt | 640 | mit |
| LibreYOLO9P2s-visdrone.pt | cc-by-nc-sa-3.0 | |
Jede oben aufgeführte Datei ist heute in der LibreYOLO-Organisation verfügbar und wird bei der ersten Verwendung heruntergeladen.
Lizenzierung
Prüfe die Lizenz im Hugging-Face-Repository der konkreten Gewichte, die du herunterlädst. Jeder Checkpoint in der LibreYOLO-Organisation hat eine Lizenz, und sie ist innerhalb einer Familie nicht immer gleich. Dieses Repository ist die maßgebliche Quelle. Die Zusammenfassung unten beschreibt den Stand bei der letzten Verifizierung dieser Seite.
Dies ist eine Beschreibung der beteiligten Lizenzen und keine Rechtsberatung. Wenn die Antwort kommerziell relevant ist, lies die Lizenzen selbst und hole eigenen Rechtsrat ein.
- Originalarbeit
- YOLOv9, MultimediaTechLab
- Upstream-Lizenz
- MIT
- Upstream-Quelle
- github.com/MultimediaTechLab/YOLO
- LibreYOLO-Code
- MIT
- Gewichte
- MIT, erneut unter huggingface.co/LibreYOLO veröffentlicht
- Einordnung
- MIT is a permissive license, so these weights can be used in commercial and closed-source products. The one standing obligation is to keep the license text and the copyright notice, Kin-Yiu Wong and Hao-Tang Tsui, with any copy you redistribute. It places no condition on your own application code, and a model you train yourself on your own data is yours. Two things are worth knowing beyond that. The code is ported from the authors' MIT re-release of YOLOv9, MultimediaTechLab/YOLO at commit c4cb5f6f, not the GPL-3.0 repository that carries the same model, so the permissive terms come from the source LibreYOLO actually derives from. And one checkpoint in this family is not MIT: the weight repository of the stride-4 VisDrone model, LibreYOLO9P2s-visdrone.pt, declares CC BY-NC-SA 3.0, which rules out commercial use and requires share-alike on derivatives.
Der Code aller drei Varianten ist aus
MultimediaTechLab/YOLO beim Commit
c4cb5f6f (MIT) portiert. Der One-to-One-Prädiktor des End-to-End-Modells folgt
dem Design von DATE von Yiqun Chen
(Apache-2.0), für LibreYOLO implementiert, ohne dass DATE-Code kopiert wurde. Die
Stride-4-Ebene ist LibreYOLO-Code.
Der Luftbild-Checkpoint mit Stride 4 sagt die VisDrone-Klassen vorher. Verwende die vom Herausgeber im Gewichtsrepository deklarierte Lizenz.
Zitieren
@inproceedings{wang2024yolov9,
      title={{YOLOv9}: Learning What You Want to Learn Using Programmable Gradient Information},
      author={Wang, Chien-Yao and Yeh, I-Hau and Liao, Hong-Yuan Mark},
      year={2024},
      booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
}
Aus dem Zitierblock der Autoren unter github.com/MultimediaTechLab/YOLO#citations kopiert.