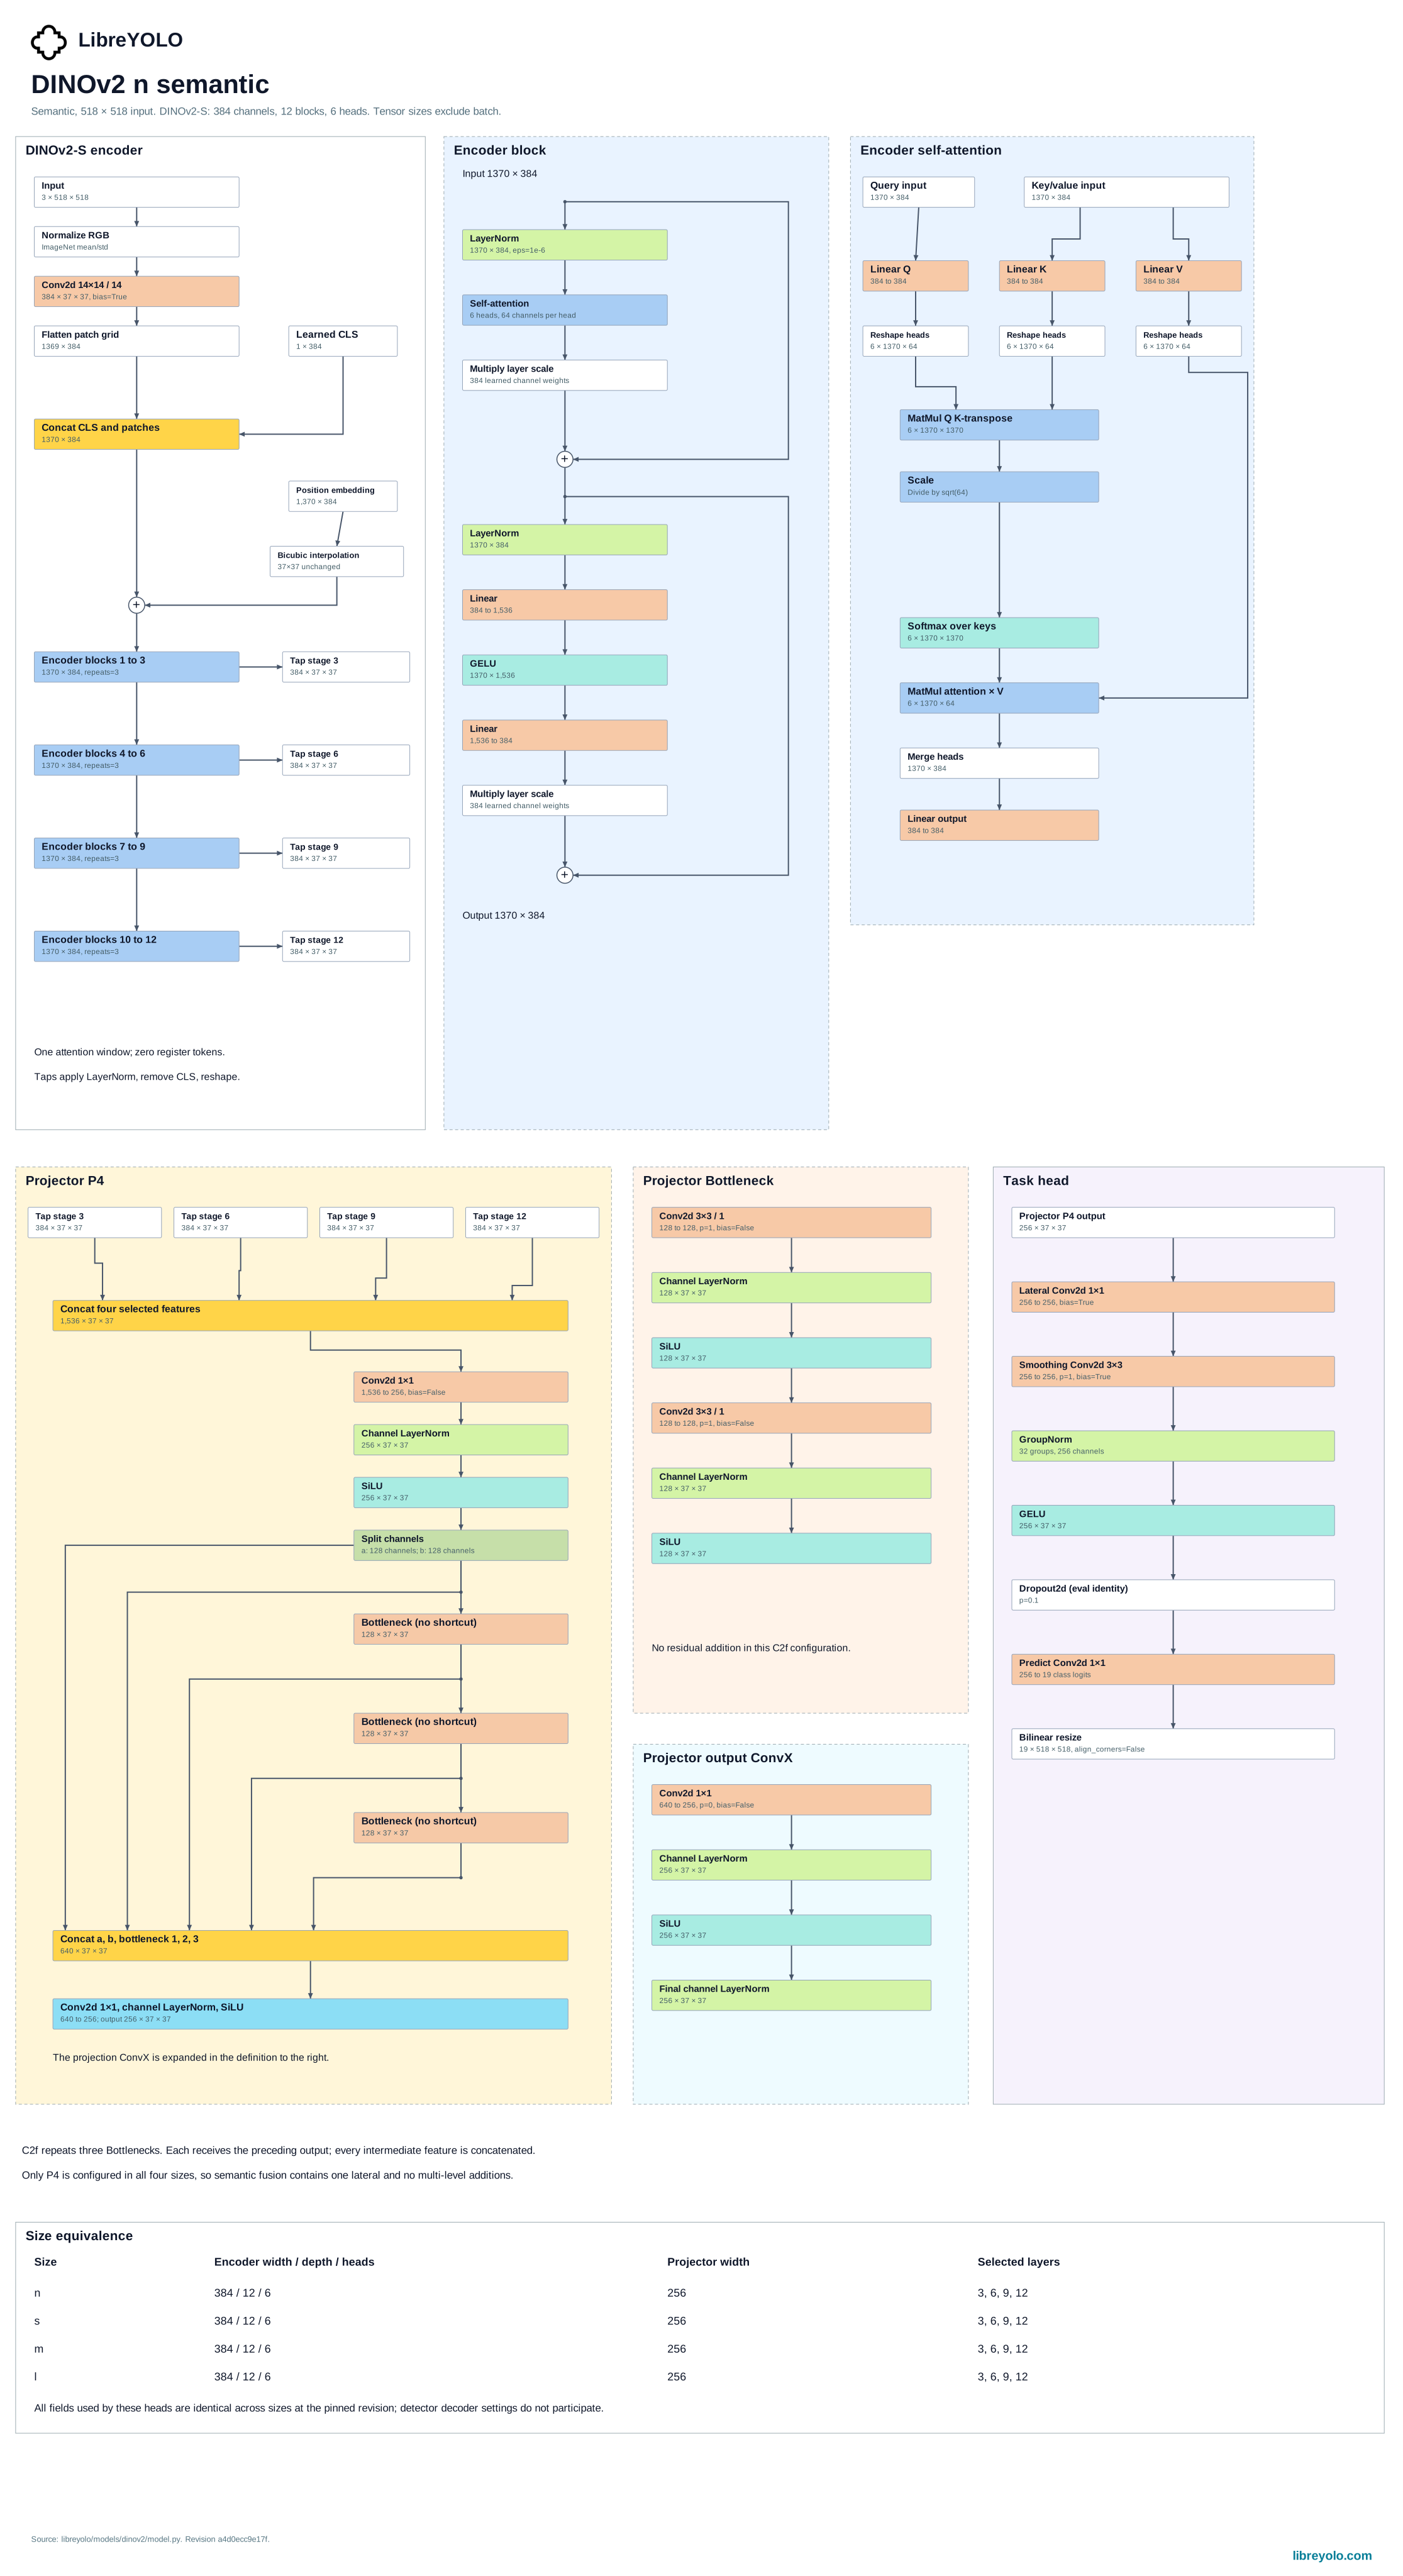
DINOv2
DINOv2 est un vision transformer auto-supervisé entraîné par Meta AI pour produire des caractéristiques d'images polyvalentes sans étiquettes. LibreYOLO encapsule son backbone DINOv2-with-Registers pour trois tâches : la segmentation sémantique, la classification et l'embedding d'image entière.
- Tâches
- semantic segmentation, classification, embeddings
- Tailles
- n, s, m, l at 518 px
- Installer
pip install "libreyolo[rfdetr]"- Niveau de support
- Pris en charge, depuis v1.3.0. Modèles entraînables complémentaires : maintenus au vert dans la CI, avec des fonctionnalités ajoutées selon les occasions.
- Licences
- Code MIT, poids Apache-2.0. Usage commercial
Installation
LibreDINOv2 ne s'enregistre que si transformers est installé, la même
dépendance optionnelle dont RF-DETR a besoin pour son backbone DINOv2 ; il
demande donc le même extra.
pip install "libreyolo[rfdetr]"Prédire
LibreYOLO ne publie aucun checkpoint LibreDINOv2. Construisez le wrapper
directement au lieu de charger un fichier : model_path=None (la valeur par
défaut) télécharge au premier usage le backbone Apache-2.0
facebook/dinov2-with-registers-small de Meta depuis Hugging Face. task=
choisit ce qui tourne par-dessus.
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Aucun checkpoint hébergé par LibreYOLO n'existe pour cette famille :# ceci télécharge le backbone Apache-2.0 DINOv2-with-Registers-small# depuis l'org Hugging Face de Meta. La tête dense reste initialisée# aléatoirement tant que vous ne l'entraînez pas (voir Entraîner plus bas).model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= est le nombre de classes de votre dataset ; la tête# linéaire reste initialisée aléatoirement tant que vous ne# l'entraînez pas.model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Contourne toutes les têtes de tâche : le backbone seul suffit,# donc aucun fine-tuning n'est nécessaire pour que ce soit utile.model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D), normalisé L2from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # Wrapper pratique : lance predict() et empile chaque ligne dans un# seul tenseur (N, D).features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" et task="classify" ajoutent une tête dense ou linéaire
par-dessus le backbone ; cette tête est initialisée aléatoirement et n'est
utile qu'une fois que vous l'avez entraînée (voir Entraîner).
task="embed" saute toutes les têtes et renvoie le token CLS final normalisé
du backbone comme une seule ligne pour l'image entière dans
result.embeddings, si bien qu'il ne demande aucun entraînement.
result.boxes vaut toujours None : aucune des trois tâches ne produit de
détections par instance. Voir la prédiction pour les sources,
le streaming et le traitement des résultats.
Variantes
size choisit la largeur du projecteur de style RF-DETR posé par-dessus le
backbone, pas le backbone lui-même : toutes les tailles partagent le même
encodeur DINOv2-S (small). La segmentation sémantique tourne sur la grille de
patches carrée native de DINOv2 ; la classification et l'embedding tournent à
la résolution de classification, plus petite, utilisée pour entraîner le
linear probe.
Entraîner
task="semantic" et task="classify" s'entraînent tous les deux ;
task="embed" n'a aucune tête dépendante des classes à ajuster et lève
NotImplementedError si vous appelez train() dessus.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)Les arguments nommés principaux sont ici batch_size et lr, pas batch et
lr0 utilisés par la plupart des autres familles ; batch et lr0 restent
acceptés et sont redirigés vers eux, mais passer les deux lève une erreur de
conflit. output_dir= (par défaut None) remplace project=/name=
comme moyen principal de placer un run, même si passer directement
project=/name= fonctionne toujours. Voir l'entraînement
pour les datasets, l'augmentation de données, le multi-GPU et les loggers.
Les nouveaux entraînements utilisent un répertoire runs/train/dinov2_exp incrémenté avec exist_ok=False. resume=True restaure l'état de l'entraîneur et préserve le répertoire choisi. La classification prend en charge cls_pw et class_weights, décrits dans les hyperparamètres.
Valider
val() renvoie un dictionnaire de clés metrics/ : mIoU et exactitude par
pixel pour task="semantic", exactitude top-1 et top-5 pour
task="classify". task="embed" n'a aucune vérité terrain à laquelle se
mesurer et lève NotImplementedError si vous appelez val() dessus.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])La calibration pour la classification et les embeddings réutilise le pipeline de classification du modèle. L'évaluation utilise la transformation de la famille.
Exporter
| Tâche | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX : pris en charge | Semantic segmentation to TorchScript : pris en charge | Semantic segmentation to ExecuTorch : pris en charge | Semantic segmentation to TensorRT : pris en charge | Semantic segmentation to OpenVINO : pris en charge | Semantic segmentation to Paddle : non pris en charge | Semantic segmentation to MNN : non pris en charge | Semantic segmentation to RKNN : non pris en charge | Semantic segmentation to ncnn : non pris en charge | Semantic segmentation to TFLite : non pris en charge | Semantic segmentation to CoreML : non pris en charge | Semantic segmentation to Core AI : non pris en charge |
| Classification | Classification to ONNX : pris en charge | Classification to TorchScript : pris en charge | Classification to ExecuTorch : pris en charge | Classification to TensorRT : pris en charge | Classification to OpenVINO : pris en charge | Classification to Paddle : non pris en charge | Classification to MNN : non pris en charge | Classification to RKNN : non pris en charge | Classification to ncnn : non pris en charge | Classification to TFLite : non pris en charge | Classification to CoreML : non pris en charge | Classification to Core AI : pris en charge |
| Embeddings | Embeddings to ONNX : pris en charge | Embeddings to TorchScript : pris en charge | Embeddings to ExecuTorch : pris en charge | Embeddings to TensorRT : pris en charge | Embeddings to OpenVINO : pris en charge | Embeddings to Paddle : non pris en charge | Embeddings to MNN : non pris en charge | Embeddings to RKNN : non pris en charge | Embeddings to ncnn : non pris en charge | Embeddings to TFLite : pris en charge | Embeddings to CoreML : non pris en charge | Embeddings to Core AI : non pris en charge |
Chaque tâche prend en charge un sous-ensemble de formats différent, indiqué
ci-dessus. Un artefact exporté se recharge via LibreYOLO() d'après son
suffixe de fichier, si bien qu'un fichier .onnx ou .engine se comporte
comme un checkpoint et renvoie les mêmes Results. L'export
liste les arguments que chaque format accepte.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # La factory route selon le suffixe du fichier : un artefact exporté se# charge comme n'importe quel checkpoint et renvoie le même objet# Results. L'export nomme le fichier d'après la tâche, ici# LibreDINOv2s-sem.onnx.model = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)Licence
Vérifiez la licence dans le dépôt Hugging Face des poids précis que vous téléchargez. Chaque checkpoint de l<link>organisation LibreYOLO</link> en possède une, et elles ne sont pas toujours identiques au sein dune même famille. Ce dépôt fait autorité ; le résumé ci-dessous décrit les conditions applicables lors de la dernière vérification de cette page.
Ceci décrit les licences concernées et ne constitue pas un conseil juridique. Si la réponse a une importance commerciale, lisez vous-même les licences et consultez votre propre avocat.
- Travail d'origine
- DINOv2, Meta AI (FAIR)
- Licence du projet d'origine
- Apache-2.0
- Source du projet d'origine
- github.com/facebookresearch/dinov2
- Code de LibreYOLO
- MIT
- Poids
- Apache-2.0, distribués par leurs auteurs. LibreYOLO ne les héberge pas et n'en fournit pas de miroir.
- Interprétation
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
La ligne « Poids » ci-dessus nomme la licence qui s'applique, Apache-2.0, mais
rien n'est réellement republié sous l'org Hugging Face de LibreYOLO pour cette
famille : LibreYOLO n'héberge aucun checkpoint LibreDINOv2 qui lui soit
propre. Ce que LibreDINOv2(model_path=None) télécharge, c'est le dépôt
facebook/dinov2-with-registers-small de Meta, intact.
Citation
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
Copié depuis le bloc de citation des auteurs sur github.com/facebookresearch/dinov2#citing-dinov2.