YOLOv9
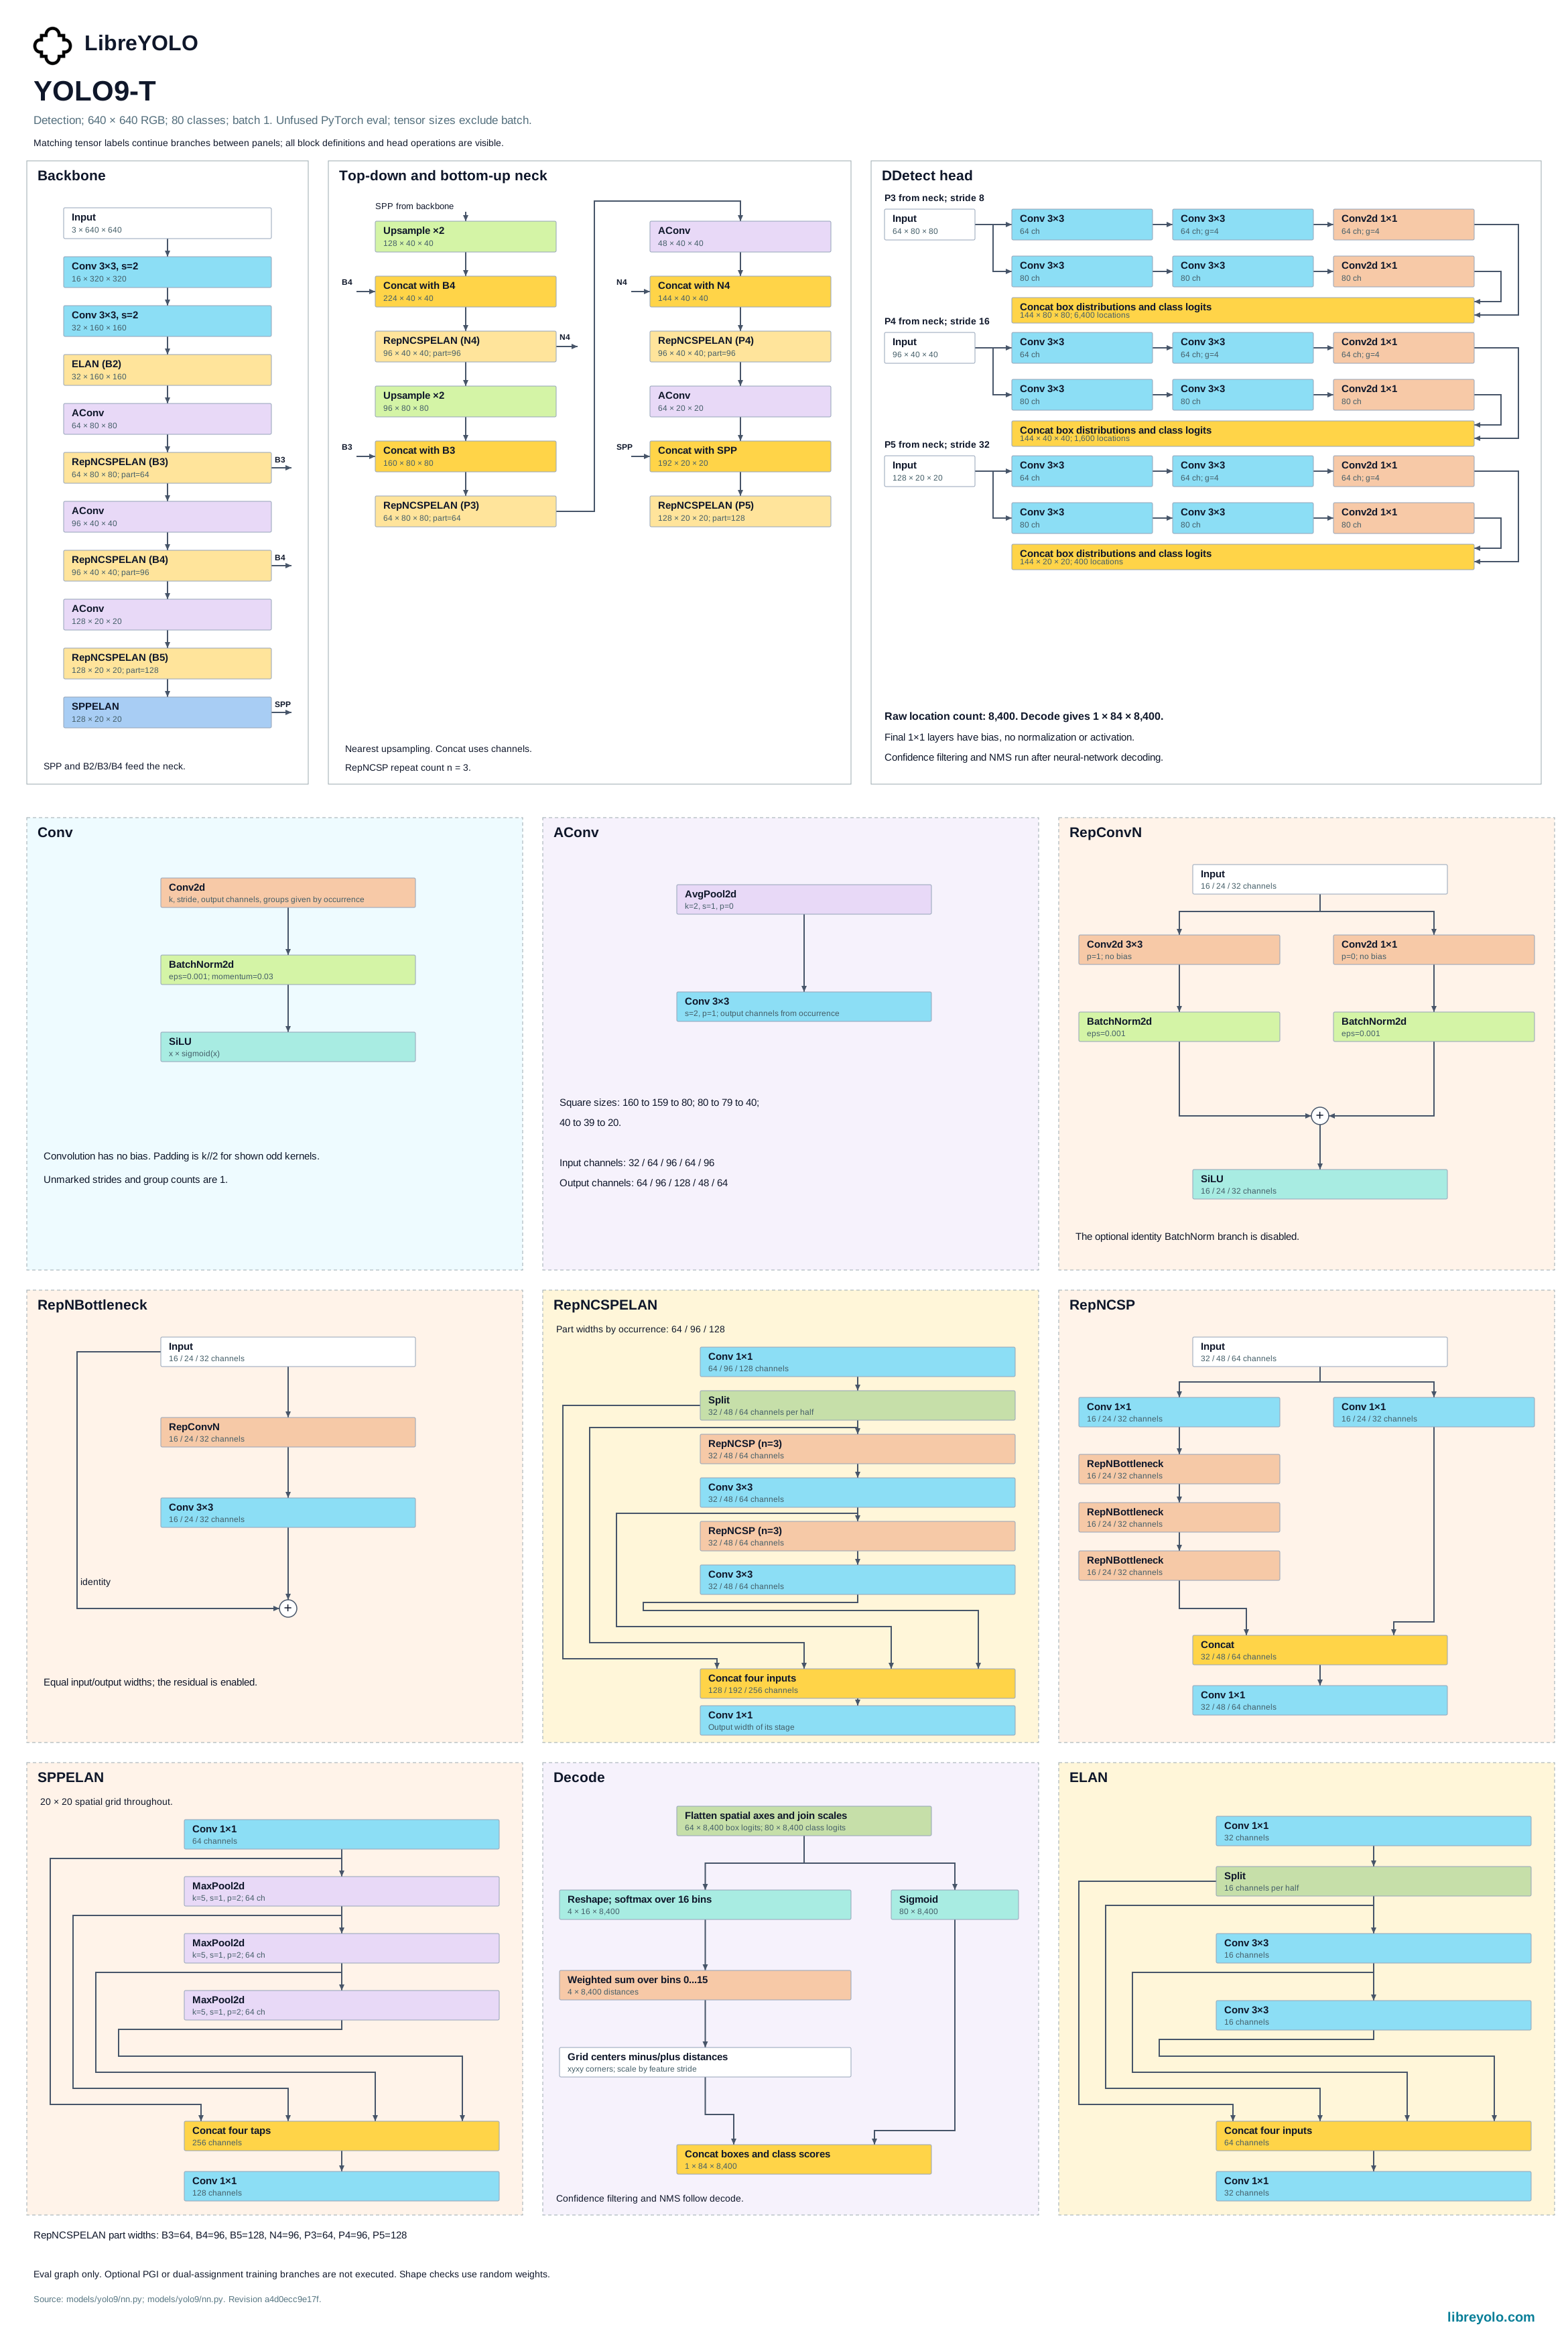
YOLOv9 est un détecteur convolutionnel mono-étape : une passe attribue un score à une grille dense de bounding boxes et la NMS supprime les doublons. LibreYOLO en propose trois variantes, dont une sans étape de NMS.
- Tâches
- detection
- Tailles
- yolo9: t, s, m, c at 640 px; yolo9_p2: t, s at 640 px
- Installer
pip install libreyolo- Niveau de support
- Fer de lance, depuis v1.0.0. Les fonctionnalités sont d'abord conçues et entièrement validées sur GPU ici.
- Licences
- Code MIT, poids MIT. Usage commercial
Installer
YOLOv9 ne nécessite aucun extra au-delà du package de base.
pip install libreyoloPrédire
Les poids sont téléchargés depuis Hugging Face à la première utilisation et mis en cache localement.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreYOLO9s.pt")result = model(SAMPLE_IMAGE, save=True) for box in result.boxes: print(box.cls, box.conf, box.xyxy)libreyolo predict model=LibreYOLO9s.pt save=True \ source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpgfrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Même appel, autre checkpoint. La tête de bout en bout renvoie ses propres# prédictions aux scores les plus élevés, aucune NMS ne s'exécute donc et iou est ignoré.model = LibreYOLO("LibreYOLO9E2Es.pt")result = model(SAMPLE_IMAGE, conf=0.25, max_det=300) print(len(result.boxes))L'objet Results renvoyé est celui de toutes les familles, le remplacement du
détecteur ne demande donc de modifier qu'une ligne. Sur les modèles de base et
de stride 4, conf définit le seuil de confiance et iou le seuil de NMS. Le
modèle de bout en bout n'exécute aucune NMS et ignore iou ; conf et
max_det déterminent donc sa sortie. Consultez la
prédiction pour les sources, le streaming et la gestion des
résultats.
Variantes
Trois variantes partagent un backbone. Toutes trois effectuent uniquement de la détection et acceptent les mêmes arguments.
Le modèle de base prédit sur trois échelles de caractéristiques et élimine les bounding boxes dupliquées avec la NMS.
Le modèle de bout en bout conserve cette tête et lui ajoute une branche d'appariement un-à-un. L'inférence lit uniquement cette branche et conserve ses prédictions aux scores les plus élevés, aucune NMS n'est donc exécutée. Choisissez-le lorsque le runtime de déploiement ne possède pas d'opérateur NMS.
Le modèle de stride 4 expose un niveau plus haut dans le backbone, prolonge le neck jusqu'à celui-ci et prédit sur quatre échelles au lieu de trois. L'échelle supplémentaire cible les objets qui couvrent peu de pixels ; l'unique checkpoint publié pour ce modèle est entraîné sur des images aériennes. Les checkpoints de détection de base peuvent y être transférés : le backbone et le neck sont chargés sans modification, les trois tours de tête pré-entraînées sont décalées d'un emplacement et la tour de stride 4 part d'une initialisation aléatoire.
| Checkpoint | Entrée (px) | mAP 50-95 | Paramètres (M) |
|---|---|---|---|
| LibreYOLO9c | 640 | 56.4 | 25.5 |
| LibreYOLO9m | 640 | 55.3 | 20.12 |
| LibreYOLO9s | 640 | 55.9 | 7.2 |
| LibreYOLO9t | 640 | 41.8 | 2.04 |
COCO val2017, 500 images. Mesuré par le banc de benchmark de LibreYOLO et publié sur Vision Analysis, où sont comparées la latence selon le matériel et les runtimes et où sont conservés les enregistrements complets des exécutions.
Entraîner
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.train(data="my-dataset.yaml", epochs=100, imgsz=640, batch=16)libreyolo train model=LibreYOLO9s.pt data=my-dataset.yaml \ epochs=100 imgsz=640 batch=16from libreyolo import LibreYOLO9P2 # La variante de stride 4 n'a pas de checkpoint COCO propre, utilisez donc le nom# d'un checkpoint de détection de base : son backbone et son neck se chargent sans# modification et la tour de tête de stride 4 part d'une initialisation aléatoire.model = LibreYOLO9P2(None, size="s")model.train(data="my-dataset.yaml", epochs=100, pretrained="LibreYOLO9s.pt")pretrained détermine le point de départ de l'exécution. Transmettez True
pour charger le checkpoint publié du même modèle et de la même taille, ou un
nom ou chemin pour tout autre fichier. Les tenseurs dont la forme ne
correspond pas sont ignorés plutôt que refusés, et l'exécution consigne le
nombre de tenseurs chargés. Un checkpoint entraîné avec un nombre de classes
différent reste donc un point de départ utilisable.
Le modèle de stride 4 n'a aucun checkpoint COCO publié qui lui soit propre.
Pour celui-ci, True se résout donc en un fichier inexistant et le
téléchargement échoue. Indiquez plutôt le nom d'un checkpoint de détection de
base.
Consultez l'entraînement pour les datasets, l'augmentation, le multi-GPU et les loggers.
Le modèle de base peut entraîner une branche auxiliaire PGI à côté de sa tête
principale. La branche sert uniquement à l'entraînement : la prédiction et
l'export utilisent la tête principale. Un run l'attache lorsque les poids de
départ contiennent des tenseurs PGI ou lorsqu'il s'entraîne à partir de zéro.
Les checkpoints de base publiés n'en contiennent aucun, donc un fine-tuning à
partir d'eux n'entraîne que la tête principale et le consigne dans les logs.
aux_weight=0.25 attache malgré tout une nouvelle branche avec ce poids de loss,
et aux_weight=0 la garde désactivée. Un run repris conserve la configuration
PGI de son checkpoint. Sur les tailles m et c, la branche est celle
d'origine : un second backbone sur l'image d'entrée, dont CBFuse somme les
étapes avec les prises CBLinear du backbone principal, et sa propre tête, soit
12.8M et 25.7M de paramètres réservés à l'entraînement avec 80 classes. Les
modèles de bout en bout et à stride 4 n'ont pas de branche PGI.
Les trois variantes écrêtent la norme L2 du gradient à 10 avant chaque pas de
l'optimiseur ; clip_max_norm=0 désactive l'écrêtage. L'affectation des labels
évalue les ancres en fp32, y compris sous autocast float16. max_labels=300
plafonne les boîtes conservées par image d'entraînement, et les boîtes au-delà
sont ignorées avec un avertissement unique ; la mémoire d'affectation suit les
boîtes réelles de chaque image, pas le plafond. Le momentum SGD passe de 0.8 à
0.937 pendant trois époques. letterbox_pad=None hérite de l'indication du
checkpoint : les poids non marqués utilisent topleft, tandis que les nouvelles
conversions officielles enregistrent center.
Les mosaïques YOLO9 et YOLOX privilégient les partenaires annotés, avec au plus 20 tirages ; MixUp dans YOLO9 utilise la même politique. MixUp est désactivé par défaut (mixup_prob=0). Lorsqu'il est activé, le ratio de mélange est tiré selon Beta(1, 1), uniforme sur [0, 1], comme dans MultimediaTechLab/YOLO. Consultez les histogrammes d'événements pour les profils d'entrée non RGB.
Valider
val() renvoie un dictionnaire de clés metrics/ couvrant la précision, le
rappel, la mAP 50 et la mAP 50-95, mesurés sur tout dataset au format utilisé
pour l'entraînement.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mAP50-95"])print(metrics["metrics/mAP50"])libreyolo val model=LibreYOLO9s.pt data=my-dataset.yaml# Le YAML COCO fourni contient un script de téléchargement intégré, il nécessite donc# une autorisation explicite sauf si le dataset est déjà présent localement.libreyolo val model=LibreYOLO9c.pt data=coco.yaml imgsz=640 \ allow_download_scripts=TrueExporter
| Tâche | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Detection | Detection to ONNX : pris en charge | Detection to TorchScript : pris en charge | Detection to ExecuTorch : pris en charge | Detection to TensorRT : pris en charge | Detection to OpenVINO : pris en charge | Detection to Paddle : pris en charge | Detection to MNN : pris en charge | Detection to RKNN : non pris en charge | Detection to ncnn : pris en charge | Detection to TFLite : non pris en charge | Detection to CoreML : non pris en charge | Detection to Core AI : pris en charge |
Une coche s'applique aux trois variantes ; lorsqu'elles diffèrent, la matrice indique la prise en charge la plus faible des trois.
Un artefact exporté se recharge dans LibreYOLO() grâce au suffixe de son
fichier. Un fichier .onnx ou .engine se comporte donc comme un checkpoint
et renvoie les mêmes Results. Vous pouvez également exécuter le graphe dans
un runtime nu, sans installer LibreYOLO, mais vous devez alors écrire vous-même
le prétraitement et le post-traitement.
Pour le modèle de détection de base, la moitié post-traitement peut être
intégrée au graphe. nms=True lors d'un export ONNX place la suppression dans
le modèle et la première sortie devient un tenseur fixe (1, max_det, 6) dont
les lignes sont x1, y1, x2, y2, score, class, complétées par des zéros après
le nombre de détections. Ce graphe utilise un batch de 1 et ne comporte aucun
axe dynamique. Les modèles de bout en bout et de stride 4 n'acceptent pas ce
paramètre.
Chaque format installe un extra différent et accepte quelques arguments qui lui sont propres. Ces deux aspects sont décrits sur la page du format concerné.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.export(format="onnx", imgsz=640)libreyolo export model=LibreYOLO9s.pt format=onnx imgsz=640libreyolo export model=LibreYOLO9s.pt format=onnx nms=True \ conf=0.25 iou=0.45 max_det=300from libreyolo import LibreYOLO, SAMPLE_IMAGE # La fabrique détermine le chemin selon le suffixe du fichier ; un artefact exporté se charge# donc comme tout checkpoint et renvoie le même objet Results.model = LibreYOLO("LibreYOLO9s.onnx")result = model(SAMPLE_IMAGE) print(result.boxes.xyxy)TFLite INT8 utilise int8=True avec des données de calibration.
Entrées et sorties ONNX
LibreYOLO9
| Tenseur | images float32 [batch, 3, height, width] |
|---|---|
| Couleur | RGB |
| Mise à l'échelle | pixel / 255 |
| Normalisation | aucune |
| Redimensionnement | letterbox, bilinear, valeur de remplissage 114, position du remplissage lue dans la clé de métadonnées letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
Detection, export par défaut
| Sortie | Forme | Signification |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Post-traitement
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Detection, nms=True
| Sortie | Forme | Signification |
|---|---|---|
output | [1, max_det, 6] | Rows are x1, y1, x2, y2, score, class in input-canvas pixels, zero-padded past the detection count. Confidence, IoU and max_det are baked in and recorded as nms_conf, nms_iou and max_det metadata. |
raw | [1, 4 + nc, anchors] | The same tensor as the default export's output, before suppression. |
Post-traitement
- Drop rows whose score is 0 or below your threshold.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
LibreYOLO9E2E
| Tenseur | images float32 [batch, 3, height, width] |
|---|---|
| Couleur | RGB |
| Mise à l'échelle | pixel / 255 |
| Normalisation | aucune |
| Redimensionnement | letterbox, bilinear, valeur de remplissage 114, position du remplissage lue dans la clé de métadonnées letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, export par défaut
| Sortie | Forme | Signification |
|---|---|---|
output | [batch, 4 + nc, anchors] | Predictions of the one-to-one head only. Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Post-traitement
- Transpose to [anchors, 4 + nc].
- Flatten the [anchors, nc] scores into one list of anchors x nc (anchor, class) pairs. Pair i belongs to anchor i / nc (integer division) and class i % nc.
- Keep the 300 highest-scoring pairs (max_det), highest first. One anchor can yield several classes.
- Of those, keep the pairs whose score is above the confidence threshold (0.25 by default).
- Do not run NMS. The one-to-one head is trained to fire once per object, and LibreYOLO ignores the iou setting for this model.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
LibreYOLO9P2
| Tenseur | images float32 [batch, 3, height, width] |
|---|---|
| Couleur | RGB |
| Mise à l'échelle | pixel / 255 |
| Normalisation | aucune |
| Redimensionnement | letterbox, bilinear, valeur de remplissage 114, position du remplissage lue dans la clé de métadonnées letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, export par défaut
| Sortie | Forme | Signification |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 4, 8, 16 and 32, 34000 at 640 x 640. nc is 10 for LibreYOLO9P2s-visdrone. |
Post-traitement
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Pour vérifier votre propre implémentation, passez le même fichier dans LibreYOLO : LibreYOLO("model.onnx").predict("image.jpg") renvoie les résultats de référence. Vérifié avec LibreYOLO 1.7.0.
Checkpoints
Tous les fichiers de poids publiés pour cette famille.
| Fichier | Entrée (px) | Licence des poids |
|---|---|---|
| Detection | ||
| LibreYOLO9t.pt | 640 | mit |
| LibreYOLO9s.pt | 640 | mit |
| LibreYOLO9m.pt | 640 | mit |
| LibreYOLO9c.pt | 640 | mit |
| LibreYOLO9E2Et.pt | 640 | mit |
| LibreYOLO9E2Es.pt | 640 | mit |
| LibreYOLO9E2Em.pt | 640 | mit |
| LibreYOLO9E2Ec.pt | 640 | mit |
| LibreYOLO9P2s-visdrone.pt | cc-by-nc-sa-3.0 | |
Tous les fichiers ci-dessus sont actuellement disponibles dans l<link>organisation LibreYOLO</link> et sont téléchargés à la première utilisation.
Licence
Vérifiez la licence dans le dépôt Hugging Face des poids précis que vous téléchargez. Chaque checkpoint de l<link>organisation LibreYOLO</link> en possède une, et elles ne sont pas toujours identiques au sein dune même famille. Ce dépôt fait autorité ; le résumé ci-dessous décrit les conditions applicables lors de la dernière vérification de cette page.
Ceci décrit les licences concernées et ne constitue pas un conseil juridique. Si la réponse a une importance commerciale, lisez vous-même les licences et consultez votre propre avocat.
- Travail d'origine
- YOLOv9, MultimediaTechLab
- Licence du projet d'origine
- MIT
- Source du projet d'origine
- github.com/MultimediaTechLab/YOLO
- Code de LibreYOLO
- MIT
- Poids
- MIT, republiés sur huggingface.co/LibreYOLO
- Interprétation
- MIT is a permissive license, so these weights can be used in commercial and closed-source products. The one standing obligation is to keep the license text and the copyright notice, Kin-Yiu Wong and Hao-Tang Tsui, with any copy you redistribute. It places no condition on your own application code, and a model you train yourself on your own data is yours. Two things are worth knowing beyond that. The code is ported from the authors' MIT re-release of YOLOv9, MultimediaTechLab/YOLO at commit c4cb5f6f, not the GPL-3.0 repository that carries the same model, so the permissive terms come from the source LibreYOLO actually derives from. And one checkpoint in this family is not MIT: the weight repository of the stride-4 VisDrone model, LibreYOLO9P2s-visdrone.pt, declares CC BY-NC-SA 3.0, which rules out commercial use and requires share-alike on derivatives.
Le code des trois variantes est porté depuis
MultimediaTechLab/YOLO au commit
c4cb5f6f (MIT). Le prédicteur un-à-un du modèle de bout en bout suit la
conception de DATE de Yiqun Chen
(Apache-2.0), implémentée pour LibreYOLO sans copier de code de DATE. Le niveau
de stride 4 est du code LibreYOLO.
Le checkpoint aérien de stride 4 prédit les classes VisDrone. Utilisez la licence déclarée par l'éditeur dans le dépôt de ses poids.
Citation
@inproceedings{wang2024yolov9,
      title={{YOLOv9}: Learning What You Want to Learn Using Programmable Gradient Information},
      author={Wang, Chien-Yao and Yeh, I-Hau and Liao, Hong-Yuan Mark},
      year={2024},
      booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
}
Copié depuis le bloc de citation des auteurs sur github.com/MultimediaTechLab/YOLO#citations.