DINOv2
DINOv2 è un vision transformer autosupervisionato addestrato da Meta AI per produrre feature di immagine generiche senza etichette. LibreYOLO incapsula il suo backbone DINOv2-with-Registers per tre task: segmentazione semantica, classificazione ed embedding dell'immagine intera.
- Task
- semantic segmentation, classification, embeddings
- Dimensioni
- n, s, m, l at 518 px
- Installa
pip install "libreyolo[rfdetr]"- Livello di supporto
- Supportato, dalla v1.3.0. Modelli addestrabili di supporto: mantenuti funzionanti nella CI, ricevono nuove funzionalità quando possibile.
- Licenze
- Codice MIT, pesi Apache-2.0. Uso commerciale
Installazione
LibreDINOv2 si registra solo quando transformers è installato, la stessa
dipendenza opzionale che serve a RF-DETR per il suo backbone DINOv2, quindi
richiede lo stesso extra.
pip install "libreyolo[rfdetr]"Senza di esso, caricare un checkpoint o un nome di modello DINOv2 si ferma con un errore che indica questa riga di installazione.
Predizione
LibreYOLO non pubblica nessun checkpoint LibreDINOv2. Costruisci il wrapper
direttamente invece di caricare un file: model_path=None (il valore
predefinito) scarica al primo utilizzo il backbone Apache-2.0
facebook/dinov2-with-registers-small di Meta da Hugging Face. task=
seleziona che cosa gira sopra di esso.
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Per questa famiglia non esiste nessun checkpoint ospitato da# LibreYOLO: questo scarica il backbone Apache-2.0# DINOv2-with-Registers-small dall'org Hugging Face di Meta. La testa# densa parte da un'inizializzazione casuale finché non la addestri# (vedi Addestramento più sotto).model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= è il numero di classi del tuo dataset; la testa lineare# parte da un'inizializzazione casuale finché non la addestri.model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Salta tutte le teste di task: basta il backbone da solo, quindi non# serve nessun fine-tuning perché sia utile.model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D), normalizzato L2from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # Wrapper di comodo: esegue predict() e impila ogni riga in un unico# tensore (N, D).features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" e task="classify" aggiungono una testa densa o lineare
sopra il backbone; quella testa è inizializzata in modo casuale ed è utile solo
dopo che l'hai addestrata (vedi Addestramento). task="embed" salta
tutte le teste e restituisce il token CLS finale normalizzato del backbone come
un'unica riga per l'immagine intera in result.embeddings, quindi non ha
bisogno di nessun addestramento. result.boxes è sempre None: nessuno dei
tre task produce rilevamenti per istanza. Vedi predizione per
sorgenti, streaming e gestione dei risultati.
Varianti
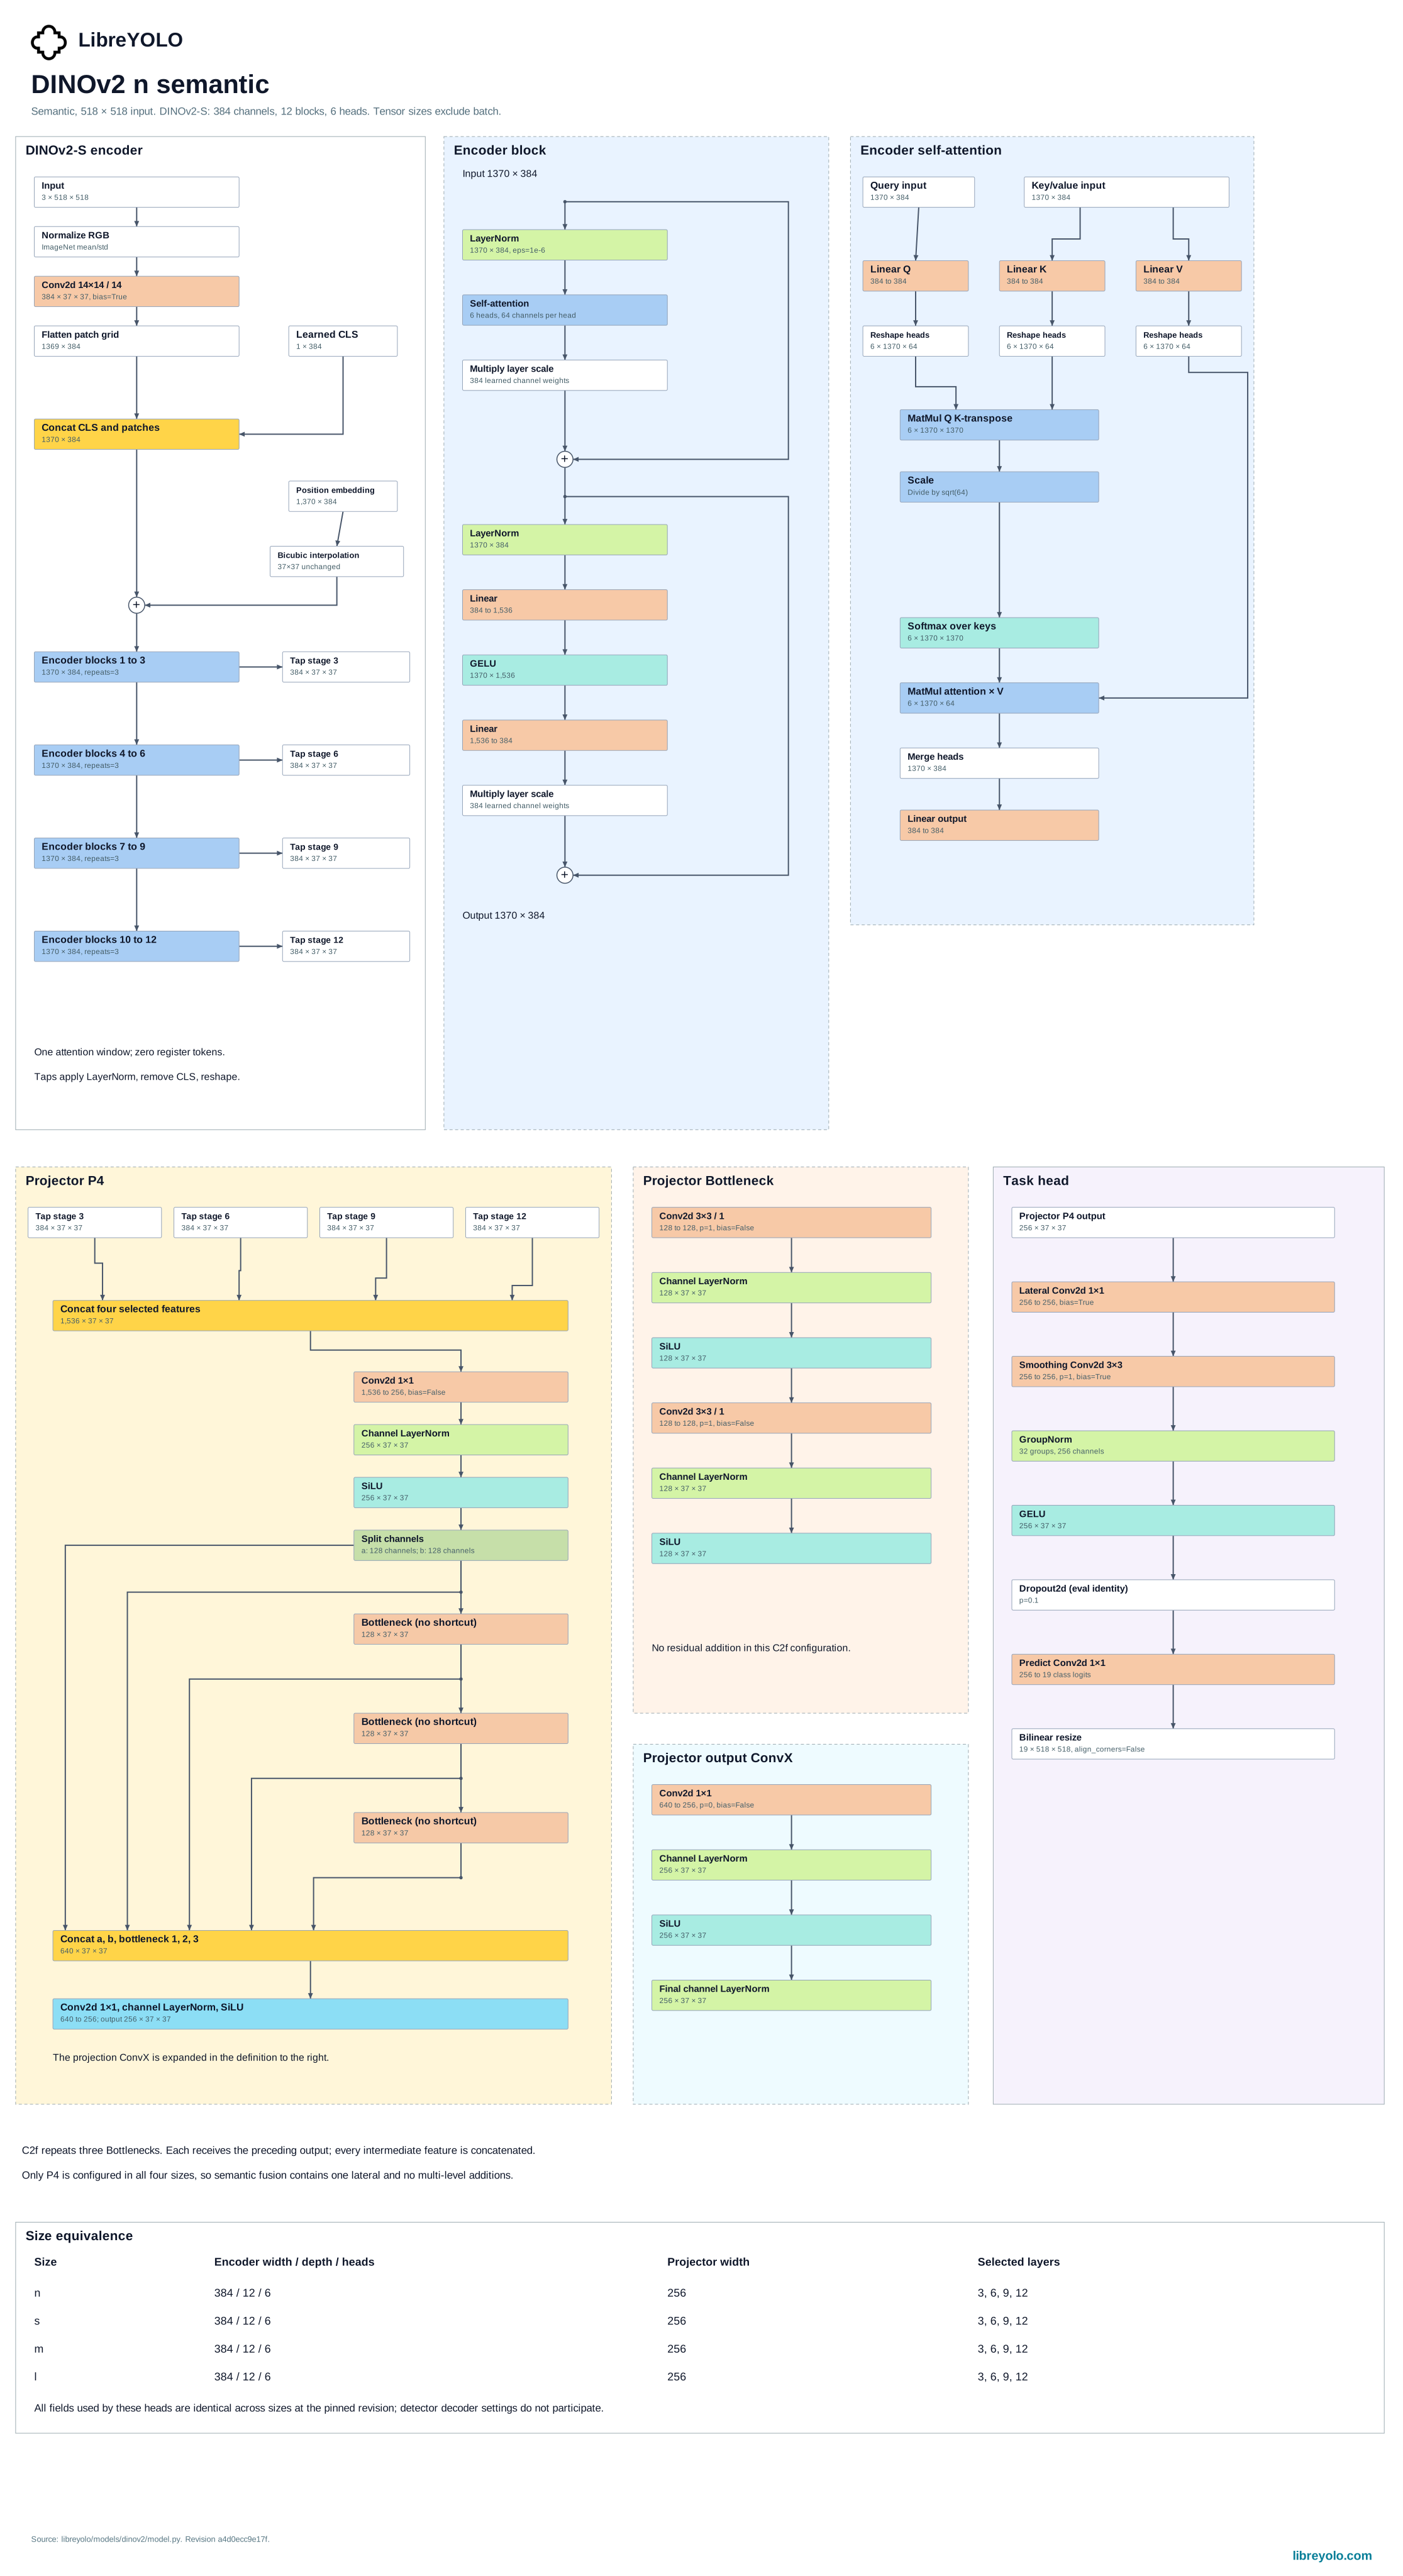
size seleziona la larghezza del proiettore in stile RF-DETR sovrapposto al
backbone, non il backbone stesso: tutte le dimensioni condividono lo stesso
encoder DINOv2-S (small). La segmentazione semantica gira alla griglia di patch
quadrata nativa di DINOv2; la classificazione e l'embedding girano alla
risoluzione di classificazione, più piccola, usata per addestrare il linear
probe.
Addestramento
task="semantic" e task="classify" si addestrano entrambi; task="embed"
non ha nessuna testa dipendente dalle classi da adattare e solleva
NotImplementedError se ci chiami train() sopra.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)Gli argomenti principali qui sono batch_size e lr, invece di batch e lr0 usati dalla maggior parte delle altre famiglie; batch e lr0 sono comunque accettati e convertiti, ma passarli entrambi genera un errore di conflitto. output_dir= (default None) sostituisce project=/name= come metodo principale per scegliere la directory di un'esecuzione, anche se passare direttamente project=/name= funziona ancora. Vedi addestramento per dataset, augmentation, multi-GPU e logger.
Le nuove esecuzioni usano una directory incrementale runs/train/dinov2_exp con exist_ok=False. resume=True ripristina lo stato del trainer e conserva la directory selezionata. La classificazione supporta cls_pw e class_weights come descritto negli iperparametri.
Validazione
val() restituisce un dizionario di chiavi metrics/: mIoU e accuratezza per
pixel per task="semantic", accuratezza top-1 e top-5 per task="classify".
task="embed" non ha nessun ground truth con cui misurarsi e solleva
NotImplementedError se ci chiami val() sopra.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])La calibrazione per classificazione ed embedding riutilizza la pipeline di classificazione del modello. La valutazione usa la trasformazione della famiglia.
Esportazione
| Task | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX: supportato | Semantic segmentation to TorchScript: supportato | Semantic segmentation to ExecuTorch: supportato | Semantic segmentation to TensorRT: supportato | Semantic segmentation to OpenVINO: supportato | Semantic segmentation to Paddle: non supportato | Semantic segmentation to MNN: non supportato | Semantic segmentation to RKNN: non supportato | Semantic segmentation to ncnn: non supportato | Semantic segmentation to TFLite: non supportato | Semantic segmentation to CoreML: non supportato | Semantic segmentation to Core AI: non supportato |
| Classification | Classification to ONNX: supportato | Classification to TorchScript: supportato | Classification to ExecuTorch: supportato | Classification to TensorRT: supportato | Classification to OpenVINO: supportato | Classification to Paddle: non supportato | Classification to MNN: non supportato | Classification to RKNN: non supportato | Classification to ncnn: non supportato | Classification to TFLite: non supportato | Classification to CoreML: non supportato | Classification to Core AI: supportato |
| Embeddings | Embeddings to ONNX: supportato | Embeddings to TorchScript: supportato | Embeddings to ExecuTorch: supportato | Embeddings to TensorRT: supportato | Embeddings to OpenVINO: supportato | Embeddings to Paddle: non supportato | Embeddings to MNN: non supportato | Embeddings to RKNN: non supportato | Embeddings to ncnn: non supportato | Embeddings to TFLite: supportato | Embeddings to CoreML: non supportato | Embeddings to Core AI: non supportato |
Ogni task supporta un sottoinsieme diverso di formati, mostrato qui sopra. Un
artefatto esportato si ricarica tramite LibreYOLO() in base al suffisso del
file, quindi un file .onnx o .engine si comporta come un checkpoint e
restituisce gli stessi Results. Esportazione elenca gli
argomenti che ogni formato accetta.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # La factory smista in base al suffisso del file, quindi un artefatto# esportato si carica come qualsiasi checkpoint e restituisce lo stesso# oggetto Results. L'esportazione dà il nome al file a partire dal# task, qui LibreDINOv2s-sem.onnx.model = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)Licenze
Controlla la licenza nel repository Hugging Face degli specifici pesi che scarichi. Ogni checkpoint nell<link>organizzazione LibreYOLO</link> ne include una e non è sempre la stessa per tutta la famiglia. Quel repository è la fonte autorevole; il riepilogo seguente descrive le condizioni applicabili al momento dellultima verifica di questa pagina.
Questa è una descrizione delle licenze coinvolte, non una consulenza legale. Se la risposta è importante a fini commerciali, leggi personalmente le licenze e chiedi una consulenza indipendente.
- Lavoro originale
- DINOv2, Meta AI (FAIR)
- Licenza upstream
- Apache-2.0
- Sorgente upstream
- github.com/facebookresearch/dinov2
- Codice LibreYOLO
- MIT
- Pesi
- Apache-2.0, distribuiti dai rispettivi autori. LibreYOLO non li ospita né ne mantiene una copia.
- Interpretazione
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
La riga "Pesi" qui sopra indica la licenza che si applica, Apache-2.0, ma per
questa famiglia non viene ripubblicato niente sotto l'org Hugging Face di
LibreYOLO: LibreYOLO non ospita nessun checkpoint LibreDINOv2 proprio. Quello
che LibreDINOv2(model_path=None) scarica è il repository
facebook/dinov2-with-registers-small di Meta, intatto.
Citazione
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
Copiato dal blocco di citazione degli autori disponibile su github.com/facebookresearch/dinov2#citing-dinov2.