MiDaS
MiDaS è la stima della profondità relativa monoculare addestrata con una loss invariante a scala e shift su dataset misti, la linea di lavoro che ha definito il protocollo di trasferimento zero-shot della profondità che le famiglie successive riutilizzano. LibreYOLO lo supporta per il task depth: predizione e validazione zero-shot, senza percorso di addestramento.
- Task
- depth
- Dimensioni
- s, l at 256 to 384 px
- Installa
pip install "libreyolo[midas]"- Livello di supporto
- Solo inferenza, dalla v1.5.0. Solo predizione, validazione ed esportazione. Le funzionalità di addestramento non si applicano.
- Licenze
- Codice MIT, pesi MIT. Uso commerciale
Installazione
MiDaS richiede l'extra midas per i suoi encoder timm.
pip install "libreyolo[midas]"Predizione
I checkpoint s e l vengono scaricati dai mirror di LibreYOLO con la licenza MIT del distributore e memorizzati nella cache locale.
from libreyolo import LibreYOLO, SAMPLE_IMAGE # Scarica il checkpoint dal mirror al primo utilizzo.model = LibreYOLO("LibreMiDaSl-depth.pt")result = model(SAMPLE_IMAGE, save=True) depth = result.depth_mapprint(depth.min, depth.max, depth.mean)libreyolo predict model=LibreMiDaSl-depth.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Encoder EfficientNet-Lite3, più piccolo e veloce della dimensione l DPT-Large.model = LibreYOLO("LibreMiDaSs-depth.pt")result = model(SAMPLE_IMAGE, save=True)result.depth_map contiene una mappa densa di profondità inversa relativa: valori più alti indicano una maggiore vicinanza alla camera e non hanno unità metriche né una scala comune tra immagini. save=True salva su disco una visualizzazione della mappa con una scala di colori; Results.plot() visualizza la mappa di profondità. Vedi predizione per sorgenti, streaming e gestione dei risultati.
Varianti
Due varianti con encoder diversi, non semplicemente scale diverse dello stesso
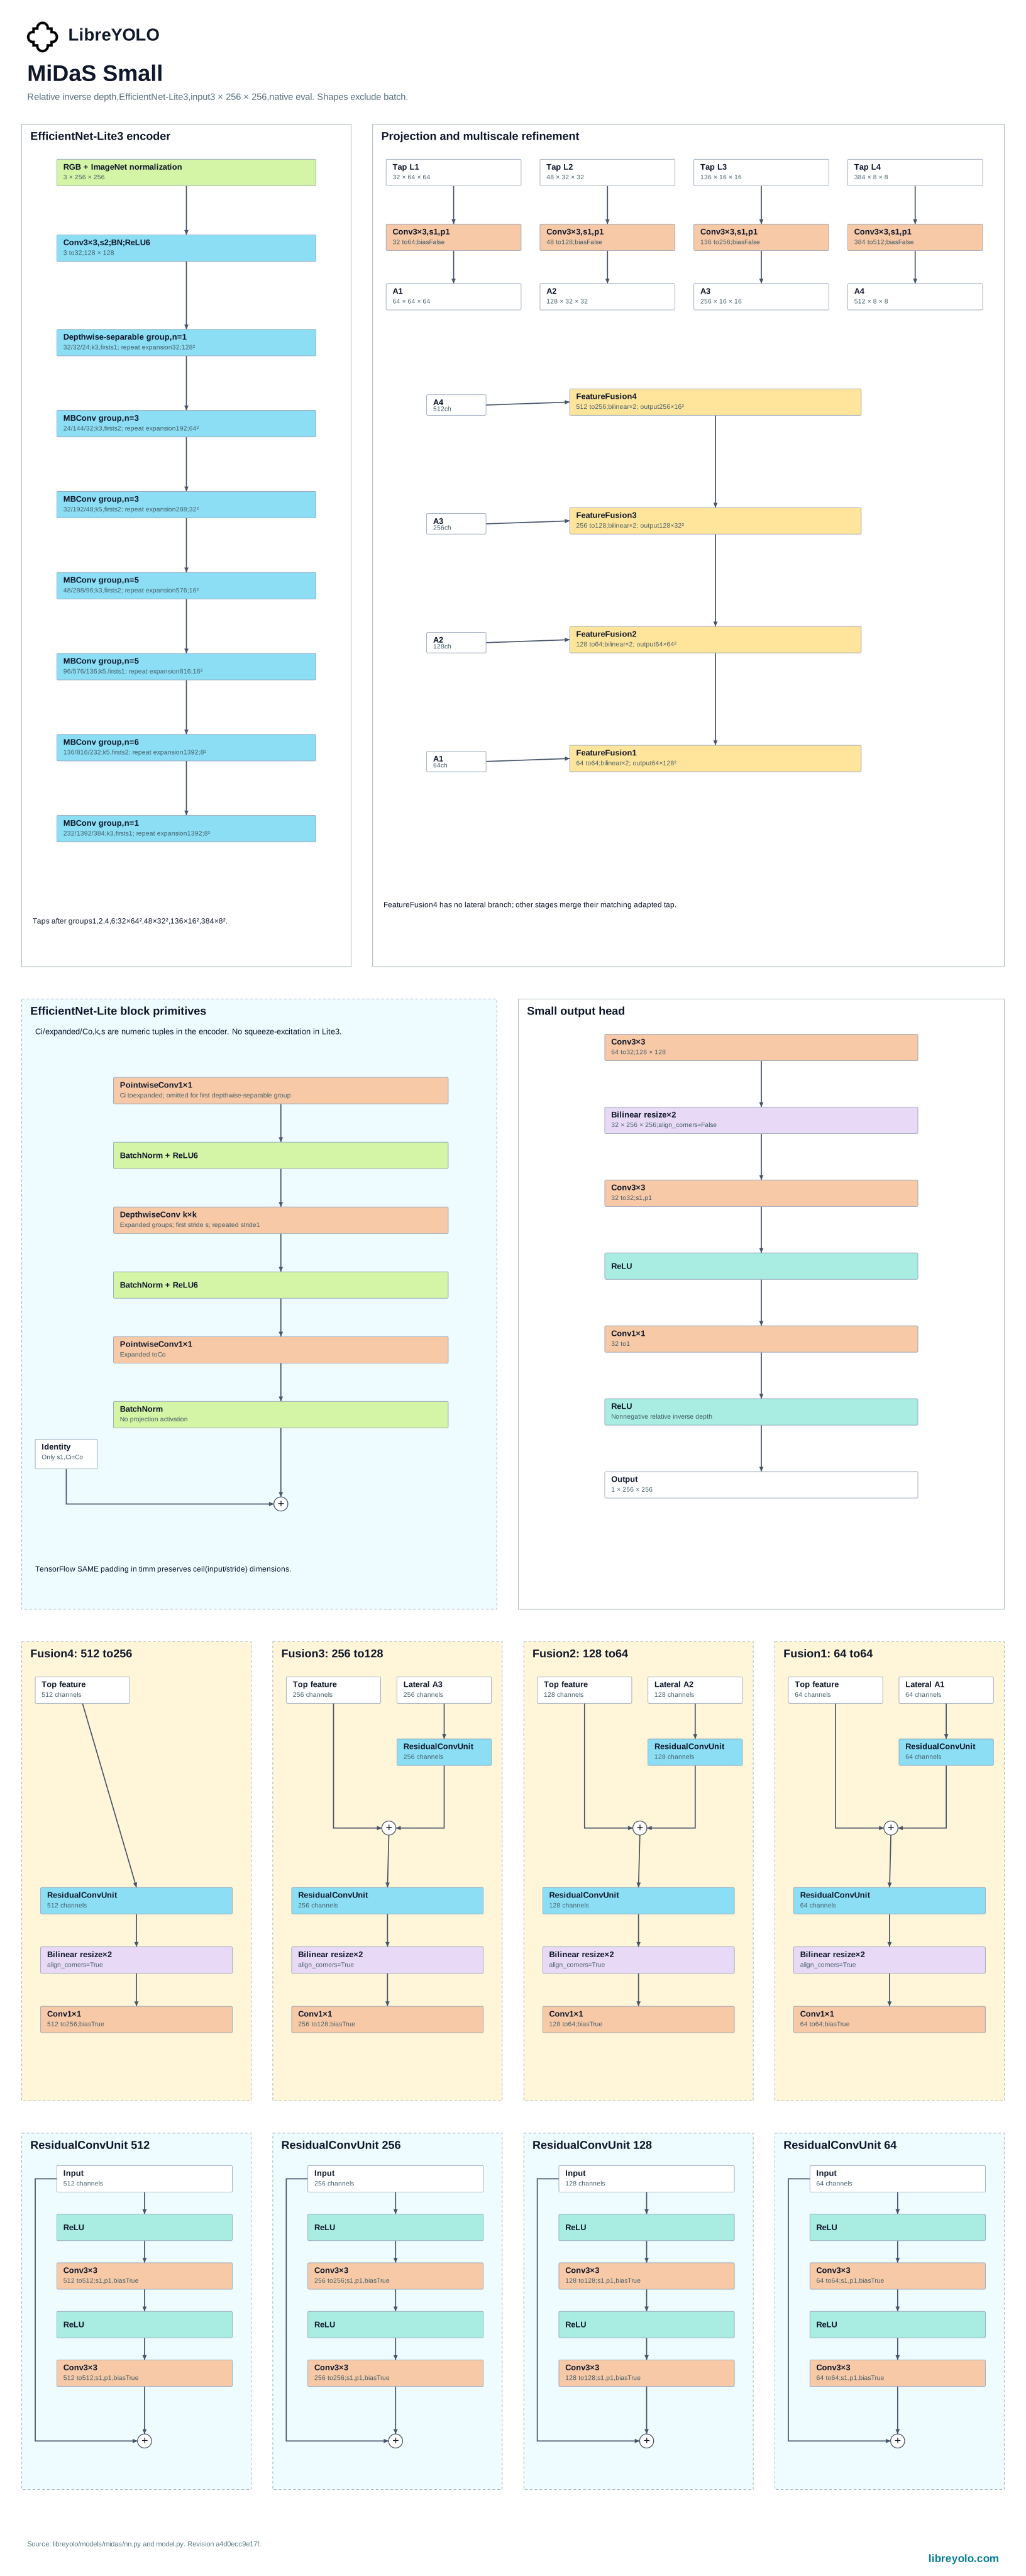
encoder. s è MiDaS v2.1 Small, un encoder EfficientNet-Lite3. l è
DPT-Large, un encoder ViT-L/16 con il decoder DPT che MiDaS ha introdotto per
la predizione densa. Anche il preprocessing è diverso: s usa un
ridimensionamento a proporzioni mantenute con vincolo superiore e
normalizzazione mean/std di ImageNet, l usa un ridimensionamento minimo a
proporzioni mantenute con media e deviazione standard di 0.5. Scegli s per
una CNN più leggera, l per l'accuratezza del decoder transformer.
L'addestramento non è offerto per questa famiglia. LibreMiDaS.train() solleva
sempre NotImplementedError.
Validazione
val() esegue il validatore depth condiviso: allinea ogni predizione al suo
ground truth con una scala e uno shift ai minimi quadrati calcolati per
immagine, poi riporta le metriche standard di profondità relativa zero-shot,
AbsRel, RMSE e le tre soglie delta.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/abs_rel"])print(metrics["metrics/rmse"])print(metrics["metrics/delta1"])libreyolo val model=LibreMiDaSl-depth.pt data=my-dataset.yamlEsportazione
| Task | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Depth | Depth to ONNX: supportato | Depth to TorchScript: supportato | Depth to ExecuTorch: supportato | Depth to TensorRT: supportato | Depth to OpenVINO: supportato | Depth to Paddle: non supportato | Depth to MNN: non supportato | Depth to RKNN: non supportato | Depth to ncnn: supportato | Depth to TFLite: non supportato | Depth to CoreML: non supportato | Depth to Core AI: non supportato |
Un artefatto esportato si ricarica con LibreYOLO() in base al suffisso del
file, quindi un file .onnx o .engine si comporta come un checkpoint e
restituisce lo stesso Results, con depth_map al posto dei box.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreMiDaSl-depth.pt format=onnxlibreyolo export model=LibreMiDaSl-depth.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # La factory sceglie in base al suffisso del file, quindi un artefatto# esportato si carica come un qualsiasi checkpoint e restituisce lo# stesso oggetto Results.model = LibreYOLO("LibreMiDaSl-depth.onnx")result = model(SAMPLE_IMAGE) print(result.depth_map.data.shape)Licenze
Controlla la licenza nel repository Hugging Face degli specifici pesi che scarichi. Ogni checkpoint nell<link>organizzazione LibreYOLO</link> ne include una e non è sempre la stessa per tutta la famiglia. Quel repository è la fonte autorevole; il riepilogo seguente descrive le condizioni applicabili al momento dellultima verifica di questa pagina.
Questa è una descrizione delle licenze coinvolte, non una consulenza legale. Se la risposta è importante a fini commerciali, leggi personalmente le licenze e chiedi una consulenza indipendente.
- Lavoro originale
- MiDaS, Intel Intelligent Systems Lab (Intel ISL)
- Licenza upstream
- MIT
- Sorgente upstream
- github.com/isl-org/MiDaS
- Codice LibreYOLO
- MIT
- Pesi
- MIT, ripubblicati su huggingface.co/LibreYOLO
- Interpretazione
- The upstream repository and released weights declare MIT. LibreYOLO mirrors the s and l checkpoints under that publisher grant.
Citazione
@ARTICLE {Ranftl2022,
    author  = "Ren\'{e} Ranftl and Katrin Lasinger and David Hafner and Konrad Schindler and Vladlen Koltun",
    title   = "Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-Shot Cross-Dataset Transfer",
    journal = "IEEE Transactions on Pattern Analysis and Machine Intelligence",
    year    = "2022",
    volume  = "44",
    number  = "3"
}

@article{Ranftl2021,
	author    = {Ren\'{e} Ranftl and Alexey Bochkovskiy and Vladlen Koltun},
	title     = {Vision Transformers for Dense Prediction},
	journal   = {ICCV},
	year      = {2021},
}
Copiato dal blocco di citazione degli autori disponibile su github.com/isl-org/MiDaS#citation.