YOLOv9
Un rilevatore convoluzionale a singolo stadio: una sola passata assegna un punteggio a una griglia densa di box e NMS scarta i duplicati. LibreYOLO ne porta tre varianti, una delle quali senza passaggio di NMS.
- Task
- detection
- Dimensioni
- yolo9: t, s, m, c at 640 px; yolo9_p2: t, s at 640 px
- Installa
pip install libreyolo- Livello di supporto
- Di punta, dalla v1.0.0. Le funzionalità vengono progettate e convalidate completamente su GPU prima per questo livello.
- Licenze
- Codice MIT, pesi MIT. Uso commerciale
Installazione
YOLOv9 non richiede nessun extra oltre al pacchetto base.
pip install libreyoloPredizione
I pesi vengono scaricati da Hugging Face al primo utilizzo e restano nella cache locale.
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreYOLO9s.pt")result = model(SAMPLE_IMAGE, save=True) for box in result.boxes: print(box.cls, box.conf, box.xyxy)libreyolo predict model=LibreYOLO9s.pt save=True \ source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpgfrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Stessa chiamata, checkpoint diverso. La testa end-to-end restituisce# le sue predizioni migliori, quindi non viene eseguito NMS e iou è ignorato.model = LibreYOLO("LibreYOLO9E2Es.pt")result = model(SAMPLE_IMAGE, conf=0.25, max_det=300) print(len(result.boxes))L'oggetto Results restituito è quello che restituisce ogni famiglia, quindi
passare a un rilevatore diverso è una modifica di una riga. Sul modello base e
su quello stride 4, conf fissa la soglia di confidenza e iou la soglia di
NMS. Il modello end-to-end non esegue NMS e ignora iou, quindi sono conf e
max_det a dare forma al suo output. Vedi predizione per
sorgenti, streaming e gestione dei risultati.
Varianti
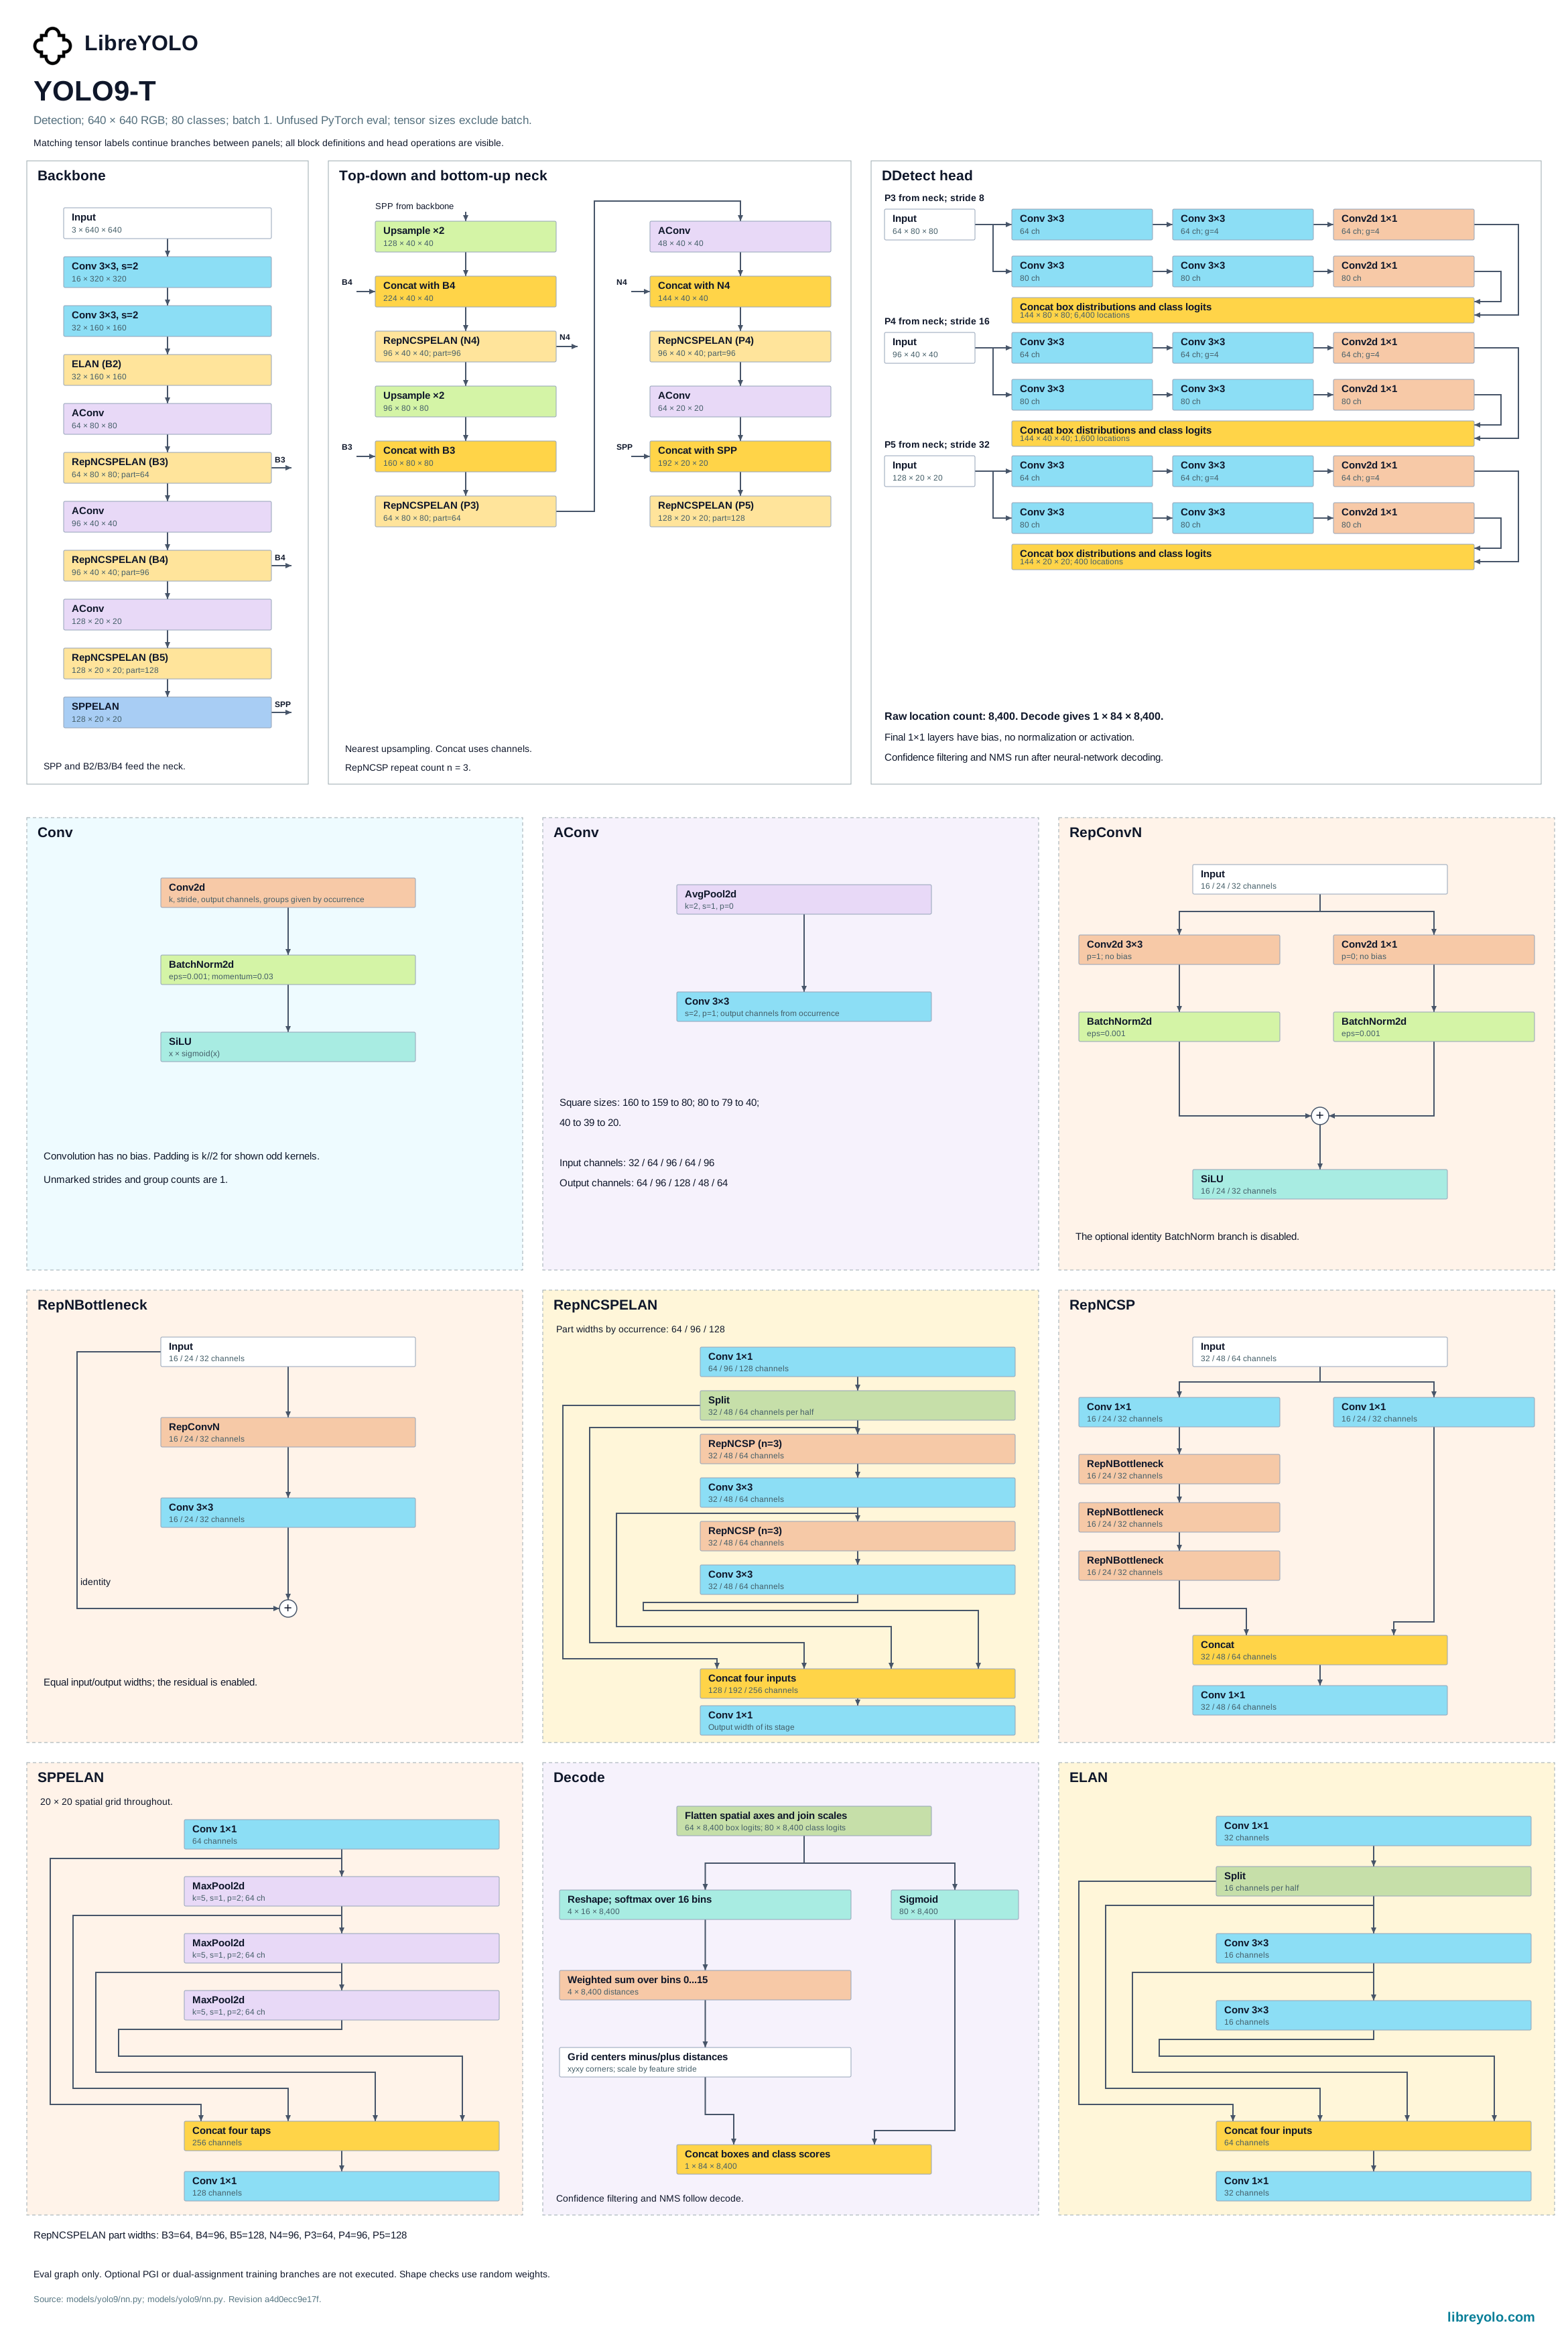
Tre varianti condividono un backbone. Tutte e tre fanno solo rilevamento, e accettano gli stessi argomenti.
Il modello base predice su tre scale di feature ed elimina i bounding box duplicati con NMS.
Il modello end-to-end mantiene quella testa e le affianca un ramo di matching uno-a-uno. L'inferenza legge soltanto il ramo uno-a-uno e ne prende le predizioni con il punteggio più alto, quindi non viene eseguito nessun NMS. Scegli questo quando il runtime su cui metti in produzione non ha un operatore NMS.
Il modello stride 4 fa affiorare un livello più in alto nel backbone, estende il neck fino a lì e predice su quattro scale invece che tre. La scala in più serve per gli oggetti che coprono pochi pixel; l'unico checkpoint pubblicato per questo modello è addestrato su immagini aeree. I checkpoint di rilevamento base si trasferiscono su di esso: il backbone e il neck si caricano invariati, le tre torri della testa preaddestrate salgono di una posizione e la torre stride 4 parte da un'inizializzazione casuale.
| Checkpoint | Ingresso (px) | mAP 50-95 | Parametri (M) |
|---|---|---|---|
| LibreYOLO9c | 640 | 56.4 | 25.5 |
| LibreYOLO9m | 640 | 55.3 | 20.12 |
| LibreYOLO9s | 640 | 55.9 | 7.2 |
| LibreYOLO9t | 640 | 41.8 | 2.04 |
COCO val2017, 500 images. Misurato con il sistema di benchmark di LibreYOLO e pubblicato su Vision Analysis, dove vengono confrontate le latenze tra hardware e runtime e sono disponibili i record completi delle esecuzioni.
Addestramento
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.train(data="my-dataset.yaml", epochs=100, imgsz=640, batch=16)libreyolo train model=LibreYOLO9s.pt data=my-dataset.yaml \ epochs=100 imgsz=640 batch=16from libreyolo import LibreYOLO9P2 # La variante stride 4 non ha un checkpoint COCO proprio: indicane uno# di rilevamento base, il backbone e il neck si caricano invariati e la# torre della testa stride 4 parte da un'inizializzazione casuale.model = LibreYOLO9P2(None, size="s")model.train(data="my-dataset.yaml", epochs=100, pretrained="LibreYOLO9s.pt")pretrained decide da cosa parte l'esecuzione. Passa True per caricare il
checkpoint pubblicato dello stesso modello e della stessa dimensione, oppure un
nome o un percorso per qualsiasi altra cosa. I tensori la cui forma non coincide
vengono saltati invece che rifiutati, e l'esecuzione registra quanti ne sono
stati caricati, quindi un checkpoint addestrato su un numero di classi diverso
resta un punto di partenza utilizzabile.
Il modello stride 4 non ha un checkpoint COCO pubblicato proprio, quindi lì
True si risolve in un file che non esiste e il download fallisce. Indica
invece un checkpoint di rilevamento base.
Vedi addestramento per dataset, data augmentation, multi-GPU e logger.
Il modello base può addestrare un ramo ausiliario PGI accanto alla sua testa
principale. Il ramo è usato solo nell'addestramento: predizione ed esportazione
usano la testa principale. Un'esecuzione lo collega quando i pesi di partenza
contengono tensori PGI o quando parte da zero. I checkpoint base pubblicati non
ne contengono, quindi un fine-tuning da essi addestra solo la testa principale e
lo registra nel log. aux_weight=0.25 collega comunque un nuovo ramo con quel
peso di loss, e aux_weight=0 lo tiene spento. Un'esecuzione ripresa mantiene la
configurazione PGI del suo checkpoint. Sulle taglie m e c il ramo è quello
upstream: un secondo backbone sull'immagine di input, i cui stadi CBFuse somma
con le derivazioni CBLinear del backbone principale, e una propria testa, con
12.8M e 25.7M di parametri usati solo nell'addestramento a 80 classi. I modelli
end-to-end e a stride 4 non hanno nessun ramo PGI.
Tutte e tre le varianti limitano la norma L2 del gradiente a 10 prima di ogni
passo dell'ottimizzatore; clip_max_norm=0 disattiva il clipping.
L'assegnazione delle etichette valuta gli anchor in fp32, anche sotto autocast
float16. max_labels=300 limita i box mantenuti per ogni immagine di
addestramento, e i box oltre il limite vengono scartati con un avviso unico; la
memoria dell'assegnazione segue i box reali di ciascuna immagine, non il limite.
Il momentum SGD sale da 0.8 a 0.937 durante le prime tre epoche.
letterbox_pad=None eredita il valore registrato nel checkpoint: i pesi senza
indicazione usano topleft, mentre le nuove conversioni ufficiali registrano
center.
Il mosaic di YOLO9 e YOLOX preferisce immagini associate con annotazioni, con un massimo di 20 estrazioni; MixUp di YOLO9 usa la stessa regola. MixUp è disattivato di default (mixup_prob=0). Quando è attivo, il rapporto di miscelazione è estratto da Beta(1, 1), uniforme su [0, 1], come in MultimediaTechLab/YOLO. Vedi gli istogrammi di eventi per i profili di input non RGB.
Validazione
val() restituisce un dizionario di chiavi metrics/ che coprono precisione,
recall, mAP 50 e mAP 50-95, misurate su qualsiasi dataset nel formato con cui
hai addestrato.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mAP50-95"])print(metrics["metrics/mAP50"])libreyolo val model=LibreYOLO9s.pt data=my-dataset.yaml# Il file yaml di COCO incluso porta uno script di download integrato,# quindi serve un permesso esplicito a meno che il dataset non sia già in locale.libreyolo val model=LibreYOLO9c.pt data=coco.yaml imgsz=640 \ allow_download_scripts=TrueEsportazione
| Task | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Detection | Detection to ONNX: supportato | Detection to TorchScript: supportato | Detection to ExecuTorch: supportato | Detection to TensorRT: supportato | Detection to OpenVINO: supportato | Detection to Paddle: supportato | Detection to MNN: supportato | Detection to RKNN: non supportato | Detection to ncnn: supportato | Detection to TFLite: non supportato | Detection to CoreML: non supportato | Detection to Core AI: supportato |
Una spunta vale per tutte e tre le varianti: dove differiscono, la matrice riporta la più debole delle tre.
Un artefatto esportato si ricarica con LibreYOLO() in base al suffisso del
file, quindi un file .onnx o .engine si comporta come un checkpoint e
restituisce lo stesso Results. Eseguire il grafo in un runtime nudo, senza
LibreYOLO installato, è supportato anche questo, ma allora il preprocessing e il
postprocessing tocca scriverli a te.
Per il modello di rilevamento base, la metà di postprocessing può spostarsi
dentro il grafo. nms=True su un'esportazione ONNX mette la soppressione dentro
il modello, e il primo output diventa un tensore fisso (1, max_det, 6) le cui
righe sono x1, y1, x2, y2, score, class, riempite di zeri oltre il numero di
rilevamenti. Quel grafo è a batch 1 e non porta assi dinamici. I modelli
end-to-end e stride 4 non accettano il flag.
Ogni formato installa un extra diverso e accetta qualche argomento suo. Entrambe le cose stanno nella pagina di quel formato.
from libreyolo import LibreYOLO model = LibreYOLO("LibreYOLO9s.pt")model.export(format="onnx", imgsz=640)libreyolo export model=LibreYOLO9s.pt format=onnx imgsz=640libreyolo export model=LibreYOLO9s.pt format=onnx nms=True \ conf=0.25 iou=0.45 max_det=300from libreyolo import LibreYOLO, SAMPLE_IMAGE # La factory smista in base al suffisso del file, quindi un artefatto# esportato si carica come qualsiasi checkpoint e restituisce lo stesso Results.model = LibreYOLO("LibreYOLO9s.onnx")result = model(SAMPLE_IMAGE) print(result.boxes.xyxy)TFLite INT8 usa int8=True con dati di calibrazione.
Input e output ONNX
LibreYOLO9
| Tensore | images float32 [batch, 3, height, width] |
|---|---|
| Colore | RGB |
| Scala | pixel / 255 |
| Normalizzazione | nessuna |
| Ridimensionamento | letterbox, bilinear, valore di riempimento 114, posizione del riempimento dalla chiave di metadati letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
Detection, esportazione predefinita
| Output | Forma | Significato |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Post-elaborazione
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Detection, nms=True
| Output | Forma | Significato |
|---|---|---|
output | [1, max_det, 6] | Rows are x1, y1, x2, y2, score, class in input-canvas pixels, zero-padded past the detection count. Confidence, IoU and max_det are baked in and recorded as nms_conf, nms_iou and max_det metadata. |
raw | [1, 4 + nc, anchors] | The same tensor as the default export's output, before suppression. |
Post-elaborazione
- Drop rows whose score is 0 or below your threshold.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
LibreYOLO9E2E
| Tensore | images float32 [batch, 3, height, width] |
|---|---|
| Colore | RGB |
| Scala | pixel / 255 |
| Normalizzazione | nessuna |
| Ridimensionamento | letterbox, bilinear, valore di riempimento 114, posizione del riempimento dalla chiave di metadati letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, esportazione predefinita
| Output | Forma | Significato |
|---|---|---|
output | [batch, 4 + nc, anchors] | Predictions of the one-to-one head only. Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 8, 16 and 32, 8400 at 640 x 640. |
Post-elaborazione
- Transpose to [anchors, 4 + nc].
- Flatten the [anchors, nc] scores into one list of anchors x nc (anchor, class) pairs. Pair i belongs to anchor i / nc (integer division) and class i % nc.
- Keep the 300 highest-scoring pairs (max_det), highest first. One anchor can yield several classes.
- Of those, keep the pairs whose score is above the confidence threshold (0.25 by default).
- Do not run NMS. The one-to-one head is trained to fire once per object, and LibreYOLO ignores the iou setting for this model.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
LibreYOLO9P2
| Tensore | images float32 [batch, 3, height, width] |
|---|---|
| Colore | RGB |
| Scala | pixel / 255 |
| Normalizzazione | nessuna |
| Ridimensionamento | letterbox, bilinear, valore di riempimento 114, posizione del riempimento dalla chiave di metadati letterbox_pad |
Scale by r = min(height / h, width / w), resize to (int(w * r), int(h * r)) and paste onto a canvas filled with 114.
Paste position comes from the letterbox_pad metadata key: topleft puts the image in the top-left corner, center splits the padding on both sides. A missing key means topleft.
This model has no nms=True export. The exporter raises NotImplementedError, so only the default export below exists.
Detection, esportazione predefinita
| Output | Forma | Significato |
|---|---|---|
output | [batch, 4 + nc, anchors] | Rows 0 to 3 are x1, y1, x2, y2 in input-canvas pixels. Rows 4 onward are per-class scores, sigmoid already applied. anchors is the cell count over strides 4, 8, 16 and 32, 34000 at 640 x 640. nc is 10 for LibreYOLO9P2s-visdrone. |
Post-elaborazione
- Transpose to [anchors, 4 + nc].
- Keep every (anchor, class) pair whose score is above the confidence threshold (0.25 by default). One anchor can yield several classes.
- Run NMS per class with IoU 0.45 and keep at most 300 detections.
- Map boxes back to the original image: subtract the pad offset, divide by r, clip to the image.
- Drop boxes whose width or height is 0 after clipping.
Per verificare la tua implementazione, passa lo stesso file a LibreYOLO: LibreYOLO("model.onnx").predict("image.jpg") restituisce i risultati di riferimento. Verificato con LibreYOLO 1.7.0.
Checkpoint
Tutti i file di pesi pubblicati per questa famiglia.
| File | Ingresso (px) | Licenza dei pesi |
|---|---|---|
| Detection | ||
| LibreYOLO9t.pt | 640 | mit |
| LibreYOLO9s.pt | 640 | mit |
| LibreYOLO9m.pt | 640 | mit |
| LibreYOLO9c.pt | 640 | mit |
| LibreYOLO9E2Et.pt | 640 | mit |
| LibreYOLO9E2Es.pt | 640 | mit |
| LibreYOLO9E2Em.pt | 640 | mit |
| LibreYOLO9E2Ec.pt | 640 | mit |
| LibreYOLO9P2s-visdrone.pt | cc-by-nc-sa-3.0 | |
Oggi tutti i file elencati sopra sono presenti nell<link>organizzazione LibreYOLO</link> e vengono scaricati al primo utilizzo.
Licenze
Controlla la licenza nel repository Hugging Face degli specifici pesi che scarichi. Ogni checkpoint nell<link>organizzazione LibreYOLO</link> ne include una e non è sempre la stessa per tutta la famiglia. Quel repository è la fonte autorevole; il riepilogo seguente descrive le condizioni applicabili al momento dellultima verifica di questa pagina.
Questa è una descrizione delle licenze coinvolte, non una consulenza legale. Se la risposta è importante a fini commerciali, leggi personalmente le licenze e chiedi una consulenza indipendente.
- Lavoro originale
- YOLOv9, MultimediaTechLab
- Licenza upstream
- MIT
- Sorgente upstream
- github.com/MultimediaTechLab/YOLO
- Codice LibreYOLO
- MIT
- Pesi
- MIT, ripubblicati su huggingface.co/LibreYOLO
- Interpretazione
- MIT is a permissive license, so these weights can be used in commercial and closed-source products. The one standing obligation is to keep the license text and the copyright notice, Kin-Yiu Wong and Hao-Tang Tsui, with any copy you redistribute. It places no condition on your own application code, and a model you train yourself on your own data is yours. Two things are worth knowing beyond that. The code is ported from the authors' MIT re-release of YOLOv9, MultimediaTechLab/YOLO at commit c4cb5f6f, not the GPL-3.0 repository that carries the same model, so the permissive terms come from the source LibreYOLO actually derives from. And one checkpoint in this family is not MIT: the weight repository of the stride-4 VisDrone model, LibreYOLO9P2s-visdrone.pt, declares CC BY-NC-SA 3.0, which rules out commercial use and requires share-alike on derivatives.
Il codice di tutte e tre le varianti è portato da
MultimediaTechLab/YOLO al commit
c4cb5f6f (MIT). Il predittore uno-a-uno del modello end-to-end segue il design
di DATE di Yiqun Chen (Apache-2.0),
implementato per LibreYOLO senza copiare codice di DATE. Il livello a stride 4 è
codice LibreYOLO.
Il checkpoint aereo con stride 4 predice le classi VisDrone. Usa la licenza dichiarata dal distributore e registrata nel repository dei pesi.
Citazione
@inproceedings{wang2024yolov9,
      title={{YOLOv9}: Learning What You Want to Learn Using Programmable Gradient Information},
      author={Wang, Chien-Yao and Yeh, I-Hau and Liao, Hong-Yuan Mark},
      year={2024},
      booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
}
Copiato dal blocco di citazione degli autori disponibile su github.com/MultimediaTechLab/YOLO#citations.