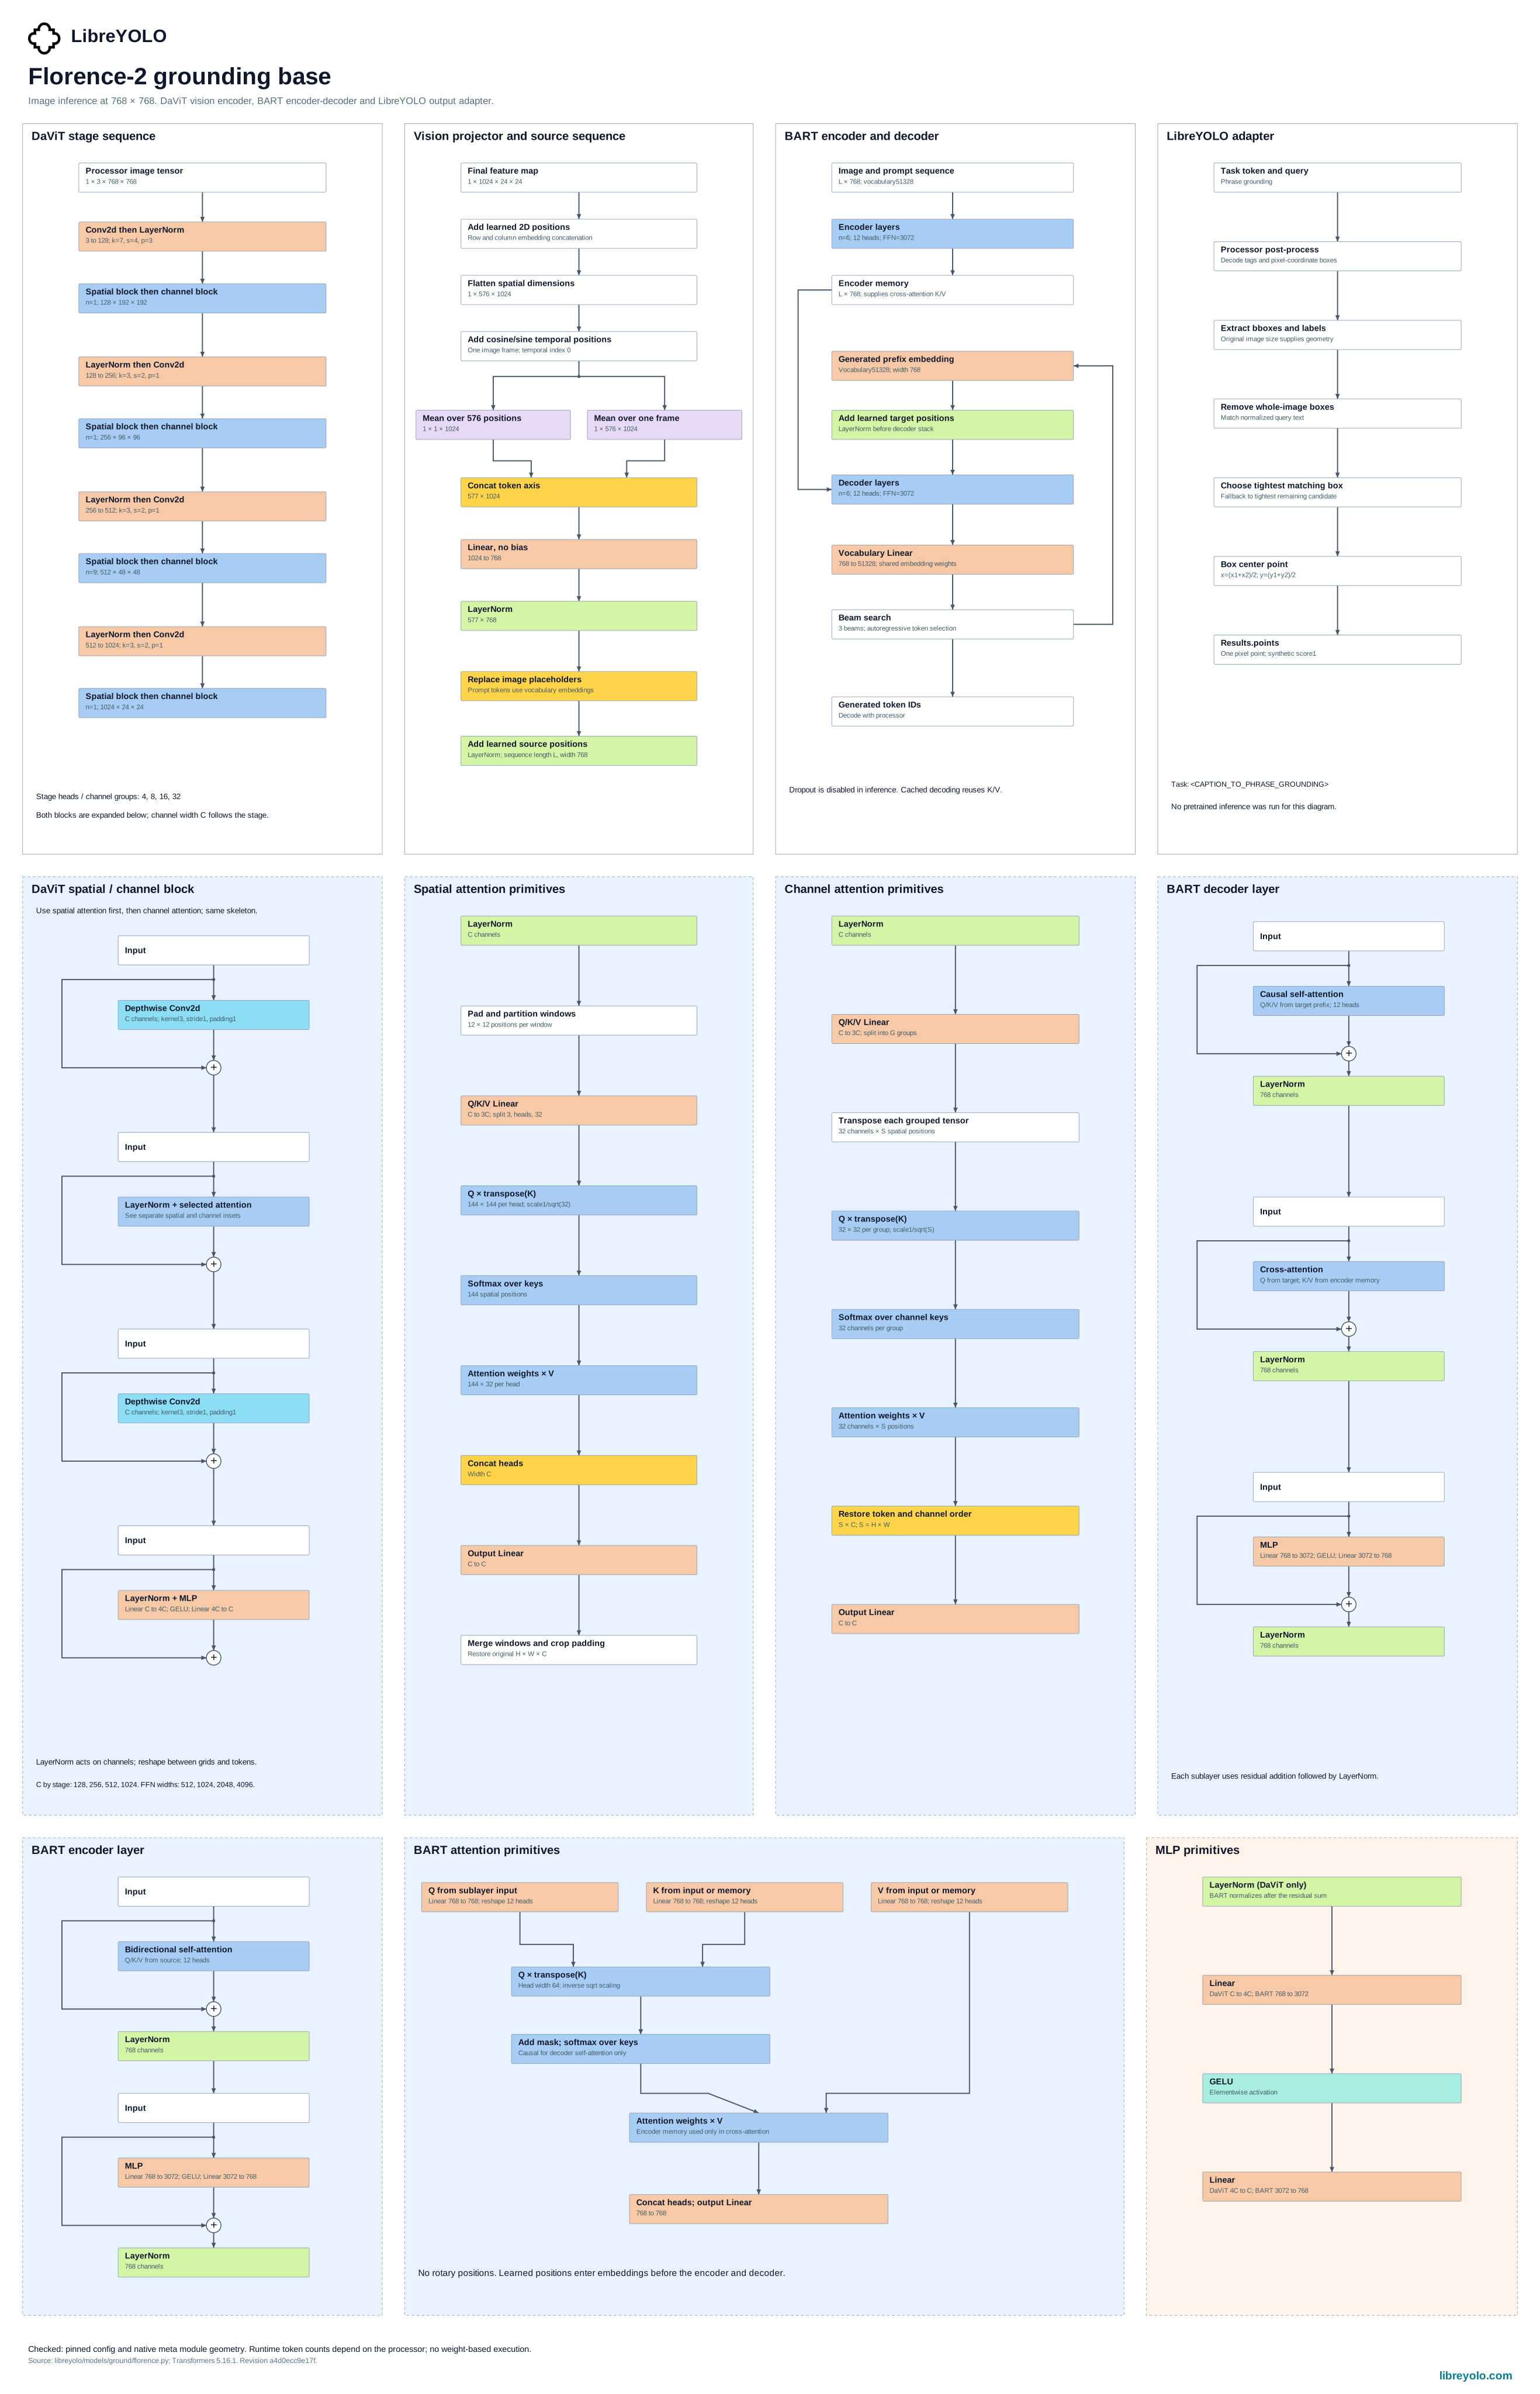
Florence-2グラウンディング
Florence-2グラウンディングは、指示の対象を画像上の点として特定します。
- タスク
- point detection
- サイズ
- base, large at 768 px
- インストール
pip install "libreyolo[vlm]"- サポートティア
- 姉妹ティア、v1.6.0以降。独自のファクトリと契約を持つ、独立した製品インターフェースです。
- ライセンス
- コード:MIT、重み:MIT。商用利用
インストール
bash
pip install "libreyolo[ground]"推論
Python
from libreyolo import LibreGround, SAMPLE_IMAGE model = LibreGround("florence-2-base", device="cpu")result = model(SAMPLE_IMAGE, prompt="the person")print(result.points.xy)1回の呼び出しにはprompt=またはquery=を使い、指示を保持するにはset_query()を使ってください。1枚の画像に複数の指示を渡すと、クエリごとに最大1つのクリック位置を返します。画像リストやフォルダーを対象に複数のクエリを渡すと、エラーになります。座標は元の画像を基準とします。学習、検証、エクスポートには対応していません。グラウンディングAPIを参照してください。
ライセンス
ダウンロードする特定の重みについて、Hugging Faceリポジトリのライセンスを確認してください。LibreYOLO orgの各チェックポイントにはライセンスが付与されており、同じファミリー内でも常に同一とは限りません。そのリポジトリが正式な情報源です。以下の概要は、このページを最後に検証した時点で適用されていた内容を示します。
これは関連するライセンスの説明であり、法的助言ではありません。商用上重要な場合は、自分でライセンスを読み、専門家の助言を受けてください。
- 原著作物
- Florence-2, Microsoft
- アップストリームのライセンス
- MIT
- アップストリームのソース
- huggingface.co/microsoft/Florence-2-base
- LibreYOLOのコード
- MIT
- 重み
- MIT、huggingface.co/LibreYOLOで再公開
- 解釈
- The model publisher declares MIT.
引用
@article{xiao2023florence,
  title={Florence-2: Advancing a unified representation for a variety of vision tasks},
  author={Xiao, Bin and Wu, Haiping and Xu, Weijian and Dai, Xiyang and Hu, Houdong and Lu, Yumao and Zeng, Michael and Liu, Ce and Yuan, Lu},
  journal={arXiv preprint arXiv:2311.06242},
  year={2023}
}著者によるhuggingface.co/microsoft/Florence-2-large#bibtexの引用ブロックからコピーしています。