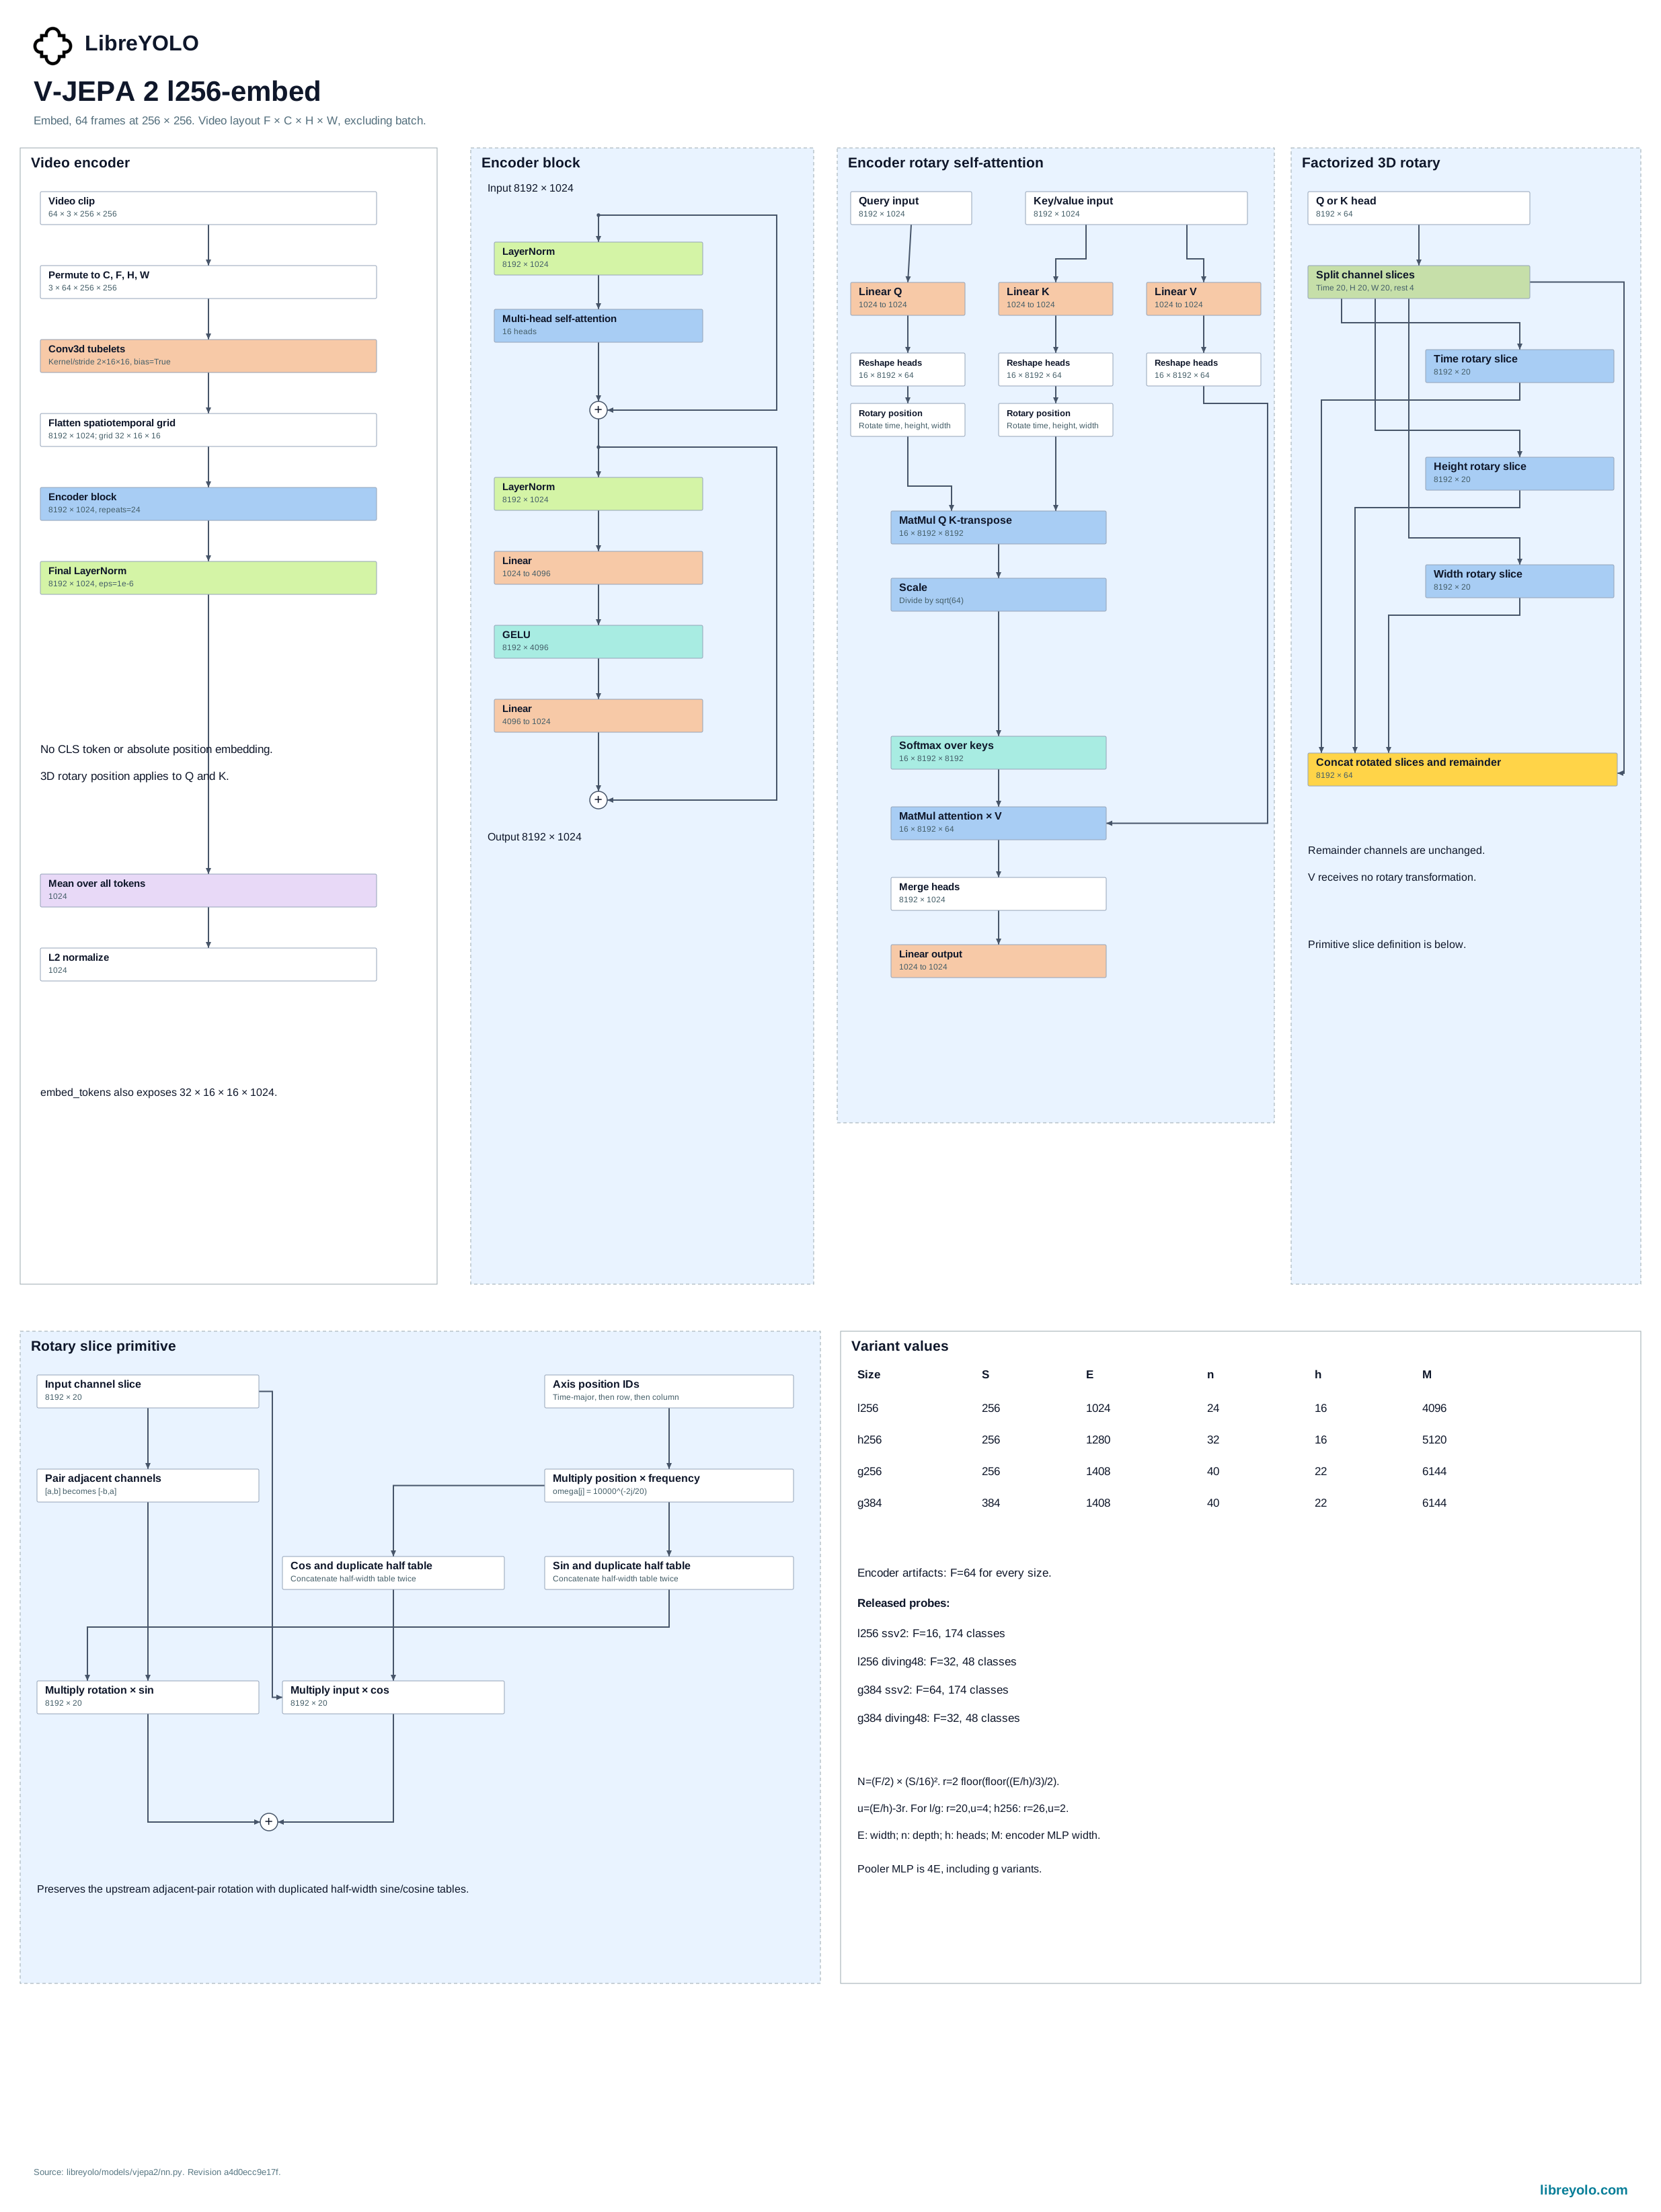
V-JEPA 2
V-JEPA 2は動画の埋め込みベクトルを生成し、アテンションを使う分類プローブの学習に対応します。
- タスク
- embeddings, classification
- サイズ
- l256, h256, g256, g384 at 256 to 384 px
- インストール
pip install libreyolo- サポートティア
- サポート対象、v1.6.0以降。補助的な学習可能モデル:CIで正常な状態を維持し、機能は機会に応じて追加されます。
- ライセンス
- コード:MIT、重み:MIT; Apache-2.0 for giant encoder artifacts。商用利用
インストール
bash
pip install "libreyolo"推論
Python
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreVJEPA2l256-embed.pt", device="cpu")result = model(SAMPLE_IMAGE)print(result.embeddings)tokens = model.embed_tokens(SAMPLE_IMAGE)print(tokens.shape)静止画像はクリップに変換されます。embed_tokens()は(B, T, H, W, D)のトークンを返し、公開APIの埋め込みベクトルはその平均を正規化したものです。エクスポートしたクリップ用グラフには、5次元の入力をランタイムに直接渡す必要があります。
学習
学習するのはアテンションを使うプローブと線形分類器のみで、エンコーダーは凍結したままです。分類タスクと動画マニフェスト形式のデータセットを使ってください。デフォルトは10エポック、バッチサイズ2、学習率0.001、ワーカー数0です。エンコーダー全体のファインチューニングと事前学習には対応していません。
必要な学習データについてはデータセットの設定を参照してください。
Python
from libreyolo import LibreYOLO model = LibreYOLO("LibreVJEPA2l256-cls-ssv2.pt", device="cpu")# 動画データセットの YAML に置き換えてください (train/val マニフェストは '<video-path> <class-id>' 形式の行)model.train(data="path/to/your/video_dataset.yaml", epochs=1, device="cpu", workers=0)検証
Python
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreVJEPA2l256-cls-ssv2.pt", device="cpu")# 動画データセットの YAML に置き換えてください (val() は '<video-path> <class-id>' 形式の val マニフェストを読み込みます)metrics = model.val(data="path/to/your/video_dataset.yaml", workers=0)print(metrics)タスクに対応する形式のデータセットを使います。検証でデータセットの要件と返される指標を説明しています。
エクスポート
| タスク | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Embeddings | Embeddings to ONNX:対応 | Embeddings to TorchScript:対応 | Embeddings to ExecuTorch:対応 | Embeddings to TensorRT:対応 | Embeddings to OpenVINO:対応 | Embeddings to Paddle:非対応 | Embeddings to MNN:非対応 | Embeddings to RKNN:非対応 | Embeddings to ncnn:非対応 | Embeddings to TFLite:非対応 | Embeddings to CoreML:非対応 | Embeddings to Core AI:非対応 |
| Classification | Classification to ONNX:対応 | Classification to TorchScript:対応 | Classification to ExecuTorch:対応 | Classification to TensorRT:対応 | Classification to OpenVINO:対応 | Classification to Paddle:非対応 | Classification to MNN:非対応 | Classification to RKNN:非対応 | Classification to ncnn:非対応 | Classification to TFLite:非対応 | Classification to CoreML:非対応 | Classification to Core AI:非対応 |
Python
from libreyolo import LibreYOLO, SAMPLE_IMAGE model = LibreYOLO("LibreVJEPA2l256-embed.pt", device="cpu")model.export(format="onnx")形式ごとの依存関係とエクスポートしたファイルの読み込みについてはエクスポートの設定を参照してください。
チェックポイント
| ファイル | 重みのライセンス |
|---|---|
| Embeddings | |
| LibreVJEPA2h256-embed.pt | mit |
| LibreVJEPA2l256-embed.pt | mit |
| LibreVJEPA2g384-embed.pt | apache-2.0 |
| LibreVJEPA2g256-embed.pt | apache-2.0 |
| Classification | |
| LibreVJEPA2l256-cls-ssv2.pt | mit |
| LibreVJEPA2l256-cls-diving48.pt | mit |
| LibreVJEPA2g384-cls-diving48.pt | mit |
| LibreVJEPA2g384-cls-ssv2.pt | mit |
上記のすべてのファイルは現在LibreYOLO orgにあり、初回使用時にダウンロードされます。
ライセンス
ダウンロードする特定の重みについて、Hugging Faceリポジトリのライセンスを確認してください。LibreYOLO orgの各チェックポイントにはライセンスが付与されており、同じファミリー内でも常に同一とは限りません。そのリポジトリが正式な情報源です。以下の概要は、このページを最後に検証した時点で適用されていた内容を示します。
これは関連するライセンスの説明であり、法的助言ではありません。商用上重要な場合は、自分でライセンスを読み、専門家の助言を受けてください。
- 原著作物
- V-JEPA 2, Meta AI
- アップストリームのライセンス
- MIT; Apache-2.0 for giant encoder artifacts
- アップストリームのソース
- github.com/facebookresearch/vjepa2
- LibreYOLOのコード
- MIT
- 重み
- MIT; Apache-2.0 for giant encoder artifacts、huggingface.co/LibreYOLOで再公開
- 解釈
- Licenses differ by artifact: the two giant encoder artifacts are Apache-2.0; the other mirrored encoders and classification probes are MIT.