MiDaS
MiDaS виконує монокулярне оцінювання відносної глибини та навчається зі сталою до масштабу й зсуву функцією втрат на змішаних датасетах. Ця лінія досліджень започаткувала протокол перенесення глибини без навчальних прикладів, який повторно використовують пізніші сімейства. LibreYOLO підтримує її для завдання глибини: передбачення та валідація без прикладів без шляху навчання.
- Задачі
- depth
- Розміри
- s, l at 256 to 384 px
- Встановлення
pip install "libreyolo[midas]"- Рівень підтримки
- Лише інференс, починаючи з v1.5.0. Лише передбачення, валідація та експорт. Функції навчання не застосовуються.
- Ліцензії
- Код: MIT, ваги: MIT. Комерційне використання
Встановлення
MiDaS потребує додаткового пакета midas для своїх енкодерів timm.
pip install "libreyolo[midas]"Передбачення
Контрольні точки s і l завантажуються з дзеркал LibreYOLO за дозволом MIT від видавця й кешуються локально.
from libreyolo import LibreYOLO, SAMPLE_IMAGE # Завантажує контрольну точку з дзеркала під час першого використання.model = LibreYOLO("LibreMiDaSl-depth.pt")result = model(SAMPLE_IMAGE, save=True) depth = result.depth_mapprint(depth.min, depth.max, depth.mean)libreyolo predict model=LibreMiDaSl-depth.pt source=https://raw.githubusercontent.com/LibreYOLO/libreyolo/release/libreyolo/assets/parkour.jpg save=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Енкодер EfficientNet-Lite3, менший і швидший за розмір DPT-Large l.model = LibreYOLO("LibreMiDaSs-depth.pt")result = model(SAMPLE_IMAGE, save=True)result.depth_map містить щільну карту відносної оберненої глибини: більші значення означають ближче до камери, а значення не мають метричної одиниці чи спільного масштабу між зображеннями. save=True записує на диск візуалізацію цієї карти з кольоровою шкалою; Results.plot() відображає карту глибини. Типи джерел, потокове передбачення та обробку результатів описано в розділі передбачення.
Варіанти
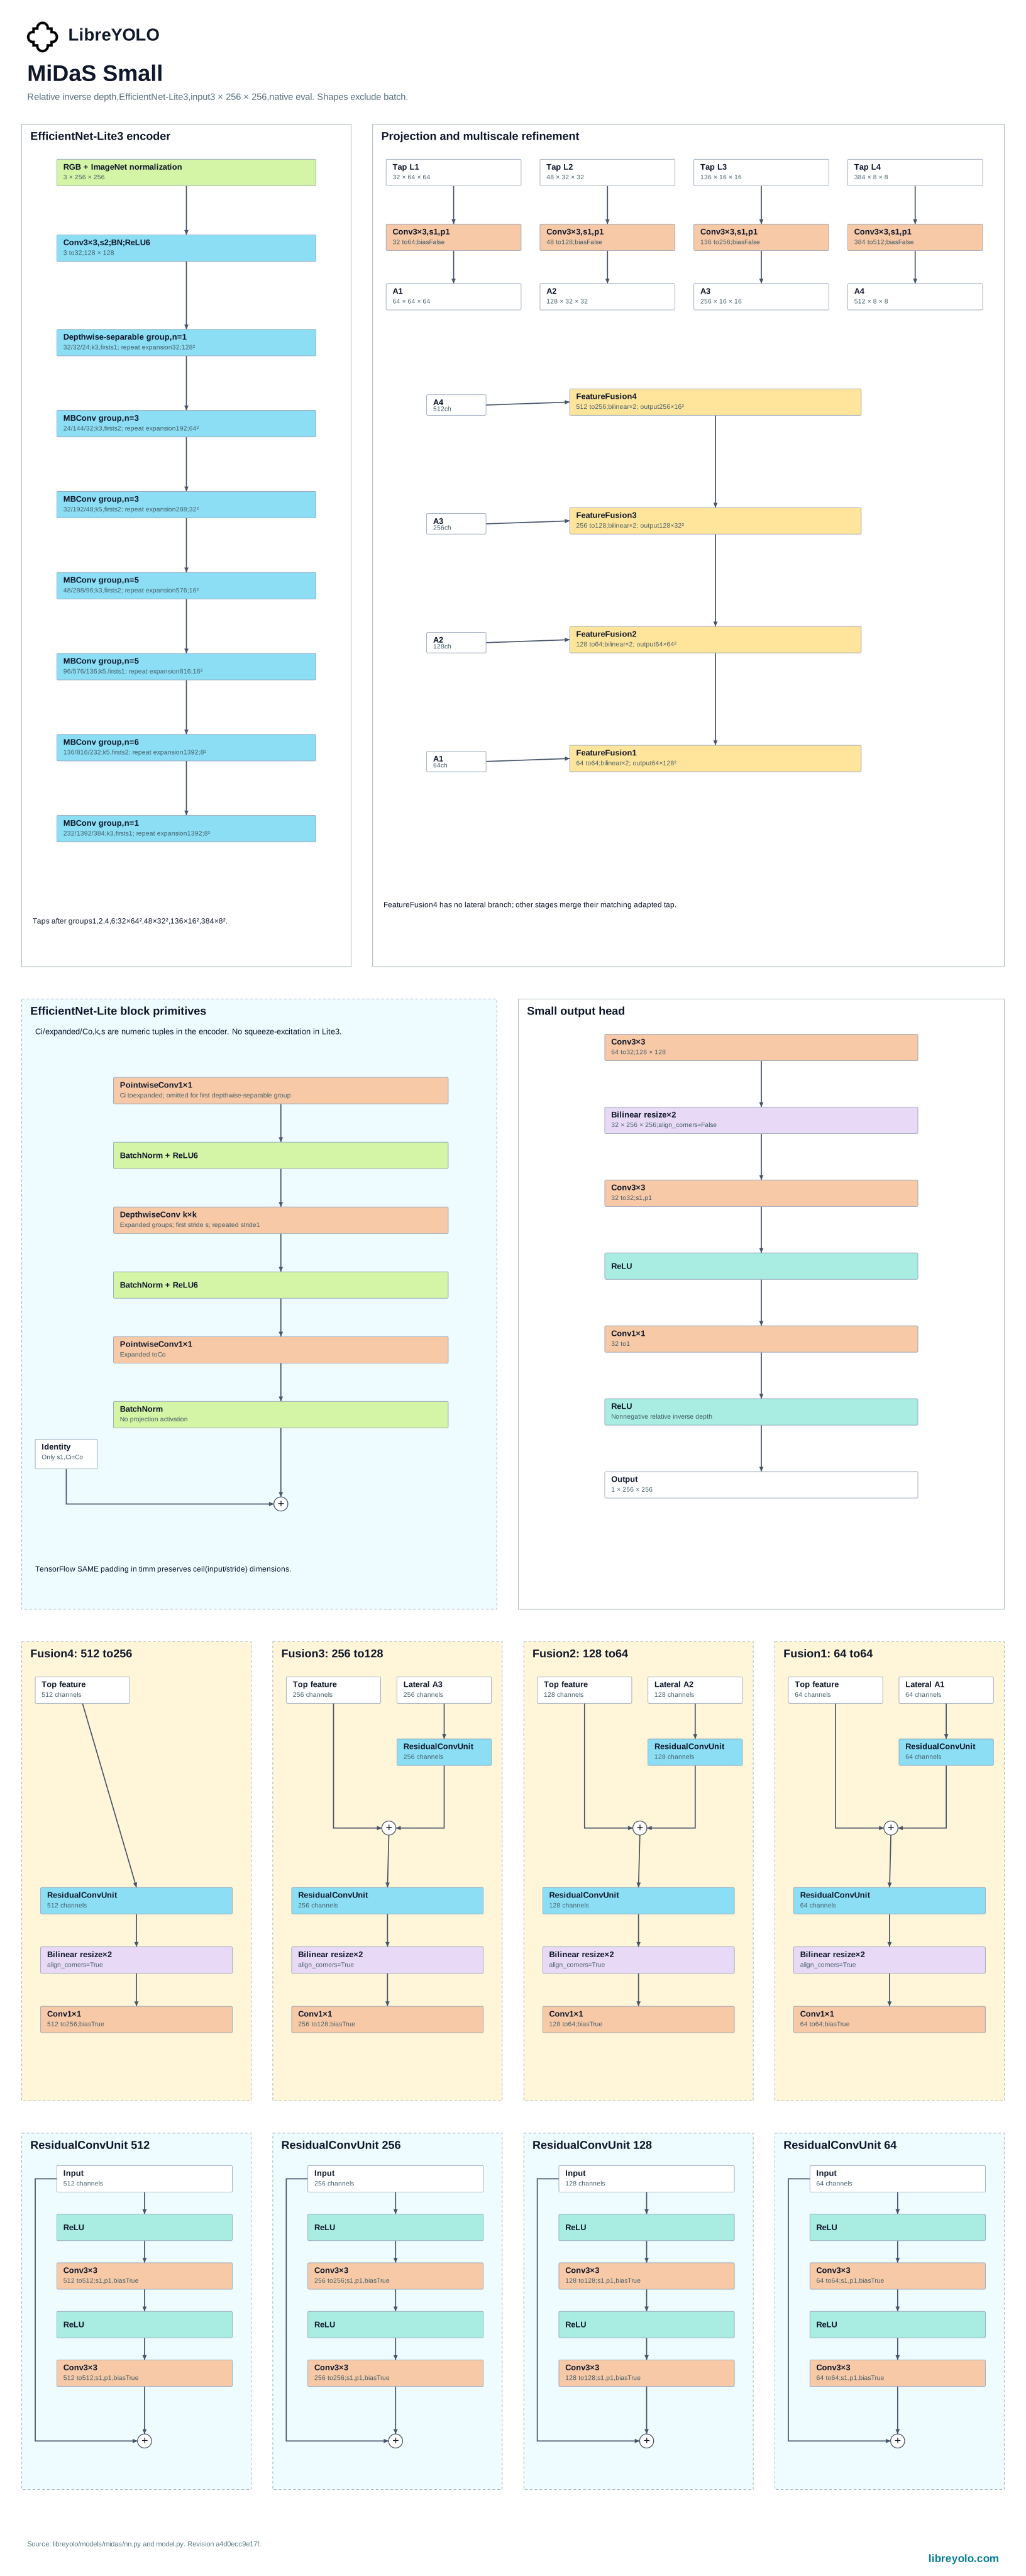
Доступні два варіанти з різними енкодерами, а не просто різними масштабами
одного. s є MiDaS v2.1 Small з енкодером EfficientNet-Lite3. l є
DPT-Large з енкодером ViT-L/16 і декодером DPT, який MiDaS запровадила для
щільного передбачення. Вони також мають різну попередню обробку: s
використовує зміну розміру зі збереженням пропорцій і верхньою межею та
нормалізацію середнім/стандартним відхиленням ImageNet; l використовує
мінімальну зміну розміру зі збереженням пропорцій і середнє та стандартне
відхилення 0.5. Вибирайте s для легшої CNN, а l для правильності
трансформерного декодера.
Навчання для цього сімейства не пропонується. LibreMiDaS.train() завжди
спричиняє NotImplementedError.
Валідація
val() запускає спільний валідатор глибини: він вирівнює кожне передбачення
з еталонними даними за масштабом і зсувом методом найменших квадратів для
кожного зображення, а потім повідомляє стандартні метрики відносної глибини
без навчальних прикладів AbsRel, RMSE і три пороги delta.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/abs_rel"])print(metrics["metrics/rmse"])print(metrics["metrics/delta1"])libreyolo val model=LibreMiDaSl-depth.pt data=my-dataset.yamlЕкспорт
| Задача | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Depth | Depth to ONNX: підтримується | Depth to TorchScript: підтримується | Depth to ExecuTorch: підтримується | Depth to TensorRT: підтримується | Depth to OpenVINO: підтримується | Depth to Paddle: не підтримується | Depth to MNN: не підтримується | Depth to RKNN: не підтримується | Depth to ncnn: підтримується | Depth to TFLite: не підтримується | Depth to CoreML: не підтримується | Depth to Core AI: не підтримується |
Експортований артефакт знову завантажується через LibreYOLO() відповідно до
суфікса файлу, тому файл .onnx або .engine поводиться як контрольна
точка й повертає той самий об'єкт Results із depth_map замість рамок.
from libreyolo import LibreYOLO model = LibreYOLO("LibreMiDaSl-depth.pt")model.export(format="onnx")model.export(format="tensorrt", half=True)libreyolo export model=LibreMiDaSl-depth.pt format=onnxlibreyolo export model=LibreMiDaSl-depth.pt format=tensorrt half=Truefrom libreyolo import LibreYOLO, SAMPLE_IMAGE # Фабрика маршрутизує за суфіксом файлу, тому експортований артефакт# завантажується як будь-яка контрольна точка й повертає той самий об'єкт Results.model = LibreYOLO("LibreMiDaSl-depth.onnx")result = model(SAMPLE_IMAGE) print(result.depth_map.data.shape)Ліцензування
Перевіряйте ліцензію в репозиторії Hugging Face конкретних ваг, які завантажуєте. Кожна контрольна точка в організації LibreYOLO має ліцензію, і вона не завжди однакова для всього сімейства. Цей репозиторій є авторитетним джерелом, а наведене нижче резюме описує умови на момент останньої перевірки сторінки.
Це опис відповідних ліцензій, а не юридична консультація. Якщо відповідь має комерційне значення, самостійно прочитайте ліцензії та зверніться по юридичну консультацію.
- Оригінальна робота
- MiDaS, Intel Intelligent Systems Lab (Intel ISL)
- Ліцензія першоджерела
- MIT
- Джерело першоджерела
- github.com/isl-org/MiDaS
- Код LibreYOLO
- MIT
- Ваги
- MIT, повторно опубліковано на huggingface.co/LibreYOLO
- Тлумачення
- The upstream repository and released weights declare MIT. LibreYOLO mirrors the s and l checkpoints under that publisher grant.
Цитування
@ARTICLE {Ranftl2022,
    author  = "Ren\'{e} Ranftl and Katrin Lasinger and David Hafner and Konrad Schindler and Vladlen Koltun",
    title   = "Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-Shot Cross-Dataset Transfer",
    journal = "IEEE Transactions on Pattern Analysis and Machine Intelligence",
    year    = "2022",
    volume  = "44",
    number  = "3"
}

@article{Ranftl2021,
	author    = {Ren\'{e} Ranftl and Alexey Bochkovskiy and Vladlen Koltun},
	title     = {Vision Transformers for Dense Prediction},
	journal   = {ICCV},
	year      = {2021},
}
Скопійовано з блоку цитування авторів на сторінці github.com/isl-org/MiDaS#citation.