DINOv2
DINOv2 是 Meta AI 训练的自监督 vision transformer,不用标注就能产出通用的图像特征。LibreYOLO 把它的 DINOv2-with-Registers 骨干封装成三个任务:语义分割、分类和整图嵌入。
- 任务
- semantic segmentation, classification, embeddings
- 尺寸
- n, s, m, l at 518 px
- 安装
pip install "libreyolo[rfdetr]"- 支持层级
- 已支持,自 v1.3.0 起。起支撑作用的可训练家族:在 CI 里保持绿色,功能视情况落地。
- 许可
- 代码采用 MIT,权重采用 Apache-2.0。商用
安装
LibreDINOv2 只在装了 transformers 之后才会注册,也就是 RF-DETR 给它的 DINOv2
骨干所需要的那个可选依赖,所以它用的是同一个 extra。
pip install "libreyolo[rfdetr]"预测
LibreYOLO 没有发布 LibreDINOv2 检查点(checkpoint)。不要去加载文件,直接构造这个
封装:model_path=None(默认值)会在首次使用时从 Hugging Face 下载 Meta 采用
Apache-2.0 许可的 facebook/dinov2-with-registers-small 骨干。task= 选择在它之上
跑什么。
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # 这个家族没有 LibreYOLO 托管的检查点:这里会从 Meta 的 Hugging Face# 组织下载采用 Apache-2.0 许可的 DINOv2-with-Registers-small 骨干。# 稠密 head 在你训练它之前一直是随机初始化的(见下面的训练一节)model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= 是你数据集的类别数;线性 head 在你训练它之前一直是# 随机初始化的model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # 绕过所有任务 head:光靠骨干就够了,所以不用微调就能用model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D),已做 L2 归一化from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # 便捷封装:内部跑一次 predict(),把每一行堆叠成一个 (N, D) 张量features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" 和 task="classify" 会在骨干之上加一个稠密 head 或线性 head;
这个 head 是随机初始化的,只有在你训练它之后才有用(见训练)。
task="embed" 跳过所有 head,把骨干最后归一化的 CLS token 作为整图的一行返回到
result.embeddings 里,所以它完全不需要训练。result.boxes 永远是 None:这三个
任务都不产生逐实例的检测结果。数据源、流式处理和结果处理见预测。
变体
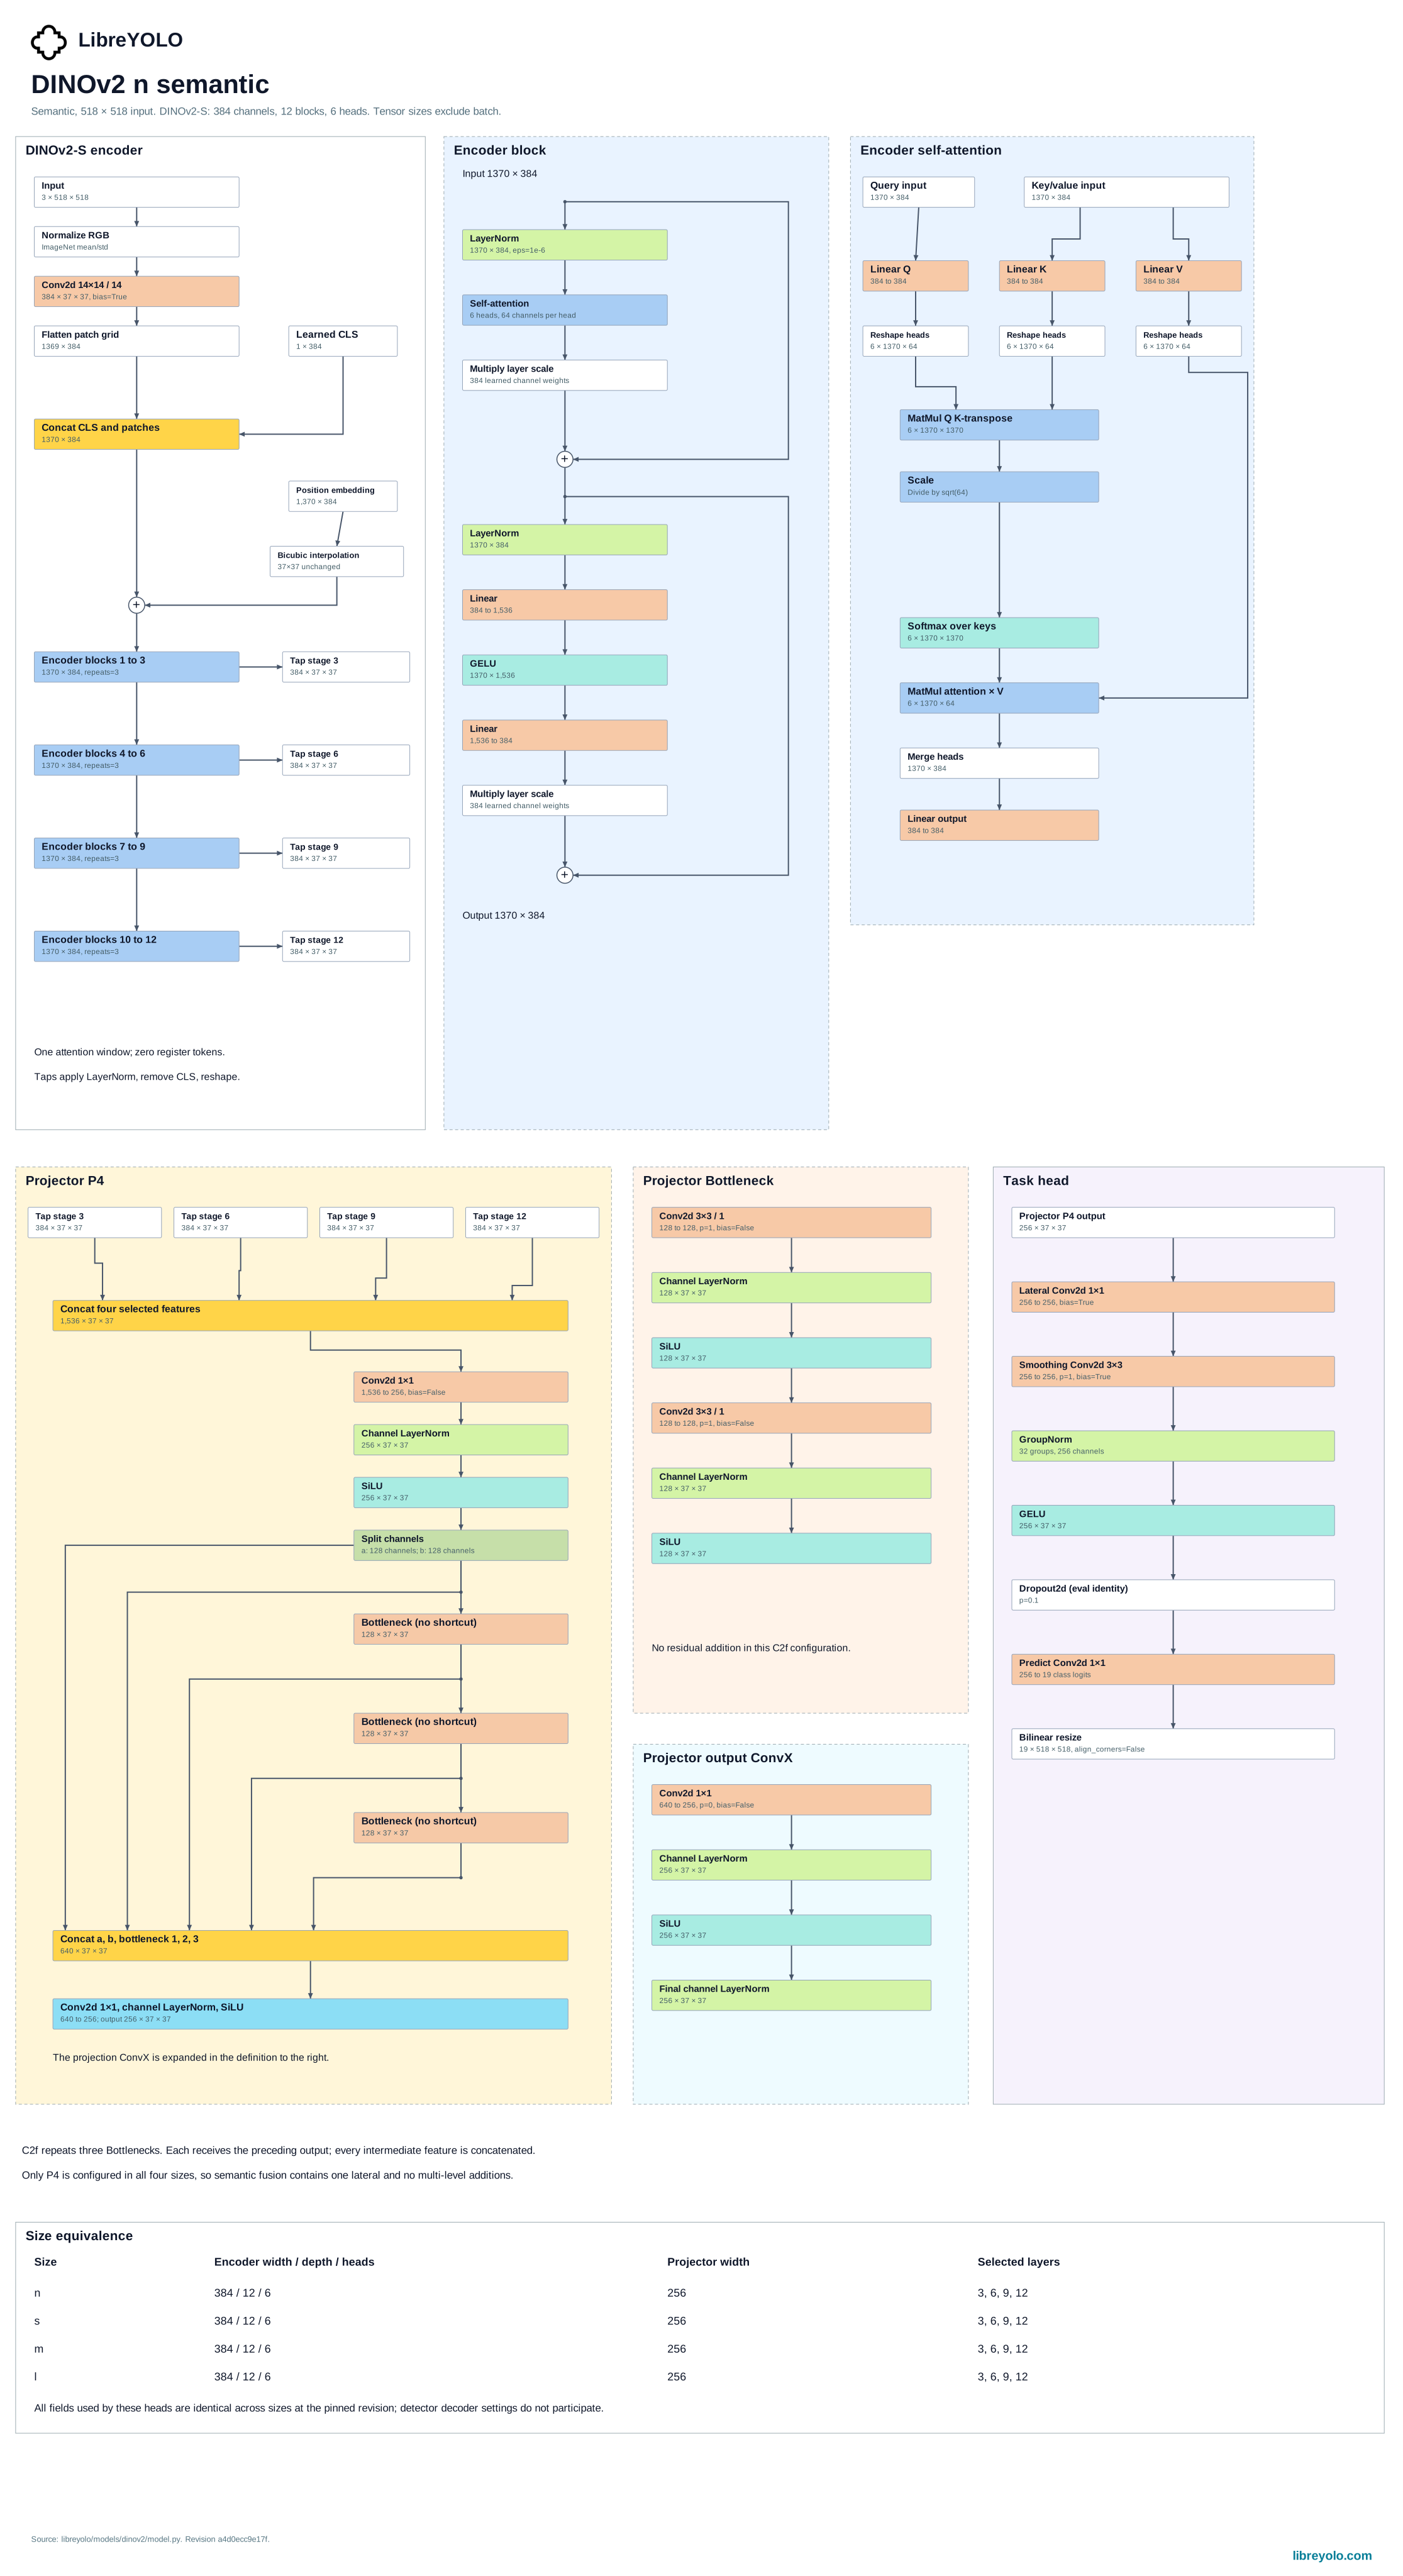
size 选的是叠在骨干之上的、RF-DETR 风格的投影层宽度,而不是骨干本身:每种尺寸共用
同一个 DINOv2-S(small)编码器。语义分割跑在 DINOv2 原生的方形 patch 网格上;分类和
嵌入跑在训练线性探针时用的那个更小的分类分辨率上。
训练
task="semantic" 和 task="classify" 都能训练;task="embed" 没有依赖类别的 head
要拟合,你在它上面调用 train() 会抛出 NotImplementedError。
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)这里的主要关键字参数是 batch_size 和 lr,而不是大多数其他家族使用的 batch 和 lr0;后两者仍然接受并映射到前两者,但同时传入会引发冲突错误。output_dir=(默认 None)取代 project=/name=,成为指定训练目录的主要方式,不过直接传入 project=/name= 仍然有效。数据集、数据增强、多卡训练和日志记录器见训练。
新训练使用自动递增的 runs/train/dinov2_exp,并设置 exist_ok=False。resume=True 恢复训练器状态,并保留所选训练目录。分类支持 cls_pw 和 class_weights,详见超参数。
验证
val() 返回一个由 metrics/ 开头的键组成的字典:task="semantic" 是 mIoU 和像素
精度,task="classify" 是 top-1 和 top-5 精度。task="embed" 没有可供打分的真值
(ground truth),你在它上面调用 val() 会抛出 NotImplementedError。
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])分类和嵌入向量校准复用模型的分类流水线。评估使用家族对应的变换。
导出
| 任务 | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX:支持 | Semantic segmentation to TorchScript:支持 | Semantic segmentation to ExecuTorch:支持 | Semantic segmentation to TensorRT:支持 | Semantic segmentation to OpenVINO:支持 | Semantic segmentation to Paddle:不支持 | Semantic segmentation to MNN:不支持 | Semantic segmentation to RKNN:不支持 | Semantic segmentation to ncnn:不支持 | Semantic segmentation to TFLite:不支持 | Semantic segmentation to CoreML:不支持 | Semantic segmentation to Core AI:不支持 |
| Classification | Classification to ONNX:支持 | Classification to TorchScript:支持 | Classification to ExecuTorch:支持 | Classification to TensorRT:支持 | Classification to OpenVINO:支持 | Classification to Paddle:不支持 | Classification to MNN:不支持 | Classification to RKNN:不支持 | Classification to ncnn:不支持 | Classification to TFLite:不支持 | Classification to CoreML:不支持 | Classification to Core AI:支持 |
| Embeddings | Embeddings to ONNX:支持 | Embeddings to TorchScript:支持 | Embeddings to ExecuTorch:支持 | Embeddings to TensorRT:支持 | Embeddings to OpenVINO:支持 | Embeddings to Paddle:不支持 | Embeddings to MNN:不支持 | Embeddings to RKNN:不支持 | Embeddings to ncnn:不支持 | Embeddings to TFLite:支持 | Embeddings to CoreML:不支持 | Embeddings to Core AI:不支持 |
每个任务支持的格式子集不同,如上所示。导出的产物按文件后缀通过 LibreYOLO() 加载
回来,所以一个 .onnx 或 .engine 文件的表现和检查点一样,返回同样的 Results。
导出列出了每种格式接受的参数。
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # 工厂按文件后缀分发,所以导出的产物加载方式和任何检查点一样,返回的# 也是同一个 Results 对象。导出时文件名由任务决定,这里是# LibreDINOv2s-sem.onnxmodel = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)许可证
请检查你所下载的具体权重在 Hugging Face 仓库中的许可。LibreYOLO 组织里的每个检查点都附有许可,同一家族内也不一定相同。该仓库是权威来源;以下摘要说明本页上次验证时适用的情况。
这里只说明涉及的许可证,不构成法律意见。如果答案对商用很重要,请自行阅读许可证并咨询法律顾问。
- 原始工作
- DINOv2, Meta AI (FAIR)
- 上游许可
- Apache-2.0
- LibreYOLO 代码
- MIT
- 权重
- 采用 Apache-2.0 许可,由作者分发。LibreYOLO 不托管或镜像这些权重。
- 解读
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
上面「权重」那一行写的是适用的许可证,Apache-2.0,但这个家族其实没有任何东西以
LibreYOLO 的 Hugging Face 组织名义重新发布:LibreYOLO 自己并不托管 LibreDINOv2 检查
点。LibreDINOv2(model_path=None) 下载的是 Meta 自己的
facebook/dinov2-with-registers-small 仓库,原封不动。
引用
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
复制自作者在 github.com/facebookresearch/dinov2#citing-dinov2 上提供的引用块。