DINOv2
DINOv2 — self-supervised vision transformer, который в Meta AI обучили без разметки, чтобы получать универсальные признаки изображений. LibreYOLO оборачивает его бэкбон DINOv2-with-Registers для трёх задач: семантической сегментации, классификации и эмбеддинга всего изображения.
- Задачи
- semantic segmentation, classification, embeddings
- Размеры
- n, s, m, l at 518 px
- Установка
pip install "libreyolo[rfdetr]"- Уровень поддержки
- Поддерживаемый, начиная с v1.3.0. Дополнительные обучаемые модели: тесты CI поддерживаются в рабочем состоянии, а функции добавляются по возможности.
- Исходный проект
- DINOv2 от Meta AI (FAIR), Apache-2.0. Статья, исходный код
- Лицензии
- Код: MIT, веса: Apache-2.0. Коммерческое использование
Установка
LibreDINOv2 регистрируется, только когда установлен transformers — та же
необязательная зависимость, которая нужна RF-DETR для его бэкбона DINOv2,
поэтому нужен тот же extra.
pip install "libreyolo[rfdetr]"Предсказание
LibreYOLO не публикует чекпойнт LibreDINOv2. Вместо загрузки файла создайте
обёртку напрямую: с model_path=None (значение по умолчанию) при первом
запуске с Hugging Face скачивается бэкбон Meta
facebook/dinov2-with-registers-small под Apache-2.0. Аргумент task=
выбирает, что работает поверх него.
from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # В этом семействе нет чекпойнта, размещённого LibreYOLO: здесь# скачивается бэкбон DINOv2-with-Registers-small под Apache-2.0 из# Hugging Face-организации Meta. Плотная голова инициализируется# случайно, пока её не обучить (см. «Обучение» ниже).model = LibreDINOv2(size="s", task="semantic", nb_classes=19)result = model(SAMPLE_IMAGE) mask = result.semantic_maskprint(mask.data.shape, mask.classes)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # nb_classes= — число классов вашего датасета; линейная голова# инициализируется случайно, пока её не обучить.model = LibreDINOv2(size="s", task="classify", nb_classes=10)result = model(SAMPLE_IMAGE) print(result.probs.top1, result.probs.top1conf)from libreyolo import SAMPLE_IMAGEfrom libreyolo.models.dinov2.model import LibreDINOv2 # Обходит все головы задач: достаточно одного бэкбона, поэтому# никакого дообучения здесь не нужно.model = LibreDINOv2(size="s", task="embed")result = model(SAMPLE_IMAGE) print(result.embeddings.data.shape) # (1, D), L2-нормированныеfrom libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed") # Удобная обёртка: вызывает predict() и складывает все строки в один# тензор (N, D).features = model.embed(["a.jpg", "b.jpg", "c.jpg"])print(features.shape)task="semantic" и task="classify" добавляют поверх бэкбона плотную или
линейную голову; эта голова инициализируется случайно и становится полезной
только после обучения (см. Обучение). task="embed" пропускает все
головы и возвращает финальный нормированный CLS-токен бэкбона как одну строку
на всё изображение в result.embeddings, поэтому обучение ему вообще не
нужно. result.boxes всегда None: ни одна из трёх задач не выдаёт детекции
по экземплярам. Про источники, стриминг и обработку результатов —
предсказание.
Варианты
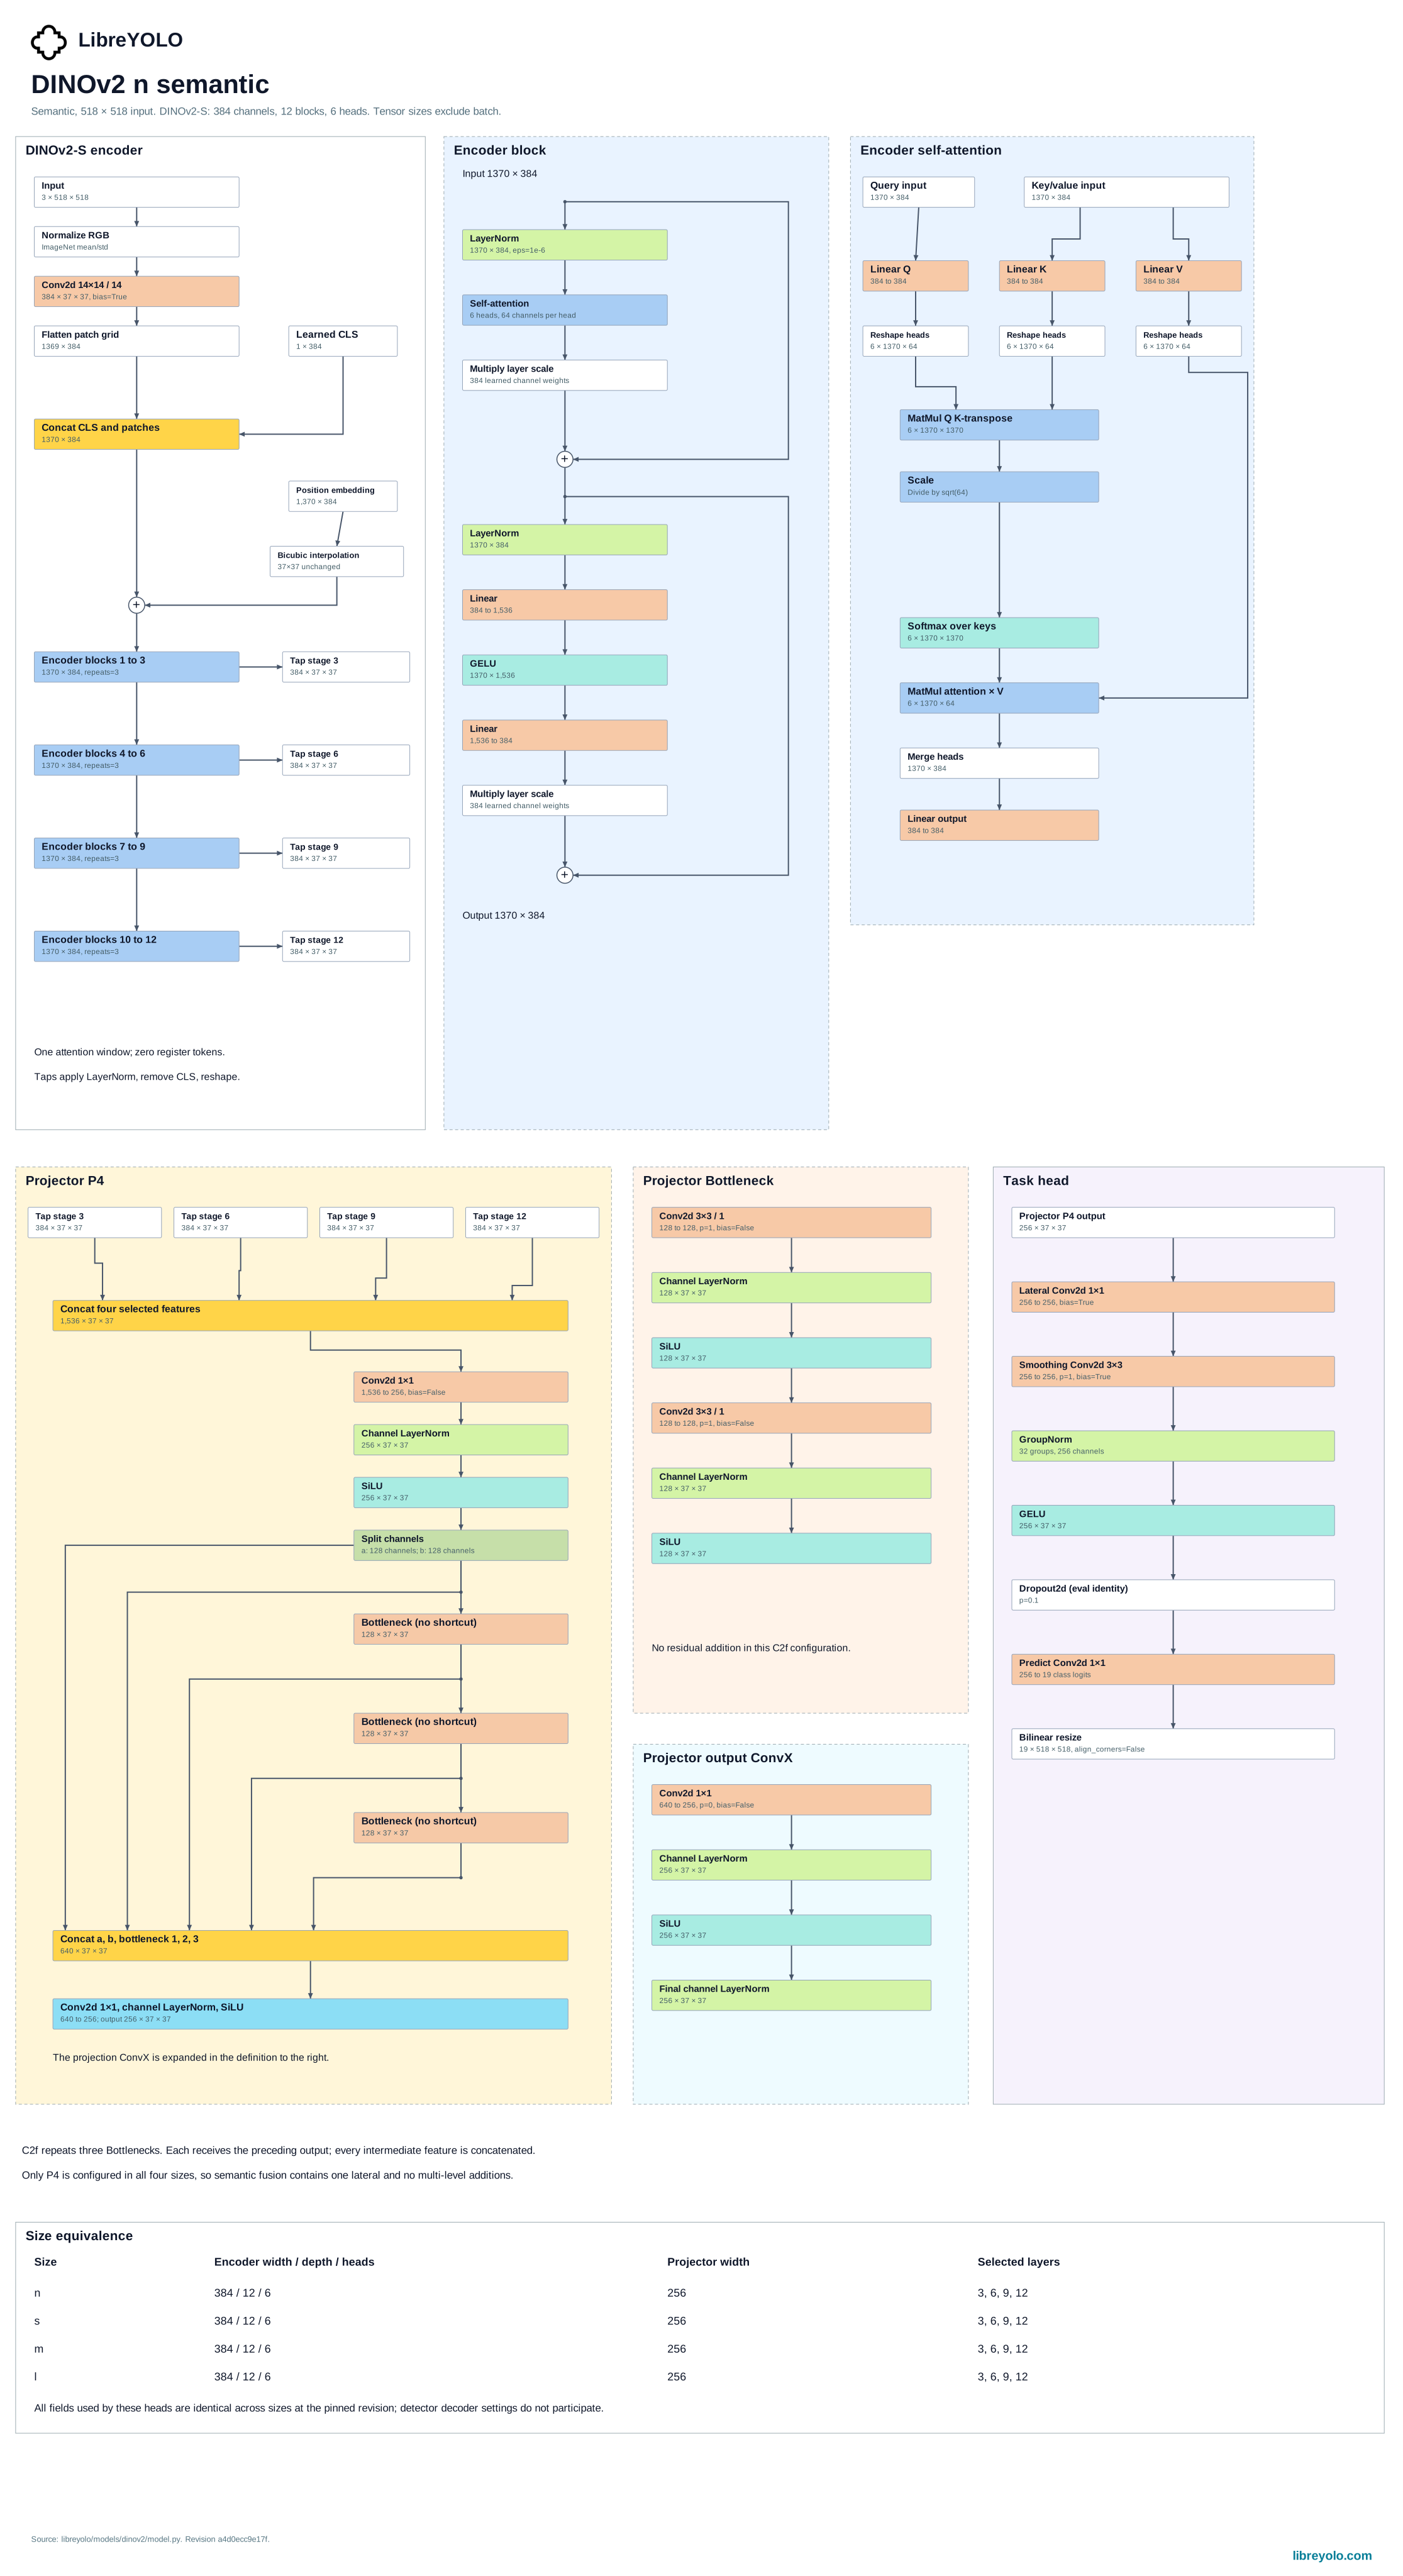
size выбирает ширину проектора в стиле RF-DETR, надстроенного над бэкбоном,
а не сам бэкбон: у всех размеров один и тот же энкодер DINOv2-S (small).
Семантическая сегментация работает на родной квадратной сетке патчей DINOv2;
классификация и эмбеддинг — на меньшем разрешении классификации, на котором
обучали linear probe.
Обучение
task="semantic" и task="classify" обучаются оба; у task="embed" нет
зависящей от классов головы, которую нужно подгонять, и train() для него
вызывает NotImplementedError.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.train(data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4)from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.train( data="my-dataset.yaml", epochs=100, batch_size=4, lr=1e-4, device="0,1",)Основные именованные аргументы здесь — batch_size и lr, а не batch и
lr0, которые используют большинство других семейств; batch и lr0
по-прежнему принимаются и отображаются на них, но передача обоих вызывает
ошибку конфликта. output_dir= (по умолчанию None) заменяет
project=/name= как основной способ задать место запуска, хотя передать
project=/name= напрямую по-прежнему можно. Про датасеты, аугментацию,
обучение на нескольких GPU и логгеры — обучение.
Новые запуски используют runs/train/dinov2_exp с увеличиваемым номером и exist_ok=False. resume=True восстанавливает состояние тренера и сохраняет выбранный каталог запуска. Классификация поддерживает cls_pw и class_weights, описанные в разделе гиперпараметров.
Валидация
val() возвращает словарь с ключами metrics/: mIoU и попиксельную accuracy
для task="semantic", top-1 и top-5 accuracy для task="classify". У
task="embed" нет эталонной разметки (ground truth), с которой можно
сравнивать, и val() для него вызывает NotImplementedError.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/mIoU"])print(metrics["metrics/pixel_accuracy"])from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)metrics = model.val(data="my-dataset.yaml") print(metrics["metrics/accuracy_top1"])print(metrics["metrics/accuracy_top5"])Калибровка классификации и эмбеддингов использует пайплайн классификации модели. Оценка использует преобразование семейства.
Экспорт
| Задача | ONNX | TorchScript | ExecuTorch | TensorRT | OpenVINO | Paddle | MNN | RKNN | ncnn | TFLite | CoreML | Core AI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Semantic segmentation | Semantic segmentation to ONNX: поддерживается | Semantic segmentation to TorchScript: поддерживается | Semantic segmentation to ExecuTorch: поддерживается | Semantic segmentation to TensorRT: поддерживается | Semantic segmentation to OpenVINO: поддерживается | Semantic segmentation to Paddle: не поддерживается | Semantic segmentation to MNN: не поддерживается | Semantic segmentation to RKNN: не поддерживается | Semantic segmentation to ncnn: не поддерживается | Semantic segmentation to TFLite: не поддерживается | Semantic segmentation to CoreML: не поддерживается | Semantic segmentation to Core AI: не поддерживается |
| Classification | Classification to ONNX: поддерживается | Classification to TorchScript: поддерживается | Classification to ExecuTorch: поддерживается | Classification to TensorRT: поддерживается | Classification to OpenVINO: поддерживается | Classification to Paddle: не поддерживается | Classification to MNN: не поддерживается | Classification to RKNN: не поддерживается | Classification to ncnn: не поддерживается | Classification to TFLite: не поддерживается | Classification to CoreML: не поддерживается | Classification to Core AI: поддерживается |
| Embeddings | Embeddings to ONNX: поддерживается | Embeddings to TorchScript: поддерживается | Embeddings to ExecuTorch: поддерживается | Embeddings to TensorRT: поддерживается | Embeddings to OpenVINO: поддерживается | Embeddings to Paddle: не поддерживается | Embeddings to MNN: не поддерживается | Embeddings to RKNN: не поддерживается | Embeddings to ncnn: не поддерживается | Embeddings to TFLite: поддерживается | Embeddings to CoreML: не поддерживается | Embeddings to Core AI: не поддерживается |
Каждая задача поддерживает свой набор форматов, показанный выше.
Экспортированный артефакт загружается обратно через LibreYOLO() по суффиксу
файла, поэтому файл .onnx или .engine ведёт себя как чекпойнт и возвращает
те же Results. В разделе экспорт перечислены аргументы,
которые принимает каждый формат.
from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="semantic", nb_classes=19)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="classify", nb_classes=10)model.export(format="onnx")from libreyolo.models.dinov2.model import LibreDINOv2 model = LibreDINOv2(size="s", task="embed")model.export(format="tflite")from libreyolo import LibreYOLO, SAMPLE_IMAGE # Фабрика выбирает загрузчик по суффиксу файла, поэтому экспортированный# артефакт загружается как обычный чекпойнт и возвращает тот же объект# Results. Имя файла экспорт берёт из задачи, здесь — LibreDINOv2s-sem.onnx.model = LibreYOLO("LibreDINOv2s-sem.onnx")result = model(SAMPLE_IMAGE)Лицензирование
Проверяйте лицензию в репозитории конкретных весов на Hugging Face. Она указана для каждого чекпойнта в организации LibreYOLO и может различаться даже внутри одного семейства. Этот репозиторий считается авторитетным источником, а сводка ниже описывает условия на момент последней проверки страницы.
Это описание соответствующих лицензий, а не юридическая консультация. Если ответ важен для коммерческого использования, прочитайте лицензии самостоятельно и проконсультируйтесь с юристом.
- Оригинальная работа
- DINOv2, Meta AI (FAIR)
- Лицензия исходного проекта
- Apache-2.0
- Исходный код проекта
- github.com/facebookresearch/dinov2
- Код LibreYOLO
- MIT
- Веса
- Apache-2.0, распространяются авторами. LibreYOLO не размещает и не зеркалирует их.
- Толкование
- Apache-2.0 is a permissive license, so these weights can be used in commercial and closed-source products. It asks you to keep its license text and attribution notices with any copy of the weights you redistribute, and it grants a patent license. LibreYOLO does not host or republish a DINOv2 checkpoint of its own: LibreDINOv2 downloads the pretrained backbone directly from Meta's facebook/dinov2-with-registers-small repository on Hugging Face the first time it runs, unmodified. The semantic and classification heads start at random initialization until you train them, since LibreYOLO does not publish a trained head for this family.
Строка «Weights» выше называет лицензию, которая здесь действует, —
Apache-2.0, но для этого семейства в Hugging Face-организации LibreYOLO на
самом деле ничего не переопубликовано: собственного чекпойнта LibreDINOv2 у
LibreYOLO нет. LibreDINOv2(model_path=None) скачивает репозиторий
facebook/dinov2-with-registers-small самой Meta, без изменений.
Цитирование
@misc{oquab2023dinov2,
  title={DINOv2: Learning Robust Visual Features without Supervision},
  author={Oquab, Maxime and Darcet, Timothée and Moutakanni, Theo and Vo, Huy V. and Szafraniec, Marc and Khalidov, Vasil and Fernandez, Pierre and Haziza, Daniel and Massa, Francisco and El-Nouby, Alaaeldin and Howes, Russell and Huang, Po-Yao and Xu, Hu and Sharma, Vasu and Li, Shang-Wen and Galuba, Wojciech and Rabbat, Mike and Assran, Mido and Ballas, Nicolas and Synnaeve, Gabriel and Misra, Ishan and Jegou, Herve and Mairal, Julien and Labatut, Patrick and Joulin, Armand and Bojanowski, Piotr},
  journal={arXiv:2304.07193},
  year={2023}
}
Скопировано из блока цитирования авторов на странице github.com/facebookresearch/dinov2#citing-dinov2.